

导读:卓驭是一家聚焦移动物理 AI 的科技公司,为乘用车和商用车提供辅助驾驶解决方案,并探索将智能能力应用于更多移动场景。随着原生多模态基础模型的发展,文本、图像、音频、点云等数据需要在同一套体系中组织、管理和使用。面对这一挑战,卓驭构建了多模态湖仓 ZLake,基于阿里云 DLF(数据湖构建)、 EMR Serverless Spark、EMR Serverless StarRocks、PAI 打造了 ZLake 的核心组件 ZLake Store、Meta Lake,并通过“一湖两域”连接智驾数据与企业运营数据。本文将介绍这套数据底座的设计思路,以及智能体参与数据生产和模型迭代的实践。

卓驭的原生多模态基础模型面向移动物理 AI 场景。在预训练阶段,模型对文本、语音、动作等不同模态的数据进行联合训练,并在统一的表征空间中完成对齐。与先完成语义理解、再进行物理推理的分阶段方式相比,这种模型形态具有更大的能力拓展空间,也对底层基础架构提出了更高要求:不同模态的数据需要以统一的方式组织和处理。
这一挑战与智驾算法的演进密切相关。过去几年,AI 技术逐步从感知 AI、生成式 AI、智能体走向物理 AI;智驾算法也从模块化感知,发展到 BEV、端到端、VLA,以及原生多模态基础模型。随着算法迭代,算力与数据需求持续增长。按照演讲中展示的数据,每一代算法对算力和数据的需求约为上一代的 5~10 倍。
需求增长给基础架构带来的难题,是如何同时兼顾弹性、成本、稳定性与性能。这几个目标相互牵制,需要在具体架构设计中不断权衡。接下来,我们将结合实际场景,介绍面临的挑战与相应思考。

这些目标之间的权衡,可以借助“帕累托前沿”来理解:当系统处于这一边界时,若要进一步改善某一项指标,往往需要在其他指标上付出代价。对卓驭而言,当前的挑战主要体现在四个方面。
•计算方面: 模型训练、数据生产和评测任务共享同一资源池。资源调度既要响应不同业务任务的优先级,也要尽可能提高整体利用率。
•存储方面: 大量多模态数据分散在不同平台管理,跨平台的统一检索与数据复用仍有难度。
•治理方面: 企业运营数据与智驾数据采用不同的治理体系,数据相对割裂,统一口径较难建立,也缺少可供机器读取和使用的统一语义层。
•运营方面: 不少流程仍依赖人工推动。模型训练效率和数据生产能力在一定程度上受人员投入及团队规模制约。
因此,基础架构的价值不仅体现在单项能力的提升,更体现在算法发生跨代演进时,能否及时调整资源与数据体系,在弹性、成本、稳定性和性能之间找到适合当前业务需求的平衡点。
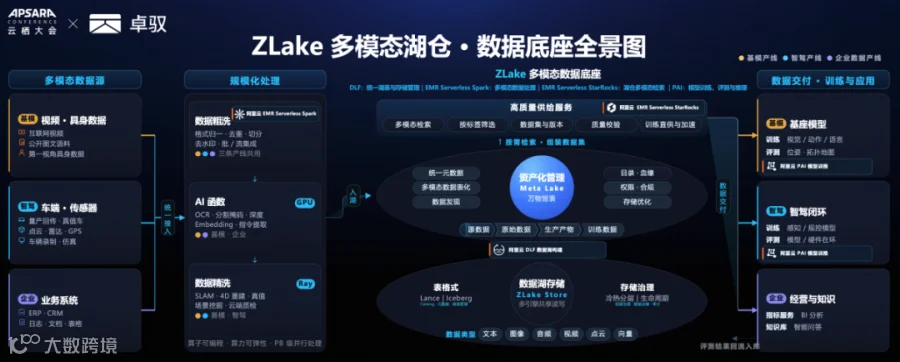
围绕这些挑战,卓驭自研了多模态湖仓 ZLake,作为数据体系的底座。从整体流程看,ZLake 覆盖数据采集与集成、规模化数据处理、数据入库与管理,以及数据交付与使用四个阶段。
从数据流转来看,ZLake 承接三类主要数据产线:移动基础模型数据产线、智驾数据产线和企业数据产线。 各类数据经过粗洗、精洗与挖掘后进入多模态湖仓。湖仓对原始数据、样本数据、处理产物和训练数据进行统一的资产化管理,并在此基础上提供多模态检索、数据集与版本管理、数据质量保障等能力,最终支撑移动基础模型的训练与评测、智驾数据闭环,以及企业经营分析等下游场景。
在技术实现上,全景图中的各层能力由卓驭自研组件与阿里云大数据产品组合支撑:规模化处理阶段,阿里云 EMR Serverless Spark 承担格式归一、去重、切片等数据粗洗任务,基于 GPU 的 AI 函数完成 OCR、分割编码、深度估计与 Embedding 抽取,Ray 集群则负责 SLAM、4D 重建、真值计算等数据精洗;数据入湖后,阿里云 DLF(数据湖构建)提供统一的湖上元数据与存储管理,通过 Lance、Iceberg 等开放表格式实现文本、图像、音频、视频、点云、向量等多模态数据的多引擎共享读写,并配套冷热分层、生命周期等存储治理能力,其上的自研资产管理 Meta Lake 沉淀了统一元数据、数据发现、目录血缘与权限合规等资产化能力;在高质量供给层,阿里云 EMR Serverless StarRocks 承担湖仓多模态统一检索,支撑多模态检索、标签筛选、数据集与版本管理、质量校验及训练直供加速;最终由阿里云 PAI 完成模型训练、评测与推理,支撑基础模型训练、智驾数据闭环和企业经营与知识应用,评测结果回流入湖,形成从数据到智能的完整闭环。
支撑这一链路的核心设计理念是“万物皆表”。文本、图像、音频、点云和向量等不同形态的数据,都可以通过表进行管理、寻址、治理和检索。
以困难样本挖掘为例,筛选过程可能同时涉及向量近似检索、关键词匹配、标量过滤和地理范围圈选。在这一架构下,这些条件可以组合在同一套基于表的查询链路中,无需针对每种数据形态分别建设查询链路。
在“万物皆表”的设计下,业务场景或数据内容扩展时,可以通过扩展表结构纳入新的数据字段,减少为不同数据形态分别建设管理和查询链路的成本,提升数据使用的便利性。不过,多模态湖仓的难点并不只是存储数据,而是能否像管理结构化表一样,对多样的非结构化数据进行统一管理。

ZLake 采用“一湖两域”的统一底座:一域承载数字世界的企业运营数据,另一域承载来自物理世界的智能数据与基础模型数据。两类数据汇入同一个湖,在其上共享表结构、检索、计算和业务认知模型。再向上,数据分析、数据开发和数据运维 Agent 为业务提供智能化支持。贯穿两域的,则是覆盖数据、指标和知识全生命周期的治理体系,使数据在同一底座内流转和复用。
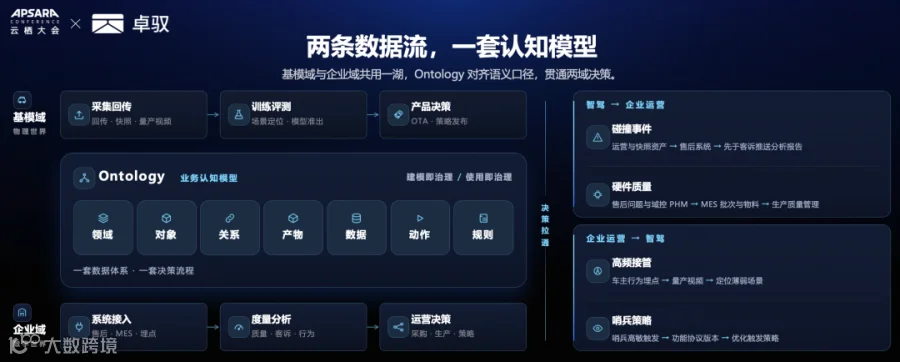
将两类数据存储在同一个湖中,只是统一底座的第一步。更关键的是让它们共享一套语义,这正是业务认知模型 Ontology 的作用。Ontology 对基础模型与智驾领域、企业运营领域中的对象、关系和规则进行统一表达,使不同来源的数据具有可供机器读取、理解和使用的语义定义。
这一设计遵循两个原则:
•建模即治理:在数据建模阶段就明确语义定义,而不是等数据进入下游应用后再进行对齐。
•使用即治理。语义模型会在实际使用中持续完善:每次查询或调用,都可以帮助发现定义不清、关联不准确等问题,并据此修正模型。
有了共同的语义,智驾领域与企业运营领域的数据也能够相互关联。以车端异常事件为例,事件发生后,相关快照数据可以进入售后系统,用于生成分析报告;沿着事件与车辆、生产批次及物料之间的关联,还可以进一步追溯潜在的质量问题,为生产与质量管理提供依据。
反过来,企业运营领域的数据也可以服务于智驾模型的迭代。例如,在道路测试过程中,测试员的部分驾驶操作可能比当前模型的表现更加稳健。通过 Ontology 关联测试任务、驾驶行为与相关场景数据,可以从中筛选和组织高质量样本,形成供模型训练使用的数据集,支持模型持续迭代。
因此,Ontology 的价值在于将跨领域的数据关联沉淀为可查询、可复用的关系,也为后续基于业务知识的智能化应用提供语义基础。

过去十余年,基础架构演进大致可以分为两个阶段。
1.第一阶段以平台建设为主。为了满足不断增长的业务需求,团队陆续建设了数据采集、标注、训练和质量管理等平台。支撑这些平台的底层架构,也逐步从传统大数据架构,演进为以对象存储和 Kubernetes 为代表的云原生架构。
2.第二阶段是数据闭环。 这一阶段以数据驱动为核心,将此前建设的平台串联起来,形成数据生产、模型训练与推理、模型评测等产线。随着产线持续运行,团队也开始分析各环节的成本与效能,寻找优化空间。
前两个阶段有一个共同点:平台和产线主要面向人使用。平台提供操作界面,产线按照既定流程运行,关键环节仍需要人来驱动。
今年以来,我们开始探索第三阶段:AI² Infra(AI-Native Infra)。它可以理解为“AI for AI Infra”:基础设施服务于 AI,其运行流程也逐步由 AI 参与驱动。该阶段主要有两个特点:
1.能力工具化。基础架构不再只通过平台界面提供能力,也会将能力封装为智能体可调用的工具,让智能体能够参与数据与模型相关的工作流程。
2.基础设施融入业务流程。随着业务流程逐步从人工操作和固定的自动化规则,转向由智能体参与驱动,基础设施的角色也随之变化:它不仅提供计算、存储等资源,还需要在流程运行过程中提供数据、工具和治理能力。
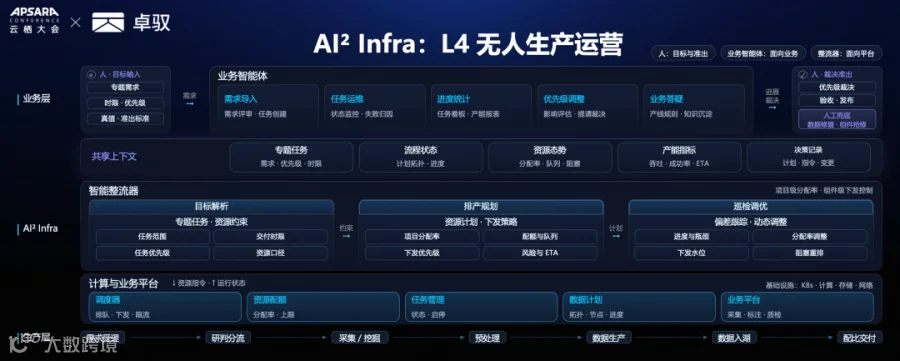
第一个场景是数据生产的自主化运营。我们借用自动驾驶从 L1 到 L4 的分级方式,描述数据生产流程由人工驱动逐步走向智能体驱动的过程。这里的 L4 指目标状态:智能体能够承担大部分流程编排与运行调整,人在关键目标和边界条件上进行设定与监督。
这一架构分为三层。最上层是人,负责定义目标,包括各类专题的数据需求、交付时限、任务优先级和准出标准。中间层是业务智能体,负责业务侧的运营与协调:接收需求、跟踪生产进度,并在发现任务延迟时调整优先级。底层是面向平台的智能调度组件,负责将业务需求转化为可执行的资源计划,包括排产、资源配额、任务队列和执行优先级,并在运行过程中巡检、调优和处理偏差。
两层智能体共享同一套上下文,将业务场景、任务编排和资源状态关联起来,形成机器可理解的描述。基于这些信息,智能体可以在既定目标和约束下协调数据生产,在产量、效率、质量与资源利用率之间持续调整。
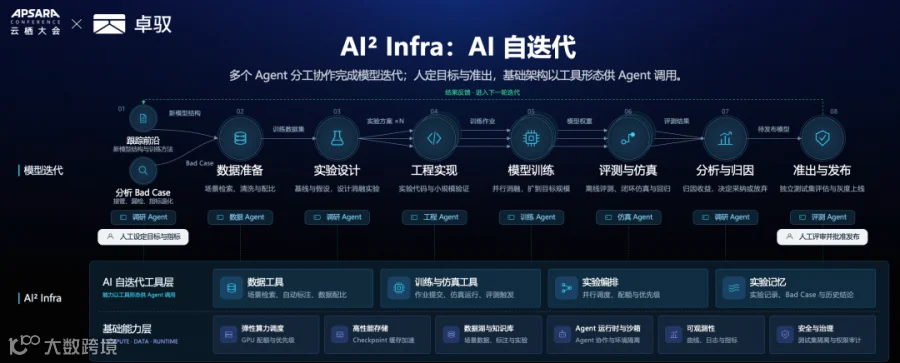
第二个场景是由智能体参与模型探索与迭代。智能体可以持续跟踪相关研究,关注网络结构、模型设计和训练方法的新进展;同时归类近期的失败案例,识别模型表现不足的场景。结合研究进展与实际问题,智能体提出改进假设,再从湖仓中筛选数据、组织训练数据集,申请算力并编排实验。
实验完成后,智能体对结果进行分析和归因:有效的方案进入下一轮验证;效果不及预期的方案则记录原因、调整方向,继续探索。在这一过程中,人主要负责设定目标,并把控模型发布和准出标准。
为支撑这样的流程,基础架构需要将数据获取、训练与仿真、实验编排等能力作为工具提供给智能体。模型迭代的速度,也将越来越取决于数据供给、算力调度和实验执行的效率。
AI² Infra 并不是基础设施演进的终点。 随着自动驾驶、智能制造和人形机器人等场景的发展,数据、算力与平台的形态还会继续变化。但一个方向已经逐渐清晰:基础架构正从提供资源、支撑业务,走向直接参与由智能体驱动的业务流程。
/ END /

点击“阅读原文”快速体验更多关于大数据&AI产品解决方案