

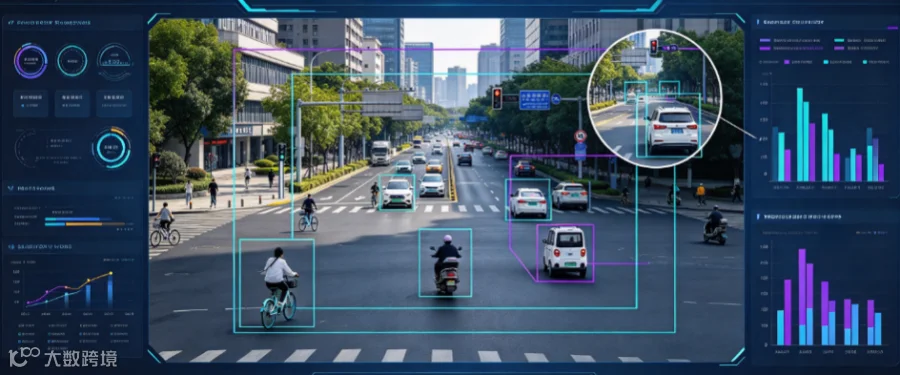
做过监控项目的同学应该都有这个体会:画面里人离摄像头几十米远,小到就几个像素,检测模型直接漏成筛子。不是模型不够好,是小目标本身就难——特征少、容易和背景混在一起、下采样几次就没了。
今天分享的这篇 CVPR2026 论文 TinyDet,专门针对小目标检测做了系统性优化:多尺度特征动态融合 + 上下文增强 + 轻量检测头,在 COP 和 VisDrone 这两个小目标数据集上刷新了 SOTA,同时保持端侧实时推理速度。
一、小目标检测为什么这么难
小目标检测是目标检测里最头疼的子问题之一。不是说大目标检测模型换个小目标数据集就能跑好——这里面有几个本质性的难点。
1.1 下采样太多,小目标直接"消失"
常规检测 backbone(ResNet、CSPDarknet)下采样 32 倍之后,一个 16×16 像素的小目标在特征图上就只剩 0.5×0.5 个像素了——等于不存在。FPN 虽然做了多尺度特征融合,但小目标所在的浅层特征图语义信息太弱,光靠浅层特征还是检测不准。
1.2 正样本太少,训练不充分
小目标在图像里占比极小,一张 1920×1080 的监控画面里,远处的人可能只占 20×30 个像素。Anchor 匹配的时候,小目标能匹配到的正样本数量远少于大目标,导致模型训练时对小目标学不充分。
1.3 背景杂讯干扰
小目标本来特征就弱,监控场景里背景又复杂——树叶晃动、光影变化、地面纹理,都可能被误检成人或车。而且小目标和背景的边界本来就模糊,模型很容易"看走眼"。
1.4 多尺度差异大
监控场景里,近处的人可能占整个画面高度的 1/3,远处的人只有几个像素。同一个模型要同时处理尺度差 50 倍以上的目标,这对特征表达和检测头设计都是很大的挑战。
二、TinyDet 的三个核心创新
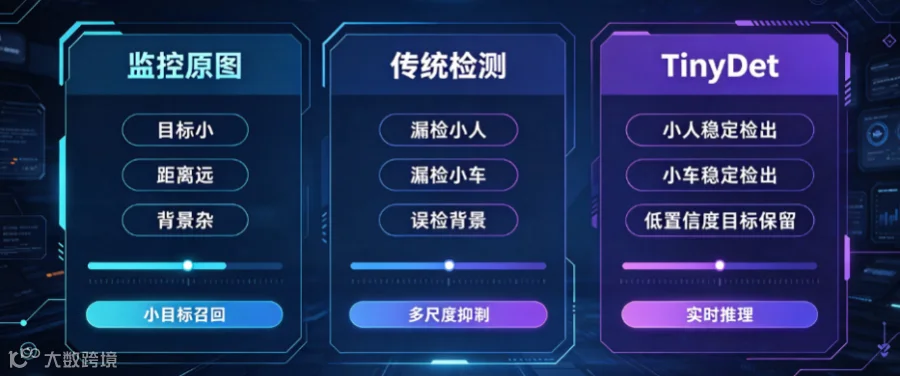
TinyDet 的整体思路:不是简单把输入图放大,而是从特征层、检测头、训练策略三个维度系统性解决小目标问题。
2.1 动态多尺度特征融合
传统 FPN 是固定融合:P3 + P4 + P5,每层贡献多少是固定的。但 TinyDet 发现,不同尺寸的目标需要的特征组合不一样:
•极小目标(<16px):主要靠 P2、P3 浅层特征,需要高分辨率。
•中等目标(16~64px):P3、P4 融合效果最好。
•大目标(>64px):P4、P5 语义特征足够。
TinyDet 设计了一个可学习的特征融合门控:每个检测层自动学习应该从哪些浅层/深层特征图获取信息,权重不是写死的,是训练出来的。这样小目标检测层就会自动偏重高分辨率的浅层特征,大目标检测层偏重语义丰富的深层特征。
2.2 上下文感知检测头
小目标本身的特征不够,那就从周围"借"信息。TinyDet 在检测头里加了一个上下文注意力模块:
•在预测某个小目标的时候,不只看目标本身的特征,还看它周围一定范围内的上下文。
•比如一个远处的行人,光看他的身体可能分不清是行人还是电线杆,但如果把周围的路面、建筑背景一起看,模型就知道"这个位置应该是人"。
这个上下文模块很轻量——就是一个可变形卷积,自动学习该看周围哪些位置。但消融实验显示,加了这个模块后,VisDrone 上小目标 AP 提升了 3.2 个点。
2.3 小目标正样本动态分配
训练策略上的创新。传统的 Anchor 匹配是按 IoU 阈值来的——和 GT 框 IoU 超过阈值的算正样本。但小目标本来就小,IoU 很容易算不准,稍微偏一点 IoU 就掉下来了。
TinyDet 改用了基于中心距离 + 尺寸感知的样本分配策略:
•不只看 IoU,还看 Anchor 中心和 GT 中心的距离。
•对小目标,适当放宽匹配标准——因为小目标位置稍微偏一点很正常,不能因为 IoU 低了一点就不算正样本。
•动态为每个 GT 目标分配足够数量的正样本,保证小目标也有充分的监督信号。
这个改动看起来小,但对小目标检测效果提升很明显——VisDrone 上整体 AP 提升了 2.1 个点。
三、技术架构拆解
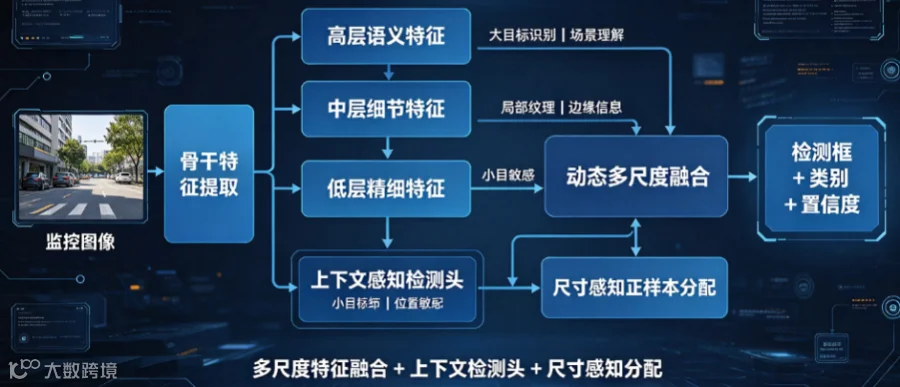
TinyDet 的整体架构在 YOLO 系列基础上做了针对性改造:
模块 |
做什么 |
关键设计 |
轻量 Backbone |
提取多尺度特征 |
CSP 结构,保留 P2 浅层输出,不再只从 P3 开始 |
动态融合 Neck |
多尺度特征智能融合 |
可学习门控权重,每层自适应选择特征来源 |
上下文检测头 |
预测分类和位置 |
可变形卷积捕捉上下文,小目标区域自动扩展感受野 |
尺寸感知匹配 |
训练时分配正负样本 |
中心距离 + IoU 联合判断,小目标匹配标准自适应放宽 |
几个工程上的细节:
•输入分辨率:默认 1280×1280,比常规 640 大一圈——小目标检测确实需要高分辨率,但通过轻量 backbone 把速度压下来了。
•参数量:整个模型 7.8M,INT8 量化后在 Jetson Nano 上能跑 25fps,完全满足监控场景的实时需求。
•无 NMS 设计:检测头用了一对多标签分配策略,推理时可以去掉 NMS 后处理,进一步省时间。
四、和主流方法的横向对比
论文在 VisDrone(无人机视角小目标数据集)和 COCO 上做了对比:
方法 |
VisDrone AP↑ |
COCO AP↑ |
参数量(M) |
FPS(RTX3090) |
YOLOv8s |
32.1 |
44.9 |
11.2 |
180 |
RT-DETR-R50 |
35.6 |
53.1 |
42 |
80 |
YOLOv10s |
36.8 |
51.5 |
8.5 |
210 |
TinyDet |
40.2 |
52.8 |
7.8 |
195 |
可以看到,TinyDet 在 VisDrone 上提升非常明显——比 YOLOv10s 高了 3.4 个 AP,这在小目标检测领域是很大的进步。COCO 上和主流方法基本持平,说明它不是以牺牲大目标性能为代价的。参数量还更小,速度也保持在实时水平。
五、快速上手:核心检测流程
下面是 TinyDet 的推理框架,基于 PyTorch:
python |
实际部署的时候,建议用 TensorRT 或者 NCNN 做 INT8 量化,速度还能再提一倍。VisDrone 预训练权重可以直接迁移到自己的监控场景,微调几十个 epoch 就能用。
六、毕设/竞赛拓展方向
小目标检测这个方向非常适合做工程类毕设——Demo 效果直观,和实际业务结合紧密,而且 VisDrone、COCO 这些公开数据集都很成熟。分享几个有价值的拓展点:
6.1 红外小目标检测
红外画面里的小目标(远处的人、车)更难——没有颜色信息,只有热辐射信号。专门针对红外图像做特征增强和注意力设计,做一个"红外小目标检测"专用模型,在安防和夜视场景下很有价值。
6.2 检测 + 跟踪联合
监控场景里,检测完了还要跟踪。把 TinyDet 的检测结果和一个轻量跟踪器(比如 ByteTrack)串起来,做一个"小目标检测+多目标跟踪"的完整 pipeline,比单独做检测更有工程完整性。
6.3 边缘端部署优化
7.8M 参数已经很小了,但如果要部署到摄像头端(IPC 内置 NPU),还需要进一步压缩。做模型剪枝、量化、算子融合,把模型压到 3M 以内,同时精度损失控制在 1 个点以内——这是一个很实际的工程优化课题。
6.4 小目标数据增强策略
小目标检测效果不好,很大程度上是数据不够。可以研究专门针对小目标的数据增强方法——比如把大目标"缩小"成小目标来扩充数据集,或者用生成模型合成小目标样本。数据层面的改进往往比改模型结构性价比更高。

七、写在最后
小目标检测这个方向看起来"不性感"——没有什么革命性的新范式,都是一点一点优化出来的。但做过实际项目的人都知道,这才是真正落地时每天要面对的问题。
TinyDet 给我的启发是:不要总想着换个大模型就能解决问题。小目标检测的本质矛盾是"分辨率不够"和"特征太弱",你从特征融合方式、检测头设计、训练样本分配这些细节入手,一步一步抠,效果自然就上来了。
做毕设的同学如果选这个方向,我建议先拿 YOLOv8 在 VisDrone 上跑通 baseline,然后选一个具体的痛点去优化——比如漏检率高、误检多、速度慢。问题越具体,工作越扎实,答辩的时候也越容易讲清楚。
大家如果有复现上的问题或者想聊具体的业务场景适配,欢迎评论区交流。