
大数跨境

先把规则和例外那一层写下来,再谈通用:ChatBI答错的时候,SQL往往执行成功了

先把规则和例外那一层写下来,再谈通用:ChatBI答错的时候,SQL往往执行成功了 AI驱动数字化转型
2026-10-16
4
导读:问题往往落在支持度上:它都能答吗?这个问题问错了地方。真正该问的是另一句,公司里有没有一张纸,上面写着“销售额”到底指什么、例外怎么判、谁改它要经过谁。有那张纸,接什么模型都能用。没有那张纸,换再强的
SQL 跑通之后,答案还是另一件事
同一批模型,两套成绩。基于 o1-preview 的智能体在 Spider 1.0 基准上,把 91.2% 的自然语言问题转成了可执行的正确 SQL,同场的 GPT-4o 是 86.6%。把考卷换成 Spider 2.0,这两个数变成 21.3% 和 10.1%。GPT-4o 那一列跌了八倍半。
中间没有改过一个权重,换掉的是考卷本身。Spider 2.0 用 632 个真实企业工作流里的任务重搭了评测环境,对手是 BigQuery 和 Snowflake 上超过一千列的数据仓库,标准答案常常是一百多行 SQL。Spider 1.0 那种学术库不一样,它的表名写着语义,让人一眼看出订单该从哪里关联。
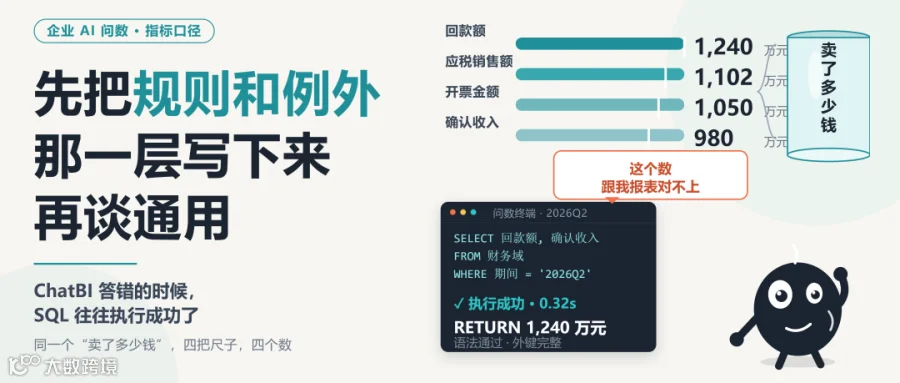
真实环境的难,难在歧义,不在复杂。厂商管这叫通用问数,卖点是任意问题任意问。一家企业的库里,“卖了多少钱”有四把尺子:回款额、确认收入、开票金额、应税销售额。它们分散在不同系统,各有各的用途,各自的负责人年年都认为自己那个才是标准口径。人被问到卖了多少钱时会反问一句“你按哪把尺子”,模型只会挑一把,然后写出一条语法完美的 SQL。
数据库引擎能验语法,能验字段名存不存在,也能验表之间的外键关系。它验不了收入该用开票数还是确认数,验不了同一笔退款该记在收货地还是发货地。至于上季度,它更不知道这家公司按自然季还是按财务核算周期。这三件事,字段里没有,注释里没有,只在人脑子里。
于是出现一类最难被发现的失败。查询顺利跑完,数字正常返回,图表画得挺体面,唯一的问题是,它回答的不是用户当时在问的那件事。
2026 年 8 月,中文技术社区集中冒出一批问数复盘文章,标题高度雷同,都在追同一件事:这条路断在哪一环。把它们放在一起读,失败的样子出奇地一致:问题不出现在 SQL 报错上,而是集中在同一句话上,这个数字跟我报表对不上。

PART 01
悬崖的另一边,同一批模型答对了绝大多数

如果模型是瓶颈,故事到这里就该收尾,企业能做的只有等下一版。2026 年 4 月 dbt Labs 公布的一组对照,堵死了这个解释。同一个模型,同一批问题,一次让它先翻一份事先写好的指标账再回答,一次让它直接写 SQL。前一条路在覆盖范围内的准确率接近百分之百,后一条路是 84.1%。
语义层在这里干的不是让模型变聪明,是把需要猜的部分收走。指标叫什么、怎么算、能按哪些维度切、哪些表之间允许关联,全部事先写死在配置文件里。模型剩下的活从创作 SQL 变成挑选指标,从生成变成检索。
接近百分之百和 84.1% 之间的那道落差,就是这次转换的价格标签。它的代价也一目了然:语义层只能回答被定义过的东西。这些被定义过的东西,在企业内部有个更土的名字,叫口径。
接近百分之百本身是个带条件的数字,条件就是前面那五个字,覆盖范围内。一旦问题跑出这份账,比如要组合两个从没组合过的维度,或者要一个上线才半个月的临时口径,语义层就答不上来。这时系统的表现很明确,要么回答不知道,要么退回通用 SQL。两种表现都比猜一个像样的答案要好。
这也是为什么拿准确率做选型第一指标的时候,必须追问一句:这个准确率是在多大范围上测的。Spider 上那两个数字测的是模型写 SQL 的能力,dbt 那个数字测的是定义过的东西能不能被稳定命中。两者都真实,两者都不是业务判断的正确率。

PART 02
难写的不是口径,是例外

到这里可以回答招标会上最常把人问住的那句话:问数项目到底卡在哪。
卡在一件听起来很土的事情上。口径没写完。

字段对齐
口径这东西,写起来分轻重。最轻的是字段对齐。同一个物料编码,在 MES 里是一套,在 ERP 里是另一套,长度不一样,规则也不一样;同一份供应商合同,采购侧记一个号,财务侧记另一个号。这种活数据仓库项目干了十几年,企业但凡做过,验收清单里就躺着几页对照表。

计算规则
再往下是计算规则。一台主机的综合效率,是时间开动率、性能开动率、合格品率三个数相乘,不是取平均;分母里的在制品算到哪道工序为止,一条线一个算法。这部分写下来就能稳定回答,不写下来,每一次回答都是临时发挥。

例外情况
最难写的是例外。二季度西南大区回款下滑,里面有一笔是经销商破产引发的坏账计提,另一笔是年初清库时一次性结清的陈账,这两部分跟经营好坏没关系。这种事系统猜不出来,除非有人写过。
真正难住人的就是例外这段。它躲在上个季度的周会纪要里,更多时候躲在两个主管下班前的几句对话里,从来没落到任何一份能被检索的文档上。而它恰恰是 SQL 无论怎么写都取不到的部分。
MIT NANDA 在 2025 年 8 月发布的《The GenAI Divide》把这类现象量成了一个更冷的数字:95% 的企业生成式 AI 试点没有对损益产生可衡量的成效,只有约 5% 走到了规模化。报告给失败归因时用的词是学习缺口,不是模型能力。
学习缺口这四个字翻成企业内部的话,就是没人把口径交给过机器。招一个做经营分析的熟手,头三个月他都在学同一件事:这家公司的收入怎么认定、哪部分要剔除、两张报表打架时以谁为准。这三个月没人觉得多余。轮到一个只读过公开语料的模型,这个环节常常被省掉,上线当天就被问到最难的那个问题。
PART 03
一份明天能开工的顺序

知道卡在哪之后,剩下的事有先后。砍场景排在最前,可它只是清场;真正的地基是把规则和例外写下来。
  • 先砍场景,不要一上来接全库。一个仓库几千张表,全向一句话提问敞开,等于把歧义的数量放大到不可控。挑一个部门的二十个高频问题起手,拿区域销售日报的同比口径练,拿库存周转的周环比练。这二十个问题跑顺了,再放开第二个部门。试点最常犯的错不是技术选错,是目标泛化,谁都说不清这次到底要替谁省多少事。
  • 指标定义只留一处。口径散落在三份 PPT 和两个人的脑子里,等于没有口径。它得有一个所有人知道在哪、改了会通知到谁的地方。这件事麻烦,麻烦的地方不在写,在要求财务和运营坐下来吵完那一个下午。
  • 给模型一条明确的拒答线。跑到定义之外的问题,让它说不知道,并提示用户补充时间范围和口径。这条线是产品功能的一部分,不是兜底逻辑。一个从不说不知道的系统,等于把猜测包装成答案,用户在前三次信任被消耗完之后就不再来了。
  • 溯源是默认配置。每条回答底下挂着它用了哪个指标、取了哪段时间、走的哪条计算路径,最好能把生成的代码直接摊开给用户看。这不是给技术人员的高级选项,这是让业务敢用这个东西的前提。人不会信一个不告诉他怎么算出来的数字,这一点从来没变过。
  • 反馈要落到定义,不要落到提示词。用户点了反对,说这数不对,正确的处理不是给这句提问补一段说明,是回去改那条指标的定义,让所有问到这个指标的场景一起受益。把修正写进提示词,等于把口径又藏回一个人的聊天记录里。
这些事都不依赖模型升级。它们依赖的是有人愿意把企业里那些从没写下来的东西写出来。
招标会上,第一个问题往往落在支持度上:随便问,它都能答吗。
这个问题问错了地方。真正该问的是另一句,公司里有没有一张纸,上面写着“销售额”到底指什么、例外怎么判、谁改它要经过谁。
有那张纸,接什么模型都能用。没有那张纸,换再强的模型,也只是把同一个错误答得更快一点。

【声明】内容源于网络
0
0
AI驱动数字化转型
专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
内容 1106
粉丝 1
AI驱动数字化转型 专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
总阅读13.3k
粉丝1
内容1.1k