Meta 放出了 Muse Spark Open 的模型权重。
先说参数。816B 总参,42B 激活,1M token 上下文,原生多模态,定位 coding 和 agentic。官方给的定语是,迄今最强的美国开源权重模型。
这种话每次发布会都有人说。让我多看了两眼的,是通稿里一句不太起眼的表述。它是这个级别的模型里,第一个能在桌面上跑起来的。
两台 M5 Ultra Mac Studio,就够了。
Muse Spark Open 官方发布主视觉(图源 Meta 官方博客,下同)
1
这是个什么样的模型
先把基本面说清楚。
MoE 架构,816B 总参数,每次激活 42B。1M token 的上下文窗口,原生多模态。训练目标写得很直白,为 coding 和 agentic 而生,长程任务、复杂软件工程、多步推理。
获取通道给得很全。想用 API,Baseten、Fireworks、Groq、Modal、Nebius、OpenRouter、Together AI 今天就有。想要权重,Hugging Face、Amazon SageMaker、Google Cloud Model Garden、Microsoft Foundry 都能下。
推理引擎也基本是全席。SGLang、vLLM、TensorRT-LLM、Transformers、MLX、llama.cpp、Unsloth,AMD、Apple、Intel、NVIDIA 的芯片都有对应优化。想二次微调,PyTorch 的 TorchTitan 直接上手。
许可是 Muse Model License,带有限商业条款,多数开发者可以免费商用。
2
跑分,但要读细
官方跑分表拉得很长,对手一栏里有 Inkling、Nemotron 3 Ultra、Beam、Mistral Large 4,也有大家更熟的 Qwen3.8-2.4T、GLM 5.3 和 Kimi K3。
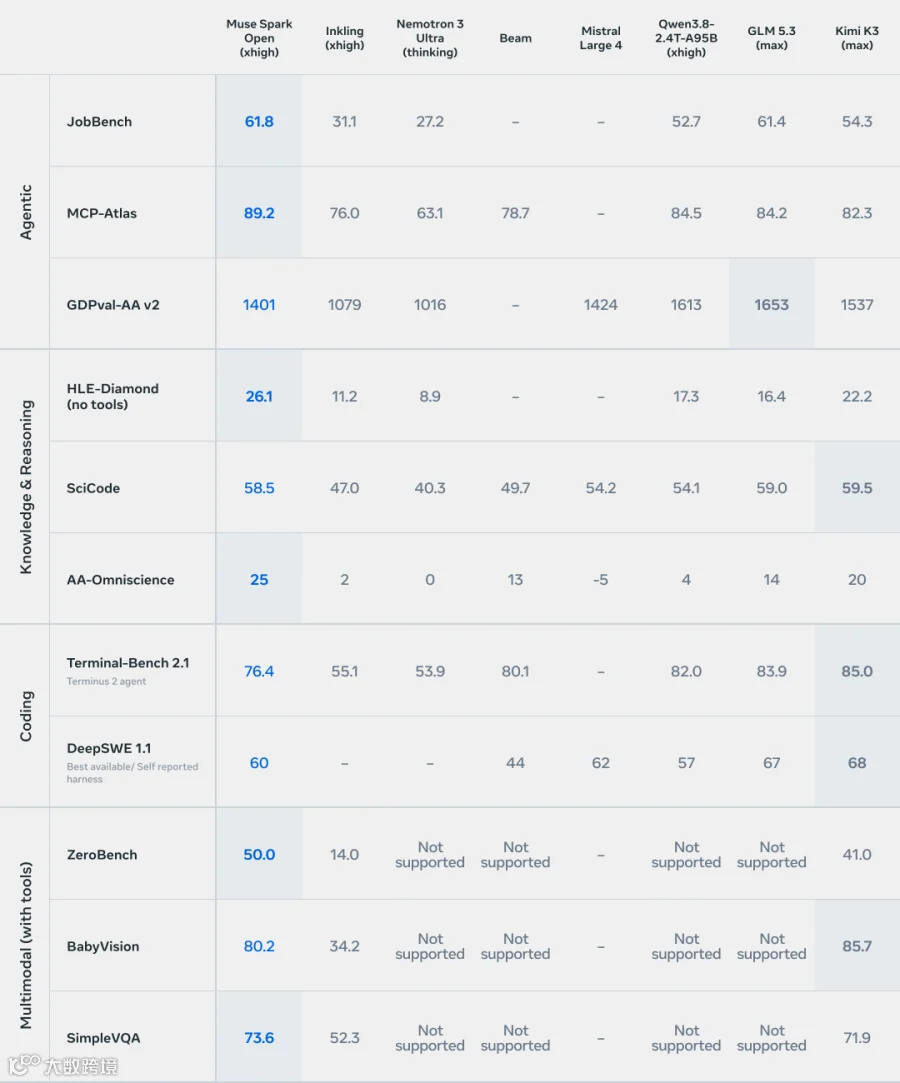
官方完整跑分表,蓝色列为 Muse Spark Open
我替大家把赢面和输面都挑了出来。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
读法其实挺清楚。赢面集中在 agentic 和多模态工具链,输面在终端类 coding。GDPval 那一项它也只排到第四,不如 GLM 5.3 和 Qwen3.8。
所以两句话可以同时成立。美国开源权重里,它确实是新标杆。放到全球开源池子里,终端和软件工程类,Kimi K3 仍然压它一头。
这个赢面分布和它的自我定位是吻合的,它不是来卷 coding benchmark 的,它是冲着 agent 干活去的。
3
真正的新闻,在桌面上
参数和跑分聊完,说回那句让我多看两眼的话。
两台 M5 Ultra Mac Studio,配合最新的 MLX 框架,就能把这个 816B 的模型完整跑起来。官方的说法是,两台机器表现得像一台拥有 1TB 统一内存的超算。
背后的道理不复杂。Apple 的统一内存架构让 M5 Ultra 的 GPU 能直接摸到整台机器的内存,每台 512GB。而 MoE 模型推理时,每个 token 只需要读权重里很小的一片,1.2TB/s 的内存带宽刚好供得上。显存装不下的问题,被内存解决了。
他们还真的在本地跑了两个 agentic 的活儿。
一个是用 Muse Code 给 Ice Cubes,一个开源的 Mastodon 客户端,提交真实的 iOS 改动。修 bug,加新功能,跑完整 build。另一个是端到端驾驶 DaVinci Resolve,模型逐帧看素材,挑出最强的瞬间,裁成竖屏。
全部在设备上完成,没碰云。
前沿模型的家,第一次从机房搬到了书桌上。
4
工程、安全,和怎么拿到它
随权重一起发的还有一批 Helion GPU 内核,自动调优,已经进了 SGLang。在 NVIDIA 和 AMD 的卡上,kernel 级加速 1.03 到 3.95 倍,AMD MI350 端到端快 3%。
安全部分也交代了。开放权重有它自己的风险,模型做了额外的安全后训练,按 Meta 自家的 Superintelligence Scaling Framework 评估,过了发布门槛,细节在 Hugging Face 的 model card 里。
想动手的话,权重在 Hugging Face 的 meta-models 合集页,Mac 上跑用 mlx-lm 这个 adapter,它会直接从 Hugging Face 拉权重。
过去两年,开源权重的故事一直是谁在数据中心里堆得更大。这一次,Meta 把方向拧了一下。
Meta 讲 personal superintelligence 讲了一年多,多数人当口号听。两台 Mac Studio 跑 816B,是这个口号第一次有了字面意思。
当权重、算力和数据都在你自己的桌子上,personal 这两个字才真正成立。
开源模型的下一幕,可能不在云端的价格战里,在每个人的桌面上。
原文 Muse Spark Open is available today,Meta Research 官方博客,2026 年 10 月发布。模型权重见 Hugging Face 的 meta-models 合集。
1.20K-40K!深圳扬奇医芯招双目结构光算法工程师
2.AI教父Hinton诺奖演讲首登顶刊!拒绝公式,让全场秒懂「玻尔兹曼机」
3.GitHub没了?CEO辞职,微软接管,开发者天塌了
4.AI颠覆数学研究!菲尔兹奖得主、华裔数学家领衔11篇顶刊论文|陶哲轩转赞
5.AI OS,下一个二十年的超级平台
6.全球首个IMO金牌AI诞生!谷歌Gemini碾碎奥数神话,拿下35分震惊裁判