

位置指纹+线性模型+动态规划,多肽优化的一条实用路线。
非天然氨基酸(ncAA)让多肽设计拥有更多化学积木,也让候选空间迅速膨胀:约4000种单体用于14肽设计,组合规模可达 10⁵⁰。如何从中挑出值得合成的序列?
2026年10月12日,默沙东与Texas Tech研究者在 npj Drug Discovery发表 PepOpt,将可解释预测与超大空间搜索连接起来。核心思路很直接:先拆解各位置的结构贡献,再利用可加性寻找高分组合。

先对齐,再让模型“认结构”
PepOpt的流程由四步组成:
PepSeA对齐 → 位置特异分子指纹 → 线性模型 → 动态规划。
对齐解决环肽的位置对应问题;随后,将各位置的单体指纹拼接,让模型同时保留“是什么结构”和“出现在什么位置”两类信息。
作者在5个专有研发项目、11个肽系列上开展评估,最终选择 ECFP4+Bayesian Ridge作为框架配置。与所评估的非线性模型相比,PepOpt表现具有竞争力,其中RBF-SVR采用相同单体表示时也是强基线。
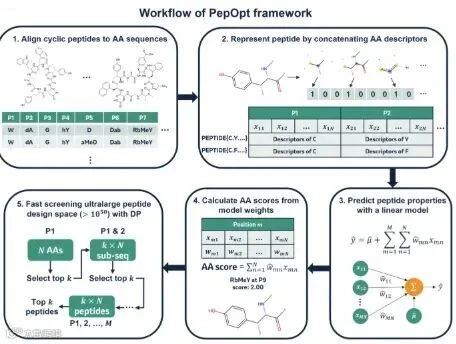
图1|PepOpt如何连接预测与搜索。对齐后的多肽按位置编码,线性模型学习结构贡献,再由动态规划筛选候选。
分数能拆开,才有改造线索
线性结构带来的直接收益,是可以逐层拆解预测:整肽 → 位点 → 单体 → 子结构。
在A-2系列中,模型将P9位点RbMeY的高贡献进一步归因到 R-β-甲基相关子结构,其重要性得到实验数据支持。这让输出从“这个残基值得选”,推进到“这个结构特征值得继续围绕它设计”。

图4|从残基分数追到化学子结构。展示位点单体评分、关键指纹对应的结构,以及整条肽的位置贡献。
没见过的单体,也能筛?
相较于将单体身份编码的经典Free-Wilson表示,PepOpt利用子结构权重,为训练中未出现的ncAA提供评分依据。
在A-2系列P9位点的约4000种单体筛选中,模型提出了分数高于最佳已测单体的未测候选。这些建议保留了模型识别出的R-β-甲基特征。
关键前提:新单体的相关子结构需要在训练数据中有所覆盖。未测候选的高分,代表值得验证的设计假说。
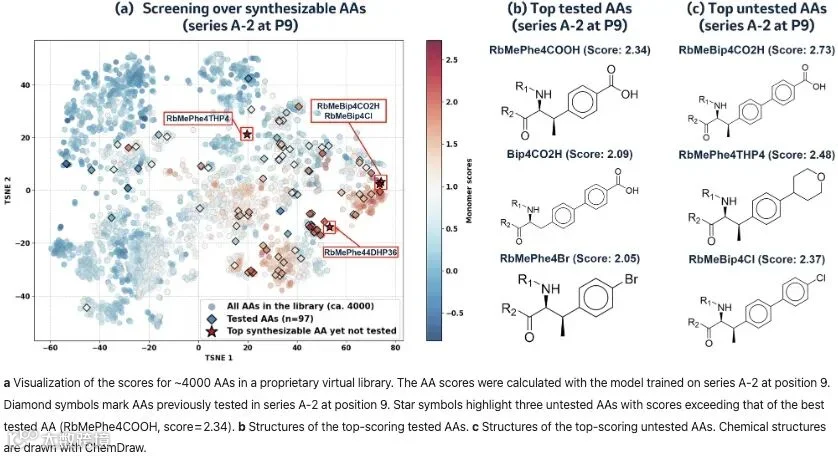
图5|从单体库中寻找下一轮候选。菱形标记已测单体,星形标记预测分数超过最佳已测单体的三个未测候选。
10⁵⁰空间,靠什么搜?
答案是可加性。
当整肽预测可以分解为各位置单体贡献之和,就能利用动态规划寻找前k个高分组合,无须逐条枚举全部序列。论文在两个超大空间的比较中,DP获得的最高预测分数均超过所采用的遗传算法设置。
这里要抓住一个区别:DP保证的是给定加和模型与搜索空间内的最优结果。真实活性仍受模型误差、位点互作及构象变化影响。
这也是PepOpt最值得借鉴的设计:模型形式不仅服务预测,还直接决定后续搜索能否高效执行。
研发价值与边界
PepOpt还能分别建模多个性质,再汇总归一化单体分数,用于多参数优化。代码已开放,但主要评估涉及的部分专有数据因知识产权限制无法全部公开。
开源项目:https://github.com/MSDLLCpapers/Pepopt
它的边界同样清晰:强位点互作可能挑战加和假设,域外新片段会削弱外推可信度;模型归因也不能直接当作作用机制。
这项研究的启发,是把“预测得分”推进为“可讨论、可搜索、可验证的设计建议”。
下一步是否值得合成,由模型提供依据;是否值得继续推进,由实验回答。
参考文献
Mao, Y., Zhang, R., Sheridan, R. et al. Interpretable machine learning framework for peptide lead optimization in ultralarge design spaces. npj Drug Discovery 3, 45 (2026).
加入AI口服环肽交流群,加我V:myt030489,备注:姓名_研究方向_公司