

AI模型库 · 今日一模
Reflection Beam 1.0
开源权重 · 编码与 Agent · 纯文本
总参 501B · 激活 23B · 1M 窗 · Apache 2.0

10 月 16 日晚上,Reflection 把 Beam 的权重挂上了 Hugging Face。总参 501B,每个 token 只激活约 23B,上下文 1M,许可证是 Apache 2.0。同一时间,Ollama、Together、Baseten、Modal、Cloudflare、vLLM 这些合作方一起发帖说「第 0 天就能用」,官方的说法是 40 多家伙伴同步上线。
这件事其实 10 月初就预告过。Reflection 当时发帖说「本月放出完整权重」,那条帖子在 X 上有 240 多万次浏览。十来天后真放了,而且一口气放了 BF16、FP8、NVFP4 三套精度,外加一个用来加速推理的 DFlash2 草稿模型,以及他们自己训练时用的开源 Agent 外壳 Mirror CLI。
我最在意的是许可证。昨天写的 Muse Spark Open 走的是 Meta 自家许可,要显著标注出处,做模型服务营收过线还得另签协议。Beam 直接 Apache 2.0,模型卡还专门写了一句:不禁止蒸馏、不禁止用输出训练别的模型、不禁止微调、量化、合并。对想拿开源大模型做产品的团队来说,这比跑分多几分实在得多。
但第三方测评也来得很快。Artificial Analysis 给的结论里有一句很扎眼:知识问答的幻觉率 47%。下面按老规矩拆:它能干嘛,对做应用的人意味着什么,冷水泼在哪。
01
PART
它能干嘛
WHAT IT DOES
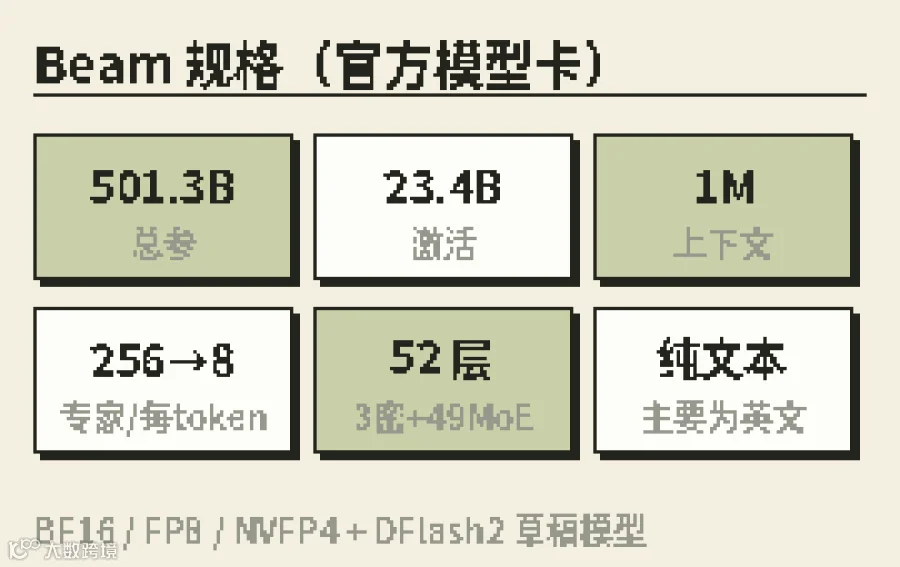
定位很单纯:写代码、跑 Agent、做推理。模型卡列的四项主能力是省 token 的推理、软件工程(修真实 GitHub issue、在命令行和运维环境里干活)、工具调用(长任务、MCP、浏览网页)、数学和科学推理。只吃文本、只吐文本,不看图。
501.3B
总参数
23.4B
每 token 激活
1M
上下文
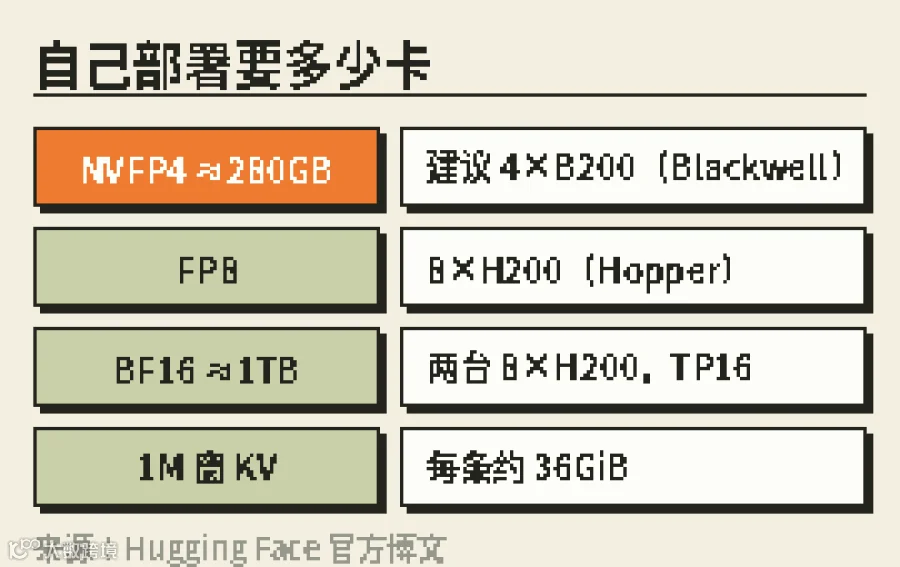
结构上,52 层里前 3 层是普通稠密层,后 49 层是 MoE,每层 256 个专家,每个 token 只走 8 个。注意力是混合的:大多数层只看前面 512 个 token 的滑动窗口,每隔六层才有一层看全文。Hugging Face 的博文算过账:这样每个 token 的 KV 缓存只涨约 36KiB,塞满 1M 窗一条请求约 36GiB;要是 52 层都看全文,会是 208GiB。长上下文成本大概只剩六分之一,这是实打实的工程收益。
训练投入也写得很具体:预训练 23.8 万亿 token;强化学习阶段用了 1.05 万张 GB300 跑了 4 周,生成超过 1 亿条 rollout,评分和训练一共开了约 13 亿个沙箱,环境池接近 100 万个。官方说 RL 加到最后「还没看到平台期」。这些都是厂商自述,但细到这个程度,至少说明他们不是拿别人的底座套个壳。
跑分方面,模型卡自报 BF16 版 SWE-bench Verified 81.6%、Terminal Bench v2.1 80.1%、MCP Atlas 80.8%、GPQA Diamond 90.6%。这些是 Reflection 自己测的,我只把它当「厂商觉得自己强在编码和工具调用」的方向信号。官方说可复现的评测配方「很快放出」,现在还没有。
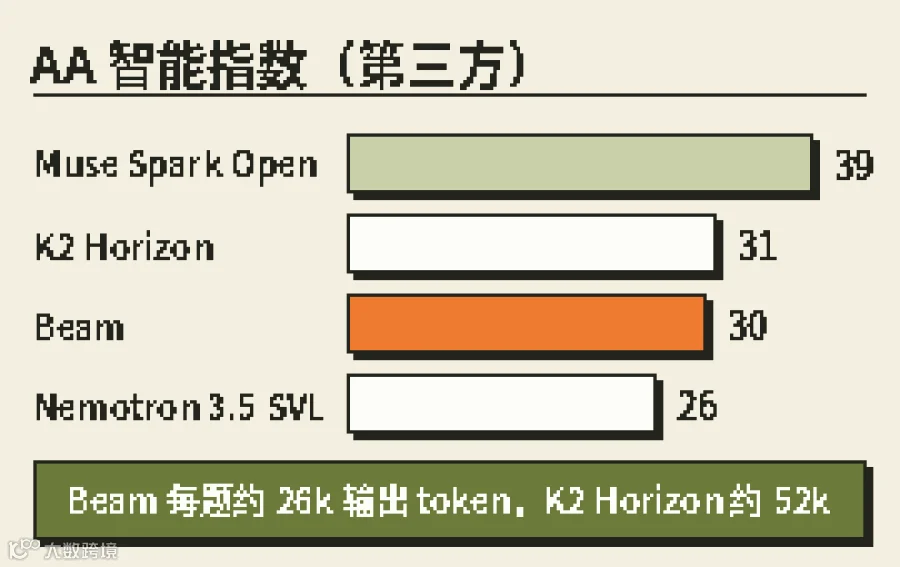
更值得看的是第三方。Artificial Analysis 智能指数给 Beam 打了 30 分,在美国开源权重模型里排第二,前面只有 Muse Spark Open(39),后面是前天的 NVIDIA Nemotron 3.5 Super VL(26)。它每道题平均输出约 2.6 万 token,分数只高 1 分的 K2 Horizon 要用约 5.2 万。「省 token」这个卖点,第三方至少部分认了。
02
PART
对做应用的人意味着什么
WHY IT MATTERS
第一,试用门槛几乎为零。Ollama 宣布限时免费,模型托管在美国、零数据留存,一行命令就能接进现有编码 Agent。Vercel AI Gateway 也挂了限时免费的 reflection/beam-free,还透露这模型之前一直以「stealth/cat-jam」的代号匿名跑着。Hugging Face 的推理服务也能直接调,背后是 Baseten、Fireworks、Together。
Ollama 官方给的命令(10月16日帖)
ollama run beam
ollama launch claude --model beam:cloud
ollama launch codex --model beam:cloud
ollama launch opencode --model beam:cloud
这里的 beam:cloud 是跑在 Ollama 云上的,不是你本机。别看到 Ollama 就以为笔记本能扛 501B。
第二,自己部署的账比昨天那位好算。Hugging Face 博文给的建议:最实际的是用 NVFP4 版,权重从 BF16 的约 1TB 压到约 280GB。两张 B200(共 360GB)勉强装得下权重,但没空间留给缓存,建议按四张 B200 规划;也可以两张 B300,或者 8 张 RTX Pro 6000。NVFP4 只有 Blackwell 能原生跑,H200 这一代要用 FP8,官方 SGLang 示例是 8 张 H200。BF16 原版用 vLLM 要 16 卡张量并行,也就是两台 8×H200。
vLLM 起服务(BF16,两台 8×H200)
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
起来之后是 OpenAI 兼容接口,现有代码改个 base_url 就能对比。推理强度有五档:low、medium(默认)、high、xhigh、max。Hugging Face 团队做了五个小测试,低档在长上下文代码检索那题输出格式没对上,数学题答案对了但漏了要求的推导过程,高档五题全过,token 用量也明显变多。上线前每档都要拿自己的任务量一遍,别默认开满。
第三,它能当「包工头」,帮你做出能卖的小东西。Hugging Face 博文里有个我觉得最有用的案例:他们用 Beam 加开源的 Pi 编码 Agent 起步(博文提到中途 Beam 额度用完过),去训练一个开发事故分诊的小模型,判断该派给哪个团队、多严重、要不要立刻叫人。最后用 Unsloth 微调了 Qwen3.5-0.8B,在 320 张测试工单上三项全对的比例 76.25%,不微调直接提示只有 4.69%;单张工单平均延迟从约 1218 毫秒降到约 103 毫秒,快了 11.9 倍。数据、代码、检查点都公开在他们的 bucket 里。
这个思路比「拿 501B 直接回答客户」更接地气:大模型负责调研、造数据、写训练脚本,最后交付一个便宜、快、能部署的小模型。做 B 端交付的人,可以直接照这个流程报价。另一个案例是让 Beam 写一个 macOS 菜单栏语音输入工具 BeamSpeak,博文也老实写了:最终源码里有一部分是后来用 Codex 修的。
第四,想微调也有现成配方。官方给了 TRL 的 LoRA 监督微调示例,单台 8×B300 能跑,约每秒 1.9 万 token;用多语言推理数据训一轮后,「用用户指定的语言思考」从 16 题里对 3 题变成 16 题全对。全参数 GRPO 就是另一个量级了,参考配置 96 张 H200。Reflection 还在 Hub 上搞征集,用 Beam 做出好项目的可拿 1 万美元 Hub 额度。
03
PART
冷水该泼哪
COLD WATER
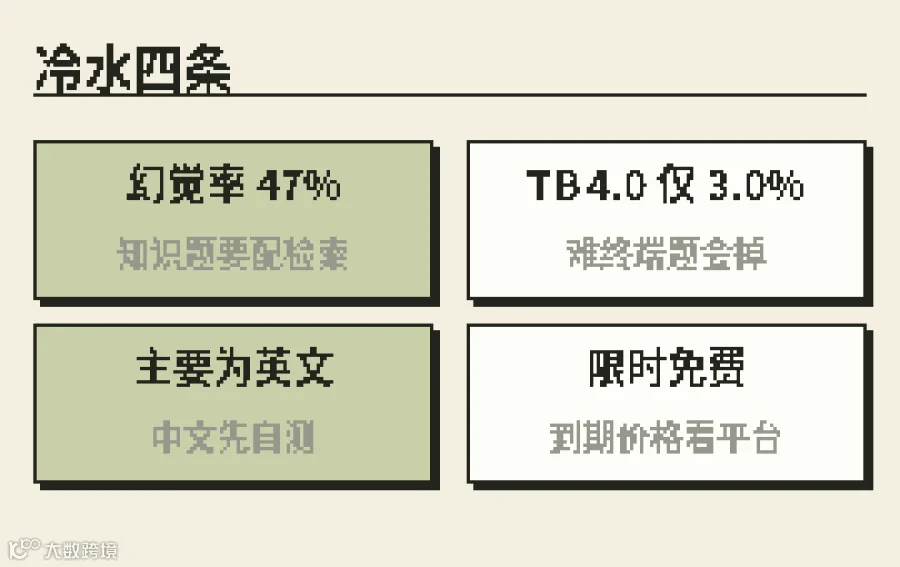
第一盆:幻觉率 47%。Artificial Analysis 的知识问答测试里,Beam 答对 33%,比 K2 Horizon(18%)和 Qwen3.8 27B(16%)都高,知道的东西确实多;但它不会的时候更爱硬答,幻觉率 47%,那两位分别是 26% 和 30%。拿它做客服、知识库问答,必须配检索和引用核对,别让它凭记忆回答。
第二盆:换一套更难的终端题,分数掉得很厉害。自报 Terminal Bench v2.1 是 80.1%,Artificial Analysis 用的是更新更难的 Terminal-Bench 4.0,Beam 只有 3.0%,Qwen3.8 27B 是 5.6%,Muse Spark Open 是 8.1%。版本不同不能直接比,大家在 4.0 上都很低,但它确实排在后面。Arena 的 Agent 榜它排开源第 12,误差 ±3.84%,和前面两个 Qwen3.8 在统计上分不太开。
第三盆:主要为英文开发。模型卡原话是「developed predominantly for English」。中文需求文档、中文代码注释、中文客服话术,效果得你自己测,别拿英文榜单直接推断。
第四盆:省 token 是相对的。每题 2.6 万输出 token 里,约 1.9 万是推理,只有约 26% 花在最终答案上,这个占比在 219 个被测模型里排倒数第 28。总量省了,但大头仍是思考过程,账单和延迟要按真实链路量。
第五盆:限时免费总会结束。Ollama 和 Vercel 都写的是「限时」,到期后怎么收费以各平台后台为准。别把免费期的成本写进长期报价。
另外它不看图。截图排障、看设计稿这类活,要么换多模态模型,要么先转成文字再喂。
Beam 让我挺兴奋:Apache 2.0、能下、能改、能蒸馏,部署账也比昨天的 816B 好算不少,第一次放权重就把推理、微调、RL 配方一起摆上桌。可要是有人说它「开源追平闭源」,我会把 47% 幻觉率和 3.0% 那两个数甩过去。它更像一个许可干净、成本可控的编码主力,前提是你自己验收过。
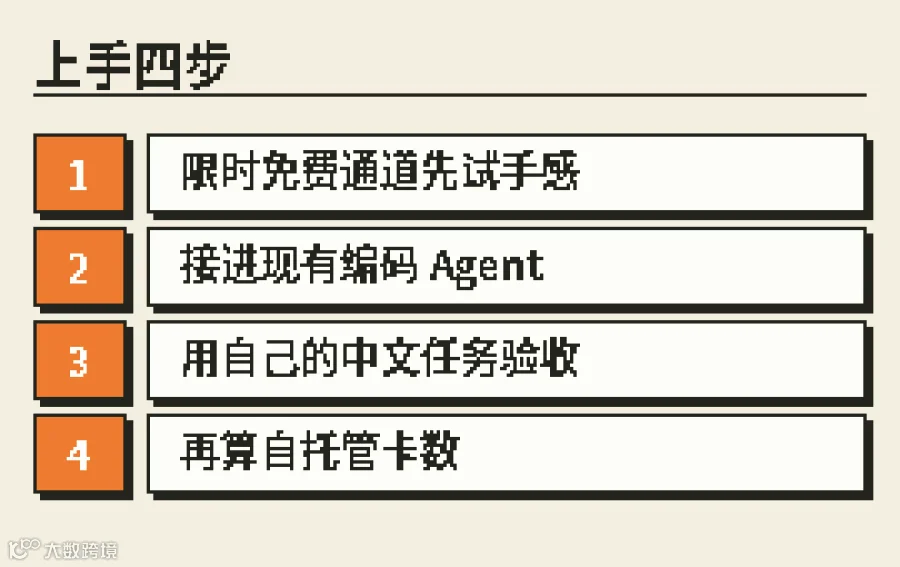
CHECKLIST
Ollama 或 Vercel 限时免费试手感 → 接进现有编码 Agent 跑真实 bug → 中文任务单独验收 → 知识问答必配检索 → 五档推理强度各测一轮 → 要自托管再按 NVFP4/FP8 算卡数。
照着做可以按这张单子:① 今天就用 ollama run beam 或 Vercel 的 beam-free 试几个你手头真实的 bug;② 用 ollama launch 把它接进 Claude Code、Codex 或 OpenCode,和现用模型跑同一组任务,记下通过率和 token 数;③ 单独准备 10 条中文任务,看理解和输出有没有掉;④ 涉及事实问答的场景先接检索,关掉「凭记忆答」;⑤ low、medium、high 各跑一轮,找到够用的最低档;⑥ 确定要自托管,再按 Blackwell 用 NVFP4、Hopper 用 FP8 估卡;⑦ 想做交付,参考 Hugging Face 那个分诊案例,用大模型造数据、训一个小模型交给客户。
很多人卡在第 ⑦ 步:模型会用了,命令也跑通了,就是不知道怎么变成一单生意。买家是谁、交付什么文件、过关标准写什么、改几轮,这些和模型强不强没关系。
你会先拿 Beam 接进哪个编码 Agent?评论区聊聊。
出处:Reflection 官方博客与模型卡、Hugging Face 模型页及博文《Welcome Beam》(10月16日);X @reflection_ai、@ArtificialAnlys、@ollama、@arena、@vercel_dev。
往期 · 接着看
Meta开源Muse Spark Open:816B只激活42B,两台Mac能跑?NVFP4仍要约700GB显存
蚂蚁开源Ling-3.1-flash:560B只激活25B,1M窗线上先给256K
Step 5:600B 只激活 27B
「AI商业实战」新人邀请礼遇 ¥25,进圈可领两张短卡:「交付定义卡」把买家、交付文件、过关标准、改稿轮次一次写清;「一周试跑清单」按天跑通一个最小交付闭环。不保证接单,帮你少走弯路。
工具会用还不够,进「AI商业实战」从项目练到接单。

新人邀请礼遇:领取新人邀请
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING