

一段城市追逐从起跑持续到撞翻路边水果摊,人物绕过车辆、转向、压倒纸箱,摄影机始终跟着跑。对做过 AI 视频的人来说,真正值得看的不是画面能连续播放 20 多秒,而是人物、道具和镜头在这段时间里能否一直相互接得上。
可灵 4.0 正式版把单次生成的上限拉到了 30 秒。更长的时间让一个镜头有机会容纳动作的起承转合,也把模型容易露怯的地方放大了:前一秒撞到的东西,后一秒要有合理反应;人物转身之后,镜头还得知道该往哪里走。
这次更新可以沿着三个问题看:30 秒能不能承载一个完整场景,复杂运动是否连贯,以及参考素材能在多大程度上约束结果。最后还要算一笔账:做出一条能用的片子,到底要生成多少次。
30 秒里,能发生多少事
以往做 AI 视频,常见办法是先生成几个短镜头,从每段里挑出可用的几秒,再靠剪辑接起来。片段短,能藏住一些动作断裂;想让一件事在同一镜头里从头到尾发生,难度就明显不同。
30 秒接近一个完整的场景单元。它可以给人物一次行动的时间,也可以让环境和镜头参与叙事。可灵 4.0 支持最长 30 秒单次生成,这个数字的价值,取决于模型能否让这段时间里的空间关系保持稳定。
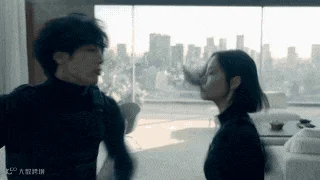
可灵 4.0 创作者演示:30 秒打斗镜头中的连续攻防与环境互动(节选,来源:可灵官方博客/Johnson Sheng)。
城市追逐样片给出的要求并不简单:参考图中的人物进入另一张图里的城市,被人追赶,途中撞翻水果摊,与路上的车辆发生交互,镜头全程跟拍。这里没有只靠速度感撑场面。人物跑动、障碍物、车辆、被撞倒的物品和摄影机,都需要在同一条时间线上作出反应。
公开展示的结果里,水果落地之外,还有一个很小的接触细节:人物压到被自己撞倒的纸箱,箱体随之变形。单个画面不足以证明模型理解了物理规律,但它说明这段样片的动作并非只有人物在空场里跑,环境也参与了连续变化。对需要拍追逐、运动或产品交互镜头的人,这比单纯延长秒数更有参考价值。
另一段马戏团样片没有用参考图,而是靠较长的文字提示生成 30 秒内容。提示里连续安排了高速俯冲、穿过狭窄门帘、前景遮挡、多人运动、鸽群与羽毛、金粉,以及正常速度和慢动作的切换。这类组合容易在遮挡后丢失主体,也容易让动作和镜头各走各的。
两段演示检验的是不同问题。城市追逐看人物与道具、场景和摄影机的持续关系;马戏团看密集事件能否被串成一段有节奏的画面。最长 30 秒只是容量,真正可用的长镜头还要让这些关系在镜头内部成立。
这也解释了为什么“一镜到底”比一串漂亮的短片段难。短片段之间可以用剪辑重新建立方向和节奏;镜头不切,前面设定的道路、人物位置和运动方向就必须被后面的画面继承。时长增长以后,单个破绽不再只是一个坏掉的画面,还可能让整段场景失去可信度。
动作连贯,先看前后有没有因果
长镜头之外,大范围运动也是这次更新的重点。画面质感和人物表情当然重要,但打斗、跳跃、急停这类动作会迅速暴露模型的问题:姿态可能漂亮,动作之间却没有原因;镜头看起来很忙,观众仍不知道人物到底做了什么。
一段狭窄电梯里的打斗样片,提示词安排了挥拳、侧身闪避、抓腕、肘击、被人从后抱住、撞向电梯壁、挣脱和摔倒对手。摄影机还要贴身跟拍、横移,并在撞击时有轻微震动。这里的考点不是能否出现一拳,而是上一招如何迫使人物作出下一招。
从展示出的结果看,闪避到反击、身体接触到重心变化,动作关系能被辨认出来。近距离的运镜和碰撞时的震动也帮画面建立了重量感。它仍是一组创作者样片,不能据此推断所有复杂打斗都能稳定生成;但至少展示了模型在连续攻防上的一种可见进步。
为了把动态表现从打斗场景里抽出来看,样片又换成花样滑冰。运动员助滑、急停、跃起、旋转、落冰,摄影机低机位跟随,还要在高速动作与慢镜头之间切换。观众熟悉这些动作的基本形态,身体中轴、四肢展开和落冰衔接一旦出错,会格外显眼。
这段演示里的跳跃、旋转与落冰没有明显拆成互不相干的姿势。随后一段篮球镜头又让球员完成后撤步投篮,摄影机绕到身后跟随篮球,直到球进篮筐、篮网弹起。样片的判断范围仍然有限,不过从近身对抗到花滑、篮球,它们把“动态”拆成了几种不同的连续关系:人和人、人和地面、人和球,以及摄影机和主体。
从首尾帧,到多个关键时刻
动作能连贯是一面,创作者能否控制它往哪里走是另一面。可灵 4.0 将原先更偏向首尾帧的控制扩展到多关键帧,一次最多可以放入 10 张关键帧图像。关键帧不只是两端的起点和终点,还能在时间线上为中间的重要画面设位置。
公开演示中,创作者准备了四张图片,让它们分别成为视频中的四个时刻。这个例子要看的不是四张图能否被依次显示,而是两张图之间有没有自然的过渡。对有分镜意图的人来说,多关键帧的意义正在这里:可以先确定几个必须出现的视觉节点,再把节点之间的运动交给模型完成。

可灵 4.0 官方多关键帧演示节选:星光、屏幕图形与发光角色依次出现;这是另一组示例,并非文中的四帧样片。
当然,关键帧越多,也不等于控制就越精确。人物位置、动作方向、场景透视和每段时长仍然要在生成结果里一起成立。四帧演示呈现了顺畅过渡,但不能替代不同题材、不同镜头的可重复测试。
参考的不只是人物,还有镜头语言
全能参考解决的是另一种常见困难:创作者知道自己想要怎样的景别、运动和节奏,却很难只用文字把它说准。与其反复写提示词、碰运气抽卡,不如把已有画面或视频片段当作参考,直接指出希望保留的表达方式,再替换内容。

上:参考视频;下:可灵 4.0 换成赛车与夜间赛道后的生成结果。可对照漂移运镜与节奏(来源:可灵官方使用手册)。
一段演示选用了《指环王》中的长镜头片段作为运镜参考,只取其中适合当前生成时长的一小段。随后换掉原场景、塔楼和人物,把主角改成机器人,并额外规定机器人在蝴蝶落到手里之前与之后的表情变化。这里需要同时保留镜头运动的感觉,又让场景、角色和情绪线索按新的设定运行。
生成样片呈现出略带滑稽感的新片段。它的价值不在于复制电影镜头的内容,而在于把“我想要这个镜头怎样运动”变成模型可以接收的参考。原演示还展示了借助人物三视图替换视频角色的尝试,说明参考控制可以落到人物外形,而不只作用于整体氛围。

上:参考视频;下:可灵 4.0 将主体替换为猫的结果。镜头顺序与抚摸动作可逐段对照(来源:可灵官方使用手册)。
这种能力与多关键帧并不重复。关键帧更适合指定几个必须抵达的画面;视频参考则能传达连续运镜、景别和节奏。两者都在减少纯文字描述的含糊性,也都还需要看片子本身,才能判断角色一致性和动作是否真正受控。
参考素材越丰富,创作意图也越需要说清。示例里的要求同时包含场景替换、人物替换、石塔位置和表情变化,模型需要知道哪些元素应沿用参考镜头,哪些必须按新图重建。全能参考的进步,恰恰体现在这些约束能否一起工作,而不是只让成片在第一眼看起来相似。
成片成本,不能只看一次生成的价格
最后回到每天都要出内容的人最现实的问题:钱。一次生成的价格容易看见;为了拿到一条能交付的成片,反复生成、挑选和重做的次数,才会把成本真正拉开。长镜头、复杂动作和参考控制如果能减少废片,价值才会落到工作流里。
在原演示所示的会员积分口径下,可灵 4.0 的 1080P、30 秒为 450 积分,作者按当时会员价估算约 16 元;720P 约 9 元。可灵 4.0 Flash 的 720P、20 秒为 120 积分。人民币金额随会员价格和兑换口径变化,不能把这组估算当成固定售价。
原作者因此提出一种分工:先用更便宜的 Flash 跑小样、确定方向,再用正式版生成目标片段。它不是对所有项目都最省钱的保证,但逻辑清楚:早期探索需要多次试错,定稿阶段才需要把预算押在更完整的效果上。
还有一个值得留意、但不能提前算进当前交付能力的规格:官方此前将 1080P 和 4K 的 10-bit HDR 输出列为即将推出。它关系到后期调色的空间,现阶段仍应按实际开放状态判断,不能把计划中的能力当成手上已经有的成片。
可灵 4.0 这次让 30 秒直出、复杂动作和多种参考方式走到了一起。公开样片展示了它在连续运动与可控性上的进步,也留下了需要用更多题材与重复生成继续检验的问题。对创作者来说,视频模型多一个有竞争力的选择,意味着同一个镜头可以有更多实现路径;最终哪条路径值得用,仍取决于成片质量、废片率和实际成本。