

OpenAI 最近给自己的代码库做了一次大扫除。
五位工程师,一边忙着手头的项目,一边让 Codex 查旧代码、提清理方案。主要利用两周的空当,团队合入了 1400多个 PR,删掉80多万行代码。
清完之后,一项服务的容器镜像从3.31GB缩到1.72GB,另一批清理拿掉了约400个视觉快照变体。
这次大扫除的起因,OpenAI 说得很实在:编程 Agent 帮大家把软件做得更快,要维护的东西也跟着多了起来。
负责公司实验基础设施的工程师 Rodrigo Roim 分享了这段经历。他们用 GPT-6 Astra 和 GPT-6.1 Sol 配合 Codex,开始把那些一直排不上日程的旧账翻出来。

OpenAI 把Codex用于清理无用代码 旧功能开关和CI
一段代码,只剩测试还在用
想删一段代码,先得知道谁还在用它。
看起来没有调用者,可能只是入口藏在反射里;很久没有执行的分支,也可能是出故障时用来救急的。Roim 记得,团队以前就发生过误删代码引起的事故。
用 GPT-5.6 Sol 时,他通常要先圈定调查范围、写清验证标准,再让 Codex 写分析脚本、做清理。
换成 Astra 后,他试着只交代目标,让模型自己判断去哪里找证据。最初用的提示词很短,译成中文是:
请帮我找出并清理仓库里的死代码。你可以查看 Slack、Statsig[我们使用的功能开关与实验平台],或者其他任何需要的来源,确认这些东西确实已经不用了,可以删除或简化。Astra 于是去查旧 PR、Slack 讨论和内部项目记录,还读了生产环境的性能分析表,核对相关代码有没有被执行。建议删除时,它把理由一起交出来,由了解对应项目的团队审查。
确认这套办法能用,五位工程师才把类似的任务铺到更多仓库。
有些代码留下来的理由,甚至有点好笑。
9月,开发者 Emanuele Di Pietro 让 Astra 跑了一夜,整理自己的 Synara 代码库。他说,代码净减了2901行,还找出一类遗留物:应用早就不用了,只有它自己的测试还在调用它。
业务已经搬走,测试还在认真证明这段旧代码能跑。
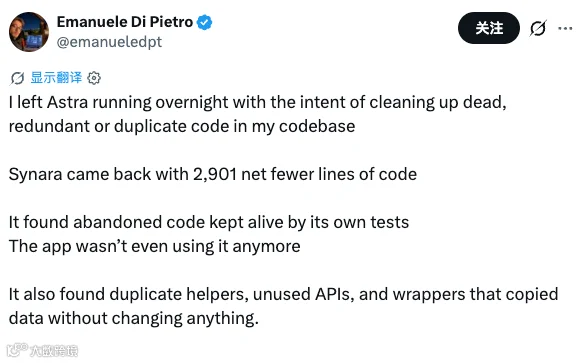
Emanuele原帖:应用早已不用这些代码 只有旧测试还在调用
他贴出的清单还包括重复的辅助函数、没人在用的 API,以及只复制数据、不做任何改变的封装。有用的测试被保留,挪到仍在使用的函数上。

Synara清理清单 最后一行交代有用的测试如何保留
标着“永久”的开关,也被翻了出来
旧实验比死代码更难收拾。
实验早就结束了,代码却可能还在生产环境里执行;一个值长期不变的开关,也可能被其他功能依赖。只看代码,很难判断它现在还有什么用途。
Roim 先让 Astra 查实时配置、Git 历史和正在修改的 PR,每项清理做成一个小的草稿 PR,附上配置页面。紧急关闭功能的开关等运维保护要留下。
他审完第一轮,把评论交回给 Astra,让它据此改进提示词,再去查整个仓库。任务不再只盯着“有没有用”,还要回答:哪些检查在白白消耗 CPU,先清哪一项最划算?
下面是原文公开的这条提示词的完整译文,其中的省略说明也来自原文:
/goal 找出整个仓库中每一个已经过时、取值固定、被放弃或已全面上线的 Statsig 功能开关、配置、实验和实验层,前提是删除它们不会改变生产环境行为。审查所有 Statsig 项目及其对象清单,不要只看标记为过时的对象。
通过枚举、常量、封装、别名、schema、动态拼接的名称以及跨服务调用方,查找间接使用。逐一核对生产代码所引用的所有常量;不要只列出一份保守的候选短名单就停下。
考虑每个对象使用的云资源,包括 CPU。能取得生产遥测和性能剖析数据时,用它们找出开销较大的无效检查。
[为简洁起见省略了以下内容:Astra 生成的详细说明,涉及如何验证生产行为、优先处理较旧对象、保留有意设置的保护措施,以及理解 SDK 回退行为。]
生成一份 Markdown 报告,按可以并行处理的归属团队/文件工作流,对所有已核实的候选项分组。列出生产环境取值、证据、负责人、调用位置,以及能够取得的实际求值开销或 CPU 开销。
不要修改线上配置或服务。
这一步先交报告,不直接改线上服务。报告要把线上取值、调用位置、归属团队和实际开销放在一起,让工程师能决定从哪里下手。
其中一项发现,藏在几百条相似映射中的一行 Python 代码里。
几年前,工程师为内部测试做了个总开关,允许开发者覆盖所有新功能开关。这一行代码把它关联到了全部功能,每次求值向外展开,都要付出额外的 CPU 开销。
Astra 查到了开销,却没有直接动手。管理后台给它贴着一个标签:Permanent,永久。
它把这个可能仍有运维用途的开关交给人审查。团队确认后决定移除,估算主要受影响的服务能省下约0.42%的 CPU。
63项测试,还在,但不用再等十分钟
CI 也有同一个麻烦:能改的地方很多,先做哪件?Roim 给 Codex 的要求是:
你有哪些办法可以减轻这个仓库的 CI 负载?把想法列成一张表,并依据这个仓库的 CI 运行历史,按估算每天可以节省的 CI 分钟数,为所有想法排序。按每天能省下多少 CI 分钟数排队,优化就不只是“把某段代码写得更漂亮”。团队随后落地约30个优化 PR,中位完成时间从约10分钟降到4.5分钟,90分位从12.5分钟降到6分钟。
后来的一项修复更具体:补上一个缺失的 mock,一组63项测试从592.6秒缩到29.8秒,耗时减少约95%,63项测试全部保留。
对那些时好时坏的 flaky 测试,他给的提示词同样留了一个明确的停止条件:
/goal 查看最近所有 CI 运行记录,找出不稳定测试。对每项不稳定测试,尝试修复,成功后提交一个 PR。你的任务是为简单问题找到明确的修复办法,而不是把每一个不稳定测试都彻底修好。慢测试和偶发失败各找各的原因,不必一开始就给 Codex 一个“修好所有测试”的任务。
做维护,也得挑合适的配置
CI 省下了等待,扫描代码本身也要花钱。
Roim 又拿同一套提示词,在一个仓库的部分子目录里比较了三个配置。范围超过6000个文件、100万行代码,涉及 Python、TypeScript、Go 和 Rust;发现项由他审查确认。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
Sol Ultra 找到的数量约为 Astra Ultra 的92%,费用约为14%。这里按标准 API 价格计算,包含研究子 Agent 和 Codex 自动继续执行的后续轮次。
漏掉的东西也值得看。两个 Ultra 档位的差异里,相当一部分是“一个常量功能开关,还是另一个开关的依赖”:Astra 找到了,Sol 漏了。
Roim 会把这类漏项变成下一轮提示词里的具体提醒,模型升级后,再检查提醒是否还有必要。
连写在 AGENTS.md 里的指令,也可以拿出来做一次对照,而不是越积越多。他还公开了这样一条提示词:
查看我最近的 Codex 会话,找出一条看起来误导了 Agent 或造成了多余工作的 AGENTS.md 指令。选取出现该问题时会话最初的提示词。从相同的仓库快照出发,使用相同模型,把这条提示词重放两次:
1. 保持当前 AGENTS.md 指令不变。
2. 只移除或修正这一条指令。
比较任务质量、Agent 行为、工具调用、token 用量、运行时间和费用。展示这条指令,并说明更新它是否有帮助。
他也碰到过收益不够、却让代码更复杂的建议。维护任务越铺越开,工程师仍要决定哪些值得做、哪些到此为止。
所以,Roim 建议从一个小任务开始:一段不用的代码、一个旧开关,或者一条 flaky 测试。先让 Codex 找出证据,准备一个小的草稿 PR;这轮确实有收益,再扩到一个子目录或范围清楚的项目。
参考链接
-
OpenAI:Maintaining software with the GPT-6 family:https://developers.openai.com/blog/maintaining-software-with-the-gpt-6-family -
Emanuele Di Pietro:Synara代码清理记录:https://x.com/emanueledpt/status/2096536898319601991