



编者摘要:最近 Supermemory 官宣关停旗下「企业大脑」商业产品,但带来一个惊喜 —— 将整套自研多人协同智能体运行框架 Company Brain 完整开源,支持 Cloudflare 一键部署,5 分钟即可搭建,所有数据由使用者自主保管。
市面上绝大多数 Slack AI 机器人,都是 “提问才回答” 的问答模式。而这套框架的核心理念,不是做一个应答 Bot,而是打造一名 AI 团队队友。它不会无脑插话,而是自主判断参与时机、收集上下文、遵守隐私边界,甚至能长时间执行复杂任务,只输出最小且高价值的干预动作。
整套架构基于 Cloudflare Agents SDK 搭建,核心是一套叫 Harness 的运行框架,作为包裹大模型的策略与运行层,串联交互、模型、存储与第三方工具。整体分为四层:Slack 交互层、Harness 运行框架、模型推理层、云基础设施层。
主动感知是最亮眼的设计。很多主动型 Agent 容易频繁刷屏打扰群聊,而 Company Brain 用小模型做多维度打分,评估消息的有用度、置信度、紧急程度、打断代价。评估后分出四种行为:完整回答、后台调研、仅发表情、保持静默。 调研模式尤其巧妙:后台检索记忆、工单、邮件等资料,如果没有有效信息,直接生成「静默结论」,不会在频道输出 “查完没有信息” 这类无效消息,避免污染对话。
框架内置一套分阶段状态机管理 Agent 会话。从工具组装、加载企业上下文、模型流式推理,到进度校验、异常补救、高风险审批,最后写入记忆完成闭环。同时引入步骤预算机制:临近步骤上限时收回工具权限,强制模型基于已有信息总结答案,解决 Agent 反复调用工具、迟迟不给结论的经典 bug。
多人并发场景是另一大亮点。Slack 对话是持续动态的,在 Agent 执行任务时,群内随时会新增消息。系统通过活跃会话网关,判断新消息是忽略、追加上下文、直接替换原有需求,还是终止正在运行的任务。 高风险操作采用断点式审批:触发审批时,会话状态序列化保存并暂停;审批通过后,同一个推理流程继续执行,保证推理因果连贯,而不是重新启动一轮新对话。
在记忆设计上,它没有把所有聊天一股脑灌入向量库(容易堆积过期信息干扰模型),而是做数据隔离:一边是持久化的企业知识库,存储项目、决策、历史信息;另一边是实时事务数据,读取工单、最新邮件等动态业务状态。记忆空间按频道隔离,公共频道、私信、私有频道拥有独立记忆容器,保障权限与隐私。
工具调用采用渐进式暴露策略。工具分组管理,沙箱、调度器等高能力工具默认隐藏,模型需要时才解锁,减少提示词上下文负担,避免无关工具干扰模型选择。
团队提出一个经典智能体价值公式:Agent 价值 =(有用性 × 正确性 × 时效性)/(噪音 × 风险 × 打断代价)。一条答案哪怕技术上正确,如果打断讨论、泄露隐私、重复人类发言,依然是一次糟糕的介入。
项目已在 Github 开源,支持一键部署到 Cloudflare。开发者可以自由修改、二次开发,快速搭建属于自己的企业多人协同智能体。
10 个关键问题Q&A
-
Q:Company Brain 是什么? A:Supermemory 开源的多人协同 Agent 运行框架(Harness),专门用于在 Slack 中构建 AI 队友,管理 Agent 的策略、记忆、权限、会话生命周期,底层依托 Cloudflare Agents。 -
Q:为什么 Supermemory 关停商业产品还要开源? A:商业产品下线,团队重心转向面向 Agent 的底层记忆 API;大量客户建议开源,因此释放整套工程实现,社区可自行部署使用。 -
Q:它和普通 Slack 机器人最大差别在哪? A:普通 Bot 被动应答;Company Brain 具备可控的主动感知,会自主评估该不该说话,支持后台静默调研、会话断点恢复、多人动态会话接管。 -
Q:什么是 Harness 运行框架,作用是什么? A:包裹大模型的运行时 + 策略层。模型只负责推理,Harness 管控路由、权限、记忆边界、工具调用、并发、故障恢复、审批流程。 -
Q:主动感知是如何避免 AI 乱插话刷屏? A:小模型输出多维度置信打分,评估打断代价;分为回答、调研、表情回应、静默四类动作,无价值调研结果直接静默,不输出文本。 -
Q:步骤预算机制解决了什么 Agent 痛点? A:防止 Agent 在最后一轮继续调用工具、永不输出结论;临近预算上限自动隐藏工具,强制模型基于已有信息总结答案。 -
Q:记忆层的核心设计思路是什么? A:持久企业语义记忆 和 实时业务事务数据分离;记忆按频道隔离,避免全部信息灌入向量库带来的陈旧信息干扰问题。 -
Q:多人并发网关解决了什么场景问题? A:Slack 对话动态变化,Agent 执行任务时,新消息可以追加上下文、替换需求或者终止任务,适配多人实时协同对话。 -
Q:高风险操作的审批流程有什么特点? A:会话暂停并保存完整检查点;审批通过后延续原有推理会话,保持因果连贯,不是重新发起一轮模型对话。 -
Q:部署门槛怎么样,数据归属如何? A:Cloudflare 一键部署,5 分钟完成搭建;所有数据保存在自己部署环境,不归第三方平台,适合企业私有化使用。
距离我们下线企业大脑运行框架,才过去两周。我们不得不把大量用户迁移到其他产品,但很多客户以及社区朋友都建议我们把企业大脑相关工作开源。
于是我们决定开源项目,你可以在这里使用:
https://github.com/supermemoryai/company-brain
一键部署到 Cloudflare,5 分钟以内就能完成搭建,所有数据归你所有。 https://deploy.workers.cloudflare.com/?url=https://github.com/supermemoryai/company-brain
在这篇文章里,我会聊聊这套架构,还有我们团队(主要是 @maheshthedev,大神)在这套运行框架上做的工作。这工程设计真的很棒,基于 Cloudflare Agents SDK 搭建,在权限管理、主动感知能力等细节上做了很多巧思!感谢 @threepointone 带来 Cloudflare Agents。
至于关停产品的原因,可以看下面这篇博文。一句话总结:我们希望打造全世界顶尖的智能体记忆系统,全力深耕这个方向。
Dhravya Shah @DhravyaShah ・ 我们将下线企业大脑与个人大脑产品,所有受影响用户都会获得退款。现在,我们将全部精力投入,持续打造面向智能体的前沿记忆 API。 Supermemory 更新公告
大约一个月前,我们上线了 Supermemory 企业大脑。投入了数月时间、大量人力与资金。上线后在 X 平台获得 50 万 + 曝光……
本文不是 AI 流水线生成的水文,篇幅会比较长 —— 我会把数月的研发沉淀,提炼成清晰的架构决策。全文由我亲手撰写,欢迎评论区反馈!这次不想只用枯燥文字,文中配有大量示意图和 ASCII 流程图,读起来会更轻松!
设计一名团队伙伴,而不是机器人
提到 Slack 机器人或智能体,大家的固有印象是:发送提示词 → 执行任务 → 返回结果。
而我们设计企业大脑,基于一套完全不同的理念:不只是简单给出答案,它要自主判断何时参与对话、收集合适上下文、在隐私边界内行动、执行超长时间任务,只在必要时给出精简、高价值的介入动作。
企业大脑运行框架(harness)是包裹大模型的运行时、策略层、记忆边界、工具系统与对话协议。它把原始大模型能力,转化成可靠团队伙伴的行为:被提问时及时响应、有选择性地主动介入、具备调研能力、该安静时保持沉默,基础设施故障时还能恢复执行。
运行框架整体体验
大模型本身可以做消息分类、调用工具、生成流畅回答,但它天生不知道这些问题: 这是一个多人协同智能体,所以要处理多人场景下的各类问题:
-
基于 Slack 事件实现主动感知(包括会议、笔记等信息都可以学习) -
机器人是否允许在该频道发言 -
某一块记忆存储空间是否可以检索 -
合适的审批与访问控制策略(发送邮件前是否需要审批?审批弹窗过多也会破坏体验) -
新消息是否替代了原有请求(请求转向等逻辑) -
模型输出的 “正在处理中” 是临时状态,还是最终答案 -
如果工具调用到一半运行实例消失,如何恢复任务 -
什么时候最该保持沉默,什么时候不该插嘴 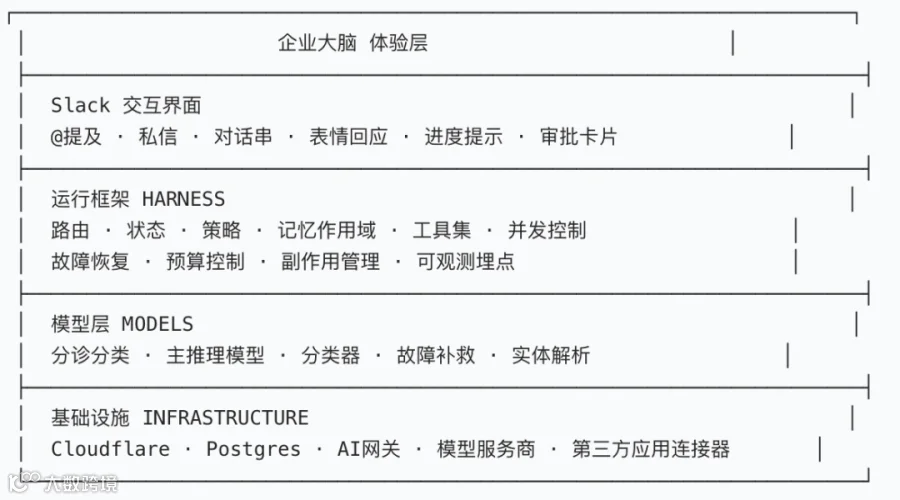
整体架构
整套系统完全基于 Cloudflare 搭建:团队熟悉这套平台,对我们和智能体来说开发体验极佳,并且拥有极强的扩缩容能力。直接使用 Agents SDK 就能开箱获得大量内置能力。
CompanyBrainAgent是核心主体,一个以组织 ID 作为主键的 Cloudflare Durable Object(持久对象)。它负责:
-
基于 Fiber 实现会话生命周期与故障恢复检查点 -
本地持久 SQL,存储活跃会话、收件队列、审批任务、机器人对话串、冷却策略、发布游标、追踪日志 -
解密机器人 Token 后,执行 Slack API 操作 -
消息分诊、主动感知判定、动作评估 -
主模型 / 工具调用循环 -
审批流程的暂停与恢复 -
计费与埋点任务调度
下面我们看,一条来自 Slack 的事件抵达后会发生什么。
事件分为几类:
- 显式触发
@提及、私信、助手对话串、唤醒呼叫 - 被动事件
频道内普通消息,允许智能体主动介入 - 仅上下文
对话信息需要留存,但 HTTP 路由层不做回复 - 忽略
机器人 / 自身消息、不支持的子事件类型、不符合条件的事件
基于事件,系统会做分类判断:
Slack消息
    │
    ├─ 是否是机器人/自身消息?────────────────────► 丢弃
    ├─ 是否为不支持的事件子类型?──────────────────► 丢弃
    ├─ 是否明显是发给其他人的?────────────────────► 仅保留上下文 / 丢弃
    ├─ 权限/订阅校验失败?────────────────────────► 提示通知 / 丢弃
    ├─ 仅表情的被动消息?──────────────────────────► 丢弃
    ├─ 频道设置静默、且非显式触发?────────────────► 丢弃
    ├─ 主动感知冷却期未结束?──────────────────────► 丢弃
    └─ 当前已有会话正在运行?──────────────────────► 请求转向网关
                                                      进入分诊判定
只在必要时开口
我们非常看重机器人介入带来的实际价值。市面上很多智能体都做了主动感知,但很多时候根本不该主动插话,很容易惹人厌烦!
具备主动感知能力的智能体,必须回答两个问题:
-
智能体做这件事,是否能产出有效价值? - 现在打断这场对话,是否合适?
最开始我们尝试用二元 “是 / 否” 判断主动触发,但很多场景并不是非黑即白。后来改成置信度打分模型,由小模型输出多项阈值分数:
消息 + 上下文
        │
        ▼
┌──────────────────────────┐
│ 分诊模型 Triage model    │
│ 评估场景状态              │
│                          │
│ 有用程度                 │
│ 置信度                   │
│ 紧急程度                 │
│ 噪音风险                 │
│ 打断代价                 │
│ 调研价值                 │
│ 表情适配度               │
└────────────┬─────────────┘
             │ 输出0–100各项分数
             ▼
┌──────────────────────────┐
│ 确定性评估器             │
│ 公式 + 模式策略          │
│ 显式消息规则             │
└────────────┬─────────────┘
             │
    ┌────────┼────────────────┬────────────────┐
    ▼        ▼                ▼                ▼
回答 ANSWER  调研 INVESTIGATE  确认 ACKNOWLEDGE  忽略 PASS
完整会话     工具校验          表情回应          保持沉默
评估器可以处理这类场景:
-
有价值,但置信度低 → 先调研,不直接回答 -
社交上适合回应,但没有实质信息 → 仅发表情 -
事情紧急,但直接回复会造成打扰 → 在更严格模式下后台调研 -
内容正确有用,但已经有人回答 → 不做任何动作 -
显式提问、内容轻量 → 简单确认,不启动完整推理会话
输出结果 = 核心动作 + 表情动作(Slack 表情)
-
核心动作:ANSWER 回答|INVESTIGATE 调研|PASS 不响应 -
表情动作:允许列表内表情|无表情
顺带一提表情能力:我们开源了 emoji-resolve 库,智能体可以随意使用表情,解析器自动处理。还能识别企业自定义表情,学习后直接调用。
由此实现 4 种自然交互行为:
-
回复消息,不发表情 -
发表情,不回复文字 -
发表情 + 回复 -
什么都不做
主动感知的配置
即便有这套逻辑,用户有时依然希望关闭频道内的主动能力。我们支持按频道单独配置。
@提及这类显式触发,几乎都会判定为回答。
显式消息
        ▼ 分诊模型
        │
        ├─ ACK确认 ───────────► 允许表情回应
        ├─ ANSWER回答 ────────► 启动完整会话
        ├─ INVESTIGATE调研 ───► 启动调研模式完整会话
        ├─ PASS忽略 ───────────► 强制转为ANSWER回答
        └─ 解析错误/异常 ─────► 降级为ANSWER回答
生成回答的完整流程
当分诊判定选择 ANSWER 或 INVESTIGATE,就开始生成回答。 这里就是运行框架的核心:带时间感知的分阶段状态机,按照人类预期节奏执行任务。
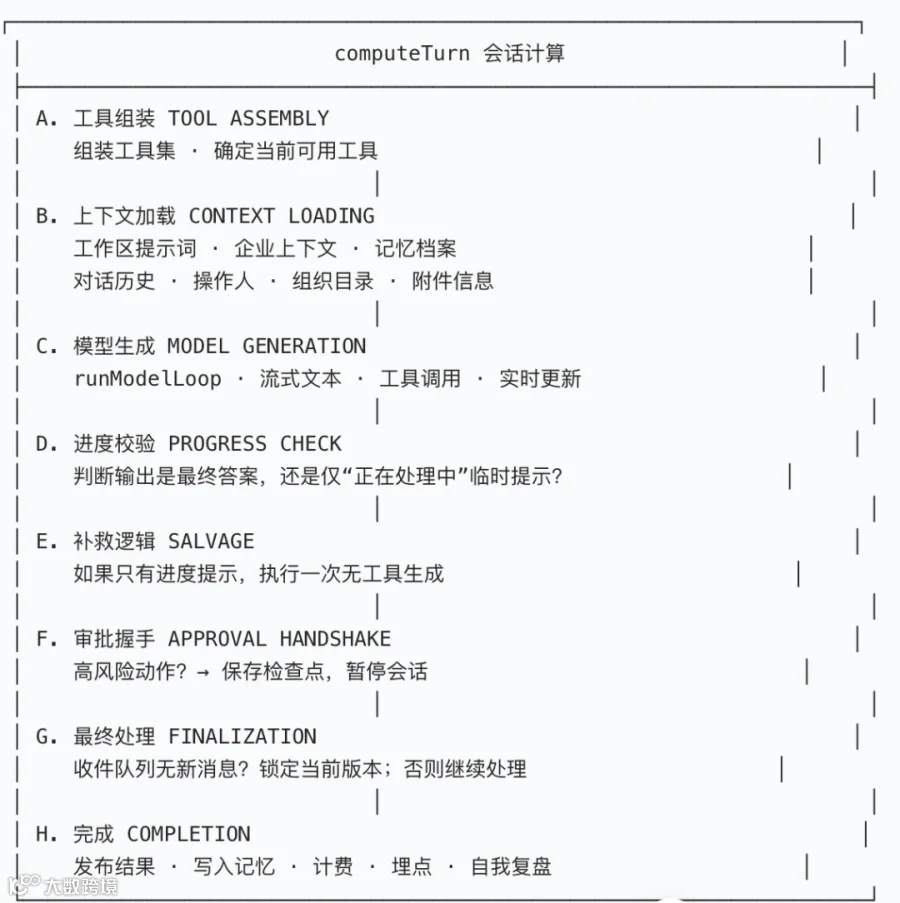
模型会持续向人类同步进度:“我找到了 XYZ,下一步我将处理 ABC。” 避免人类以为智能体卡死。
我们使用 AI SDK 的流式输出,并且通过 onBeforeStep钩子注入节奏控制。
runModelLoop
    │
    ├─ streamText({
    │    model: 主模型配置,
    │    system: 策略 + 工作区上下文,
    │    messages: 对话 + 会话状态,
    │    tools: 组装后的工具集合,
    │    activeTools: 当前可见工具名称,
    │    stopWhen: 达到步骤预算上限,
    │    abortSignal: 会话中断控制
    │  })
    │
    └─ 每一步 EACH STEP
          ├─ onBeforeStep
          │    ├─ 拉取对话队列新消息
          │    └─ 需要时推送进度提示
          │
          ├─ prepareStep
          │    ├─ 渲染最新会话状态
          │    └─ 收尾阶段隐藏工具
          │
          ├─ 模型输出
          │    ├─ 纯文本
          │    ├─ 工具调用
          │    └─ 文本 + 工具调用
          │
          ├─ 执行工具,追加返回结果
          ├─ 记录本轮步骤
          ├─ 距离上限剩3步:提示剩余预算
          └─ 距离上限剩1步:移除所有工具,强制输出最终文本
步骤预算是核心控制机制。
临近上限时,框架会告知模型剩余步数。到达边界,直接收回工具权限,模型只能基于已有信息总结答案。 解决一个常见故障:智能体在最后一步又发起新一轮检索,最终无法给出结论。
工具组装、渐进式暴露、代码模式
模型可以访问多类工具,但不需要一次性加载全部工具定义。
assembleTurnTools 组装会话工具
        │
┌───────┬────────┬────────┬────────┬────────┐
▼       ▼        ▼        ▼        ▼
┌──────┐ ┌──────┐ ┌──────┐ ┌──────┐ ┌──────┐
│记忆  │ │发现  │ │外部应用│ │Slack交互│ │副作用 │
│检索  │ │人员  │ │Gmail  │ │频道检索│ │保存  │
│查看  │ │实体  │ │GitHub │ │进度同步│ │连接  │
│解析  │ │组织树│ │Linear │        │ │遗忘  │
└──────┘ └──────┘ │Notion │ └──────┘ └──────┘
                  └──────┘
                      │
                      ▼
            ┌─────────────────┐
            │ 延迟加载工具组   │
            │ 沙箱环境         │
            │ 调度器           │
            │ 默认隐藏,      │
            │ 开启后才暴露    │
            └─────────────────┘
我们使用代码模式 + activeTools选择器实现这套逻辑。 activeTools控制每一步能看到哪些工具。沙箱、调度器这类工具,只有模型主动解锁对应工具组之后,才会暴露给模型。
带来三点收益:
-
降低上下文开销:更少工具描述占用提示词空间 -
工具选择更精准:无关工具不会干扰模型选择 -
策略管控:部分高级能力需要显式切换后才可启用
收尾阶段框架可以一次性移除全部工具,不用重新构建完整模型上下文。
记忆层:多人场景下,管控信息陈旧、知识学习等问题
这块实现难度不小。很多企业大脑类产品,会把所有内容全部灌入向量库。我们认为这种做法会堆积大量过期信息,严重干扰模型判断。
我们要严格区分持久化企业知识和 实时业务状态。
                  ┌────────────────────────┐
                  │       Agent 会话       │
                  └───────────┬────────────┘
                              │
              ┌───────────────┴────────────────┐
              ▼                                ▼
┌────────────────────────┐       ┌────────────────────────┐
 │ 企业大脑记忆层         │       │ 第三方连接应用          │
 │ 决策记录               │       │ 当前工单状态           │
 │ 归属信息               │       │ 最新邮件               │
 │ 项目上下文             │       │ 线上部署状态          │
 │ 历史知识               │       │ 近期Slack消息          │
 └────────────────────────┘       └────────────────────────┘
         持久 / 语义记忆                实时 / 事务性数据
一次会话,会先用记忆理解 “本次迁移” 这类指代,再调用 Linear 或 GitHub 校验当前真实状态。 如果把两类数据源混为一谈:要么记忆频繁变动不稳定,要么实时工具缺少上下文。
在记忆分层上,我们没有全部采用用户维度记忆,而是基于频道划分。 Supermemory 内部的容器标签规则:
-
公共频道: sm_org_shared组织共享 -
私信: user_{userId}用户私有 -
私有频道 / 多人私信: slack_channel_{channelId}
当然,记忆底层直接复用 Supermemory 本身的能力。
调研模式:回答前先取证
我们这套架构另一个亮点:智能体不只判断要不要回复,还可以选择调研(INVESTIGATE):
先调研,再决定要不要发言
INVESTIGATE 调研
    ▼ 收集证据:记忆 · Slack · 追踪日志 · 第三方应用
    ▼ 是否存在可行动、有价值的信息?
    │
    ├─ 有 → 整合信息并回复
    └─ 无 → silentConclusion 静默结论
               不发送Slack消息
               释放主动感知配额
这是环境智能(ambient intelligence)的关键。如果每一次后台检查都输出文字,机器人会刷屏,例如:“我检查完毕,没有找到任何信息。”
静默结论,让系统以产出价值为目标,而不是追求可见输出。
高风险工具的审批流程
模型请求高风险工具调用
        ▼
    审批分类器
        │
    ┌────┴────┐
    ▼         ▼
无需审批    需要审批
    │           │
  直接执行    保存待审批记录
                │
                ▼
         保存消息、工具状态、版本检查点
                │
                ▼
            发送【批准/拒绝】卡片
                │
          ┌─────┴─────┐
          ▼           ▼
        拒绝        批准
          │           │
        结束任务    resumeTurnAfterApproval 恢复会话
                      │
                      ▼
              沿用原模型循环,上下文完整保留
审批不会交给另一个独立智能体处理。当前会话暂停,状态序列化保存。审批通过后,同一个推理过程继续执行,同时记录本次审批决策。
保证因果连续性:发起动作的那个智能体,看到审批结果并继续完成工作。
多人并发处理
Slack 不是简单请求 - 响应模式。智能体工作的同时,对话串会持续新增消息。同事可以补充证据、修正前提、替换需求、要求智能体停止。
活跃会话里新增消息,会走活跃会话网关,而不是普通分诊流程。 新消息抵达正在运行的对话串:
新消息进入活跃会话
        ▼
    活跃会话网关模型
        │
┌────┬────┬──────┬────┐
▼    ▼    ▼      ▼
忽略 追加 替代请求 停止
无关 增加上下文 覆盖原有任务 终止任务
        │             │
        ▼             ▼
  持久收件队列      发送终止信号
        │
  下一步执行前,先读取队列更新
        │
  <live_thread_updates> 注入到会话
运行框架为什么这么复杂?
你大概率会觉得这套框架太重了。但这些复杂度是必要的。
和 Pi、OpenCode、Codex 这类运行框架不一样,我们不能简单粗暴地把所有逻辑丢进模型。面向大型企业使用,确定性是硬性要求:权限、工具调用等都必须可控。而且我们不想只做问答机器人,那太简单无趣;实现真正的多人协同智能体,本身就充满挑战。
产品层面考量
我们要保证用户不用担心智能体做出损害公司的行为。记忆调用、工具使用、访问权限、审批流程,全部可控,可以根据客户需求调整。
我们的优化目标,不只是回答质量。核心目标是作为一名员工所能创造的价值。
\(Agent\ value=\frac{有用性 × 正确性 × 时效性}{噪音 × 风险 × 打断代价}\)
一条技术上正确的回答,依然可能是一次糟糕介入:出现在错误频道、泄露私密上下文、重复人类已说内容、打断敏感讨论、无视最新消息。
这套系统不只回答:我该说什么?还会持续自问:
-
我是否应该发言? -
是否需要先调研取证? -
简单发表情是否足够? -
适用哪一套信息边界? -
用户需求是否已经变更? -
是否需要申请审批? -
任务能否可靠收尾?
这就是单纯把大模型接入 Slack,和打造 AI 团队伙伴的本质区别!
补充要点(便于快速阅读)
-
项目背景:Supermemory 关停「企业大脑」商业产品,将整套多人 Agent 运行框架开源,一键部署 Cloudflare,数据自托管 -
核心定位:不是问答 Bot,是AI 队友,核心能力:选择性主动发言、后台静默调研、会话可中断恢复、精细化权限审批 -
核心技术亮点 -
分诊模型打分,评估「该不该插嘴」,控制主动感知,避免骚扰 -
分阶段状态机会话,步骤预算限制防止无限工具调用 -
工具渐进式暴露,按需加载工具定义,减少上下文消耗 -
记忆分层:持久企业语义记忆 + 第三方应用实时事务数据分离 -
多人并发网关:新消息可以追加上下文、替换原有任务、直接终止正在运行的 Agent 会话 -
关键公式:智能体价值 =(有用 × 正确 × 时效)/(噪音 × 风险 × 打断成本)