


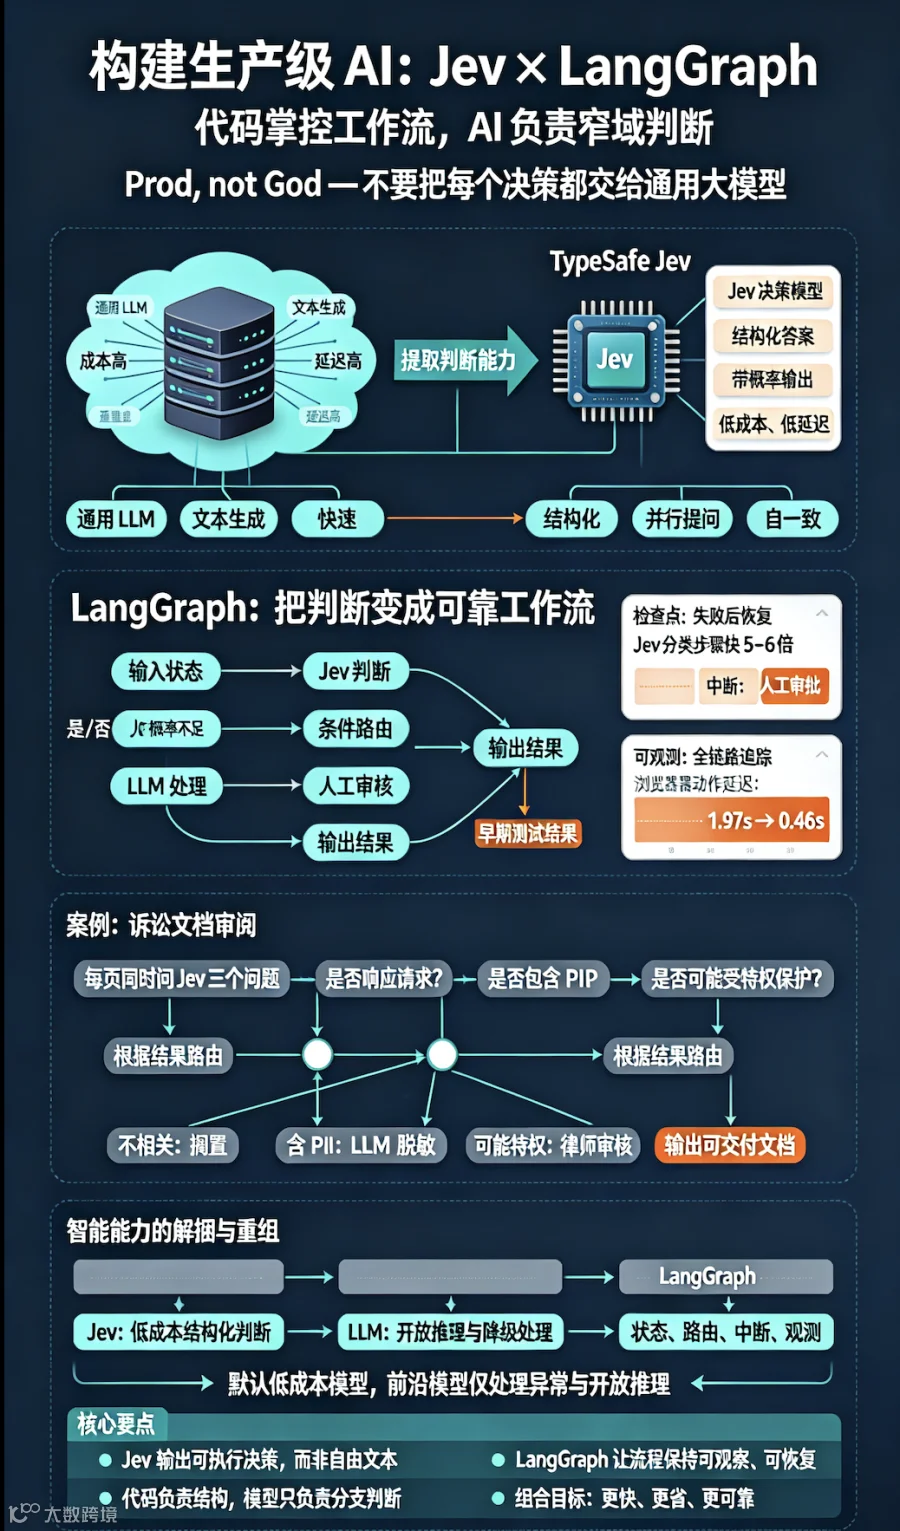
编者摘要:本文介绍 Typesafe 的决策模型 Jev 与 LangGraph 的联合生产级 AI 架构,核心理念为 Prod, not god(生产优先,拒绝万能大模型)。Jev 属于 System One 决策模型,不生成文本,直接输出带概率的结构化判断,专门承接分类、路由这类窄域语义任务,具备高速、低成本、结果稳定、可并行查询的特点,规避传统 LLM 非确定性、昂贵缓慢的短板。
LangGraph 承担智能体编排工作,以状态、节点、边构建工作流,提供持久化断点、人在回路中断、LangSmith 全链路可观测能力,保障系统可靠运行。整体架构遵循:代码掌控主工作流,仅在需要语义判断的节点调用模型;优先由 Jev 完成置信度高的有限选择任务,遇到不确定、开放式推理场景再降级调用通用 LLM。
文中以法律诉讼文档审阅、浏览器自动化智能体为例验证效果:文档分类速度提升 5–6 倍,浏览器动作延迟下降约 4.3 倍。文章提出行业趋势 ——智能能力解捆(The Great Unbundling of Intelligence):把大模型能力拆分,不同任务匹配最低成本专用模型,由编排框架统一调度。

10 个关键 问题Q&A
- Jev 是什么模型?
Jev 是 Typesafe 推出的 System One 决策模型,不生成文本,输出带概率的结构化判断,专门处理有限选项的语义决策任务。 - Prod, not god 是什么含义?
生产优先,不把 LLM 当成万能工具;由代码掌控整体流程,模型仅用于需要语义判断的分支。 - Jev 对比传统 LLM 最大优势?
速度更快、成本更低,相同输入多次调用结果稳定,解决 LLM 输出不确定性问题。 - Jev 不能做什么?
不擅长开放式长文本生成、复杂开放推理;置信不足场景需要回退给通用 LLM。 - LangGraph 在这套架构里承担什么角色?
编排运行时,管理状态流转、路由分支,提供断点恢复、人在回路、链路观测等生产级能力。 - LangGraph 的三大基础构成?
节点(执行单元)、状态(全局上下文)、边(路由逻辑),子图可复用嵌套。 - 什么是 “智能能力解捆(The Great Unbundling of Intelligence)”?
将大模型的复合能力拆解,每项任务交给成本最低、适配的专用模型,编排框架统一调度。 - 法律文档审阅案例的工作流程?
Jev 并行判断文档相关性、PII、保密特权;相关含 PII 则 LLM 脱敏;特权文档进入人工律师审核。 - Jev+Stagehand 浏览器智能体的性能提升?
动作中位延迟由 1.97s 降至 0.46s,提速约 4.3 倍;置信低于 0.7 时自动切回 LLM。 - 这套新架构的范式转变是什么?
从「默认上最强大模型,后续优化」转变为「默认低成本决策模型,异常场景启用前沿 LLM」。
原文:Building Prod with Jev and LangGraph
上周,Typesafe.ai 发布了一款全新模型 Jev。和传统大语言模型不同,Jev 不生成文本;它直接产出可供代码执行的决策结果,也就是 Typesafe 所说的第一系统模型(System One),其核心理念:由代码掌控工作流,AI 只负责范围受限、结构化的判断任务。Typesafe 在宣言中将这套理念总结为:生产优先,而非万能大模型(prod, not god)。
前沿大模型能力越来越强,于是我们开始把它们当成万能神器,不管什么模糊输入任务都丢给它:写文稿、文档抽取、检索、排序、调研、分类等等。但问题在于,“万能” 代价高昂且速度缓慢。哪怕你只需要一个简单的是 / 否答案,每一次调用都要为这种通用能力付费。
这也是 Jev 一经发布就备受关注的原因。在路由、分类这类智能体最常用的窄域决策任务上,Typesafe 的基准测试显示,Jev 的速度远超主流大模型。
在 LangChain 团队看来,Typesafe 的思路有种复古的味道。LangChain 的使命是让智能体变得实用、普及。我们的开源生态随着模型格局不断迭代,但始终在追问两个核心问题:如何让模型做出有价值的判断?如何可靠地执行这些判断?
LangGraph就是我们对这两个问题的答案。它是在帮助数千家企业落地 AI 生产项目的经验之上构建而成,能够把模型驱动的判断和确定性代码组合成一套可稳定运行、可观测的系统。而 Jev,给这类系统提供了一种更快、更便宜的决策能力。本文将介绍如何用 Jev + LangGraph 落地「生产优先,而非万能大模型」架构。
Jev:专门做判断的模型
Jev 从通用大模型庞大能力包里剥离出一项能力:判断力(judgment),并把它做成一种成本极低的基础组件,也就是 Typesafe 所称的第一系统模型(System One Model),也常被称为决策模型。 你输入状态信息与一组问题,它返回带概率的强类型结构化答案。
Typesafe 的文档提出了三种软件构建范式:
-
传统软件:显式硬编码逻辑,每一条分支都人工编写、可审计,但十分僵化。 -
传统智能体:走向另一个极端,由单个模型处理每一步决策,控制流从代码转移到提示词中。 -
AI 赋能软件:走中间路线。代码保留整体流程结构,负责精确计算;模型只放在需要语义判断的分支节点上。
Jev 具备几个适合生产环境的核心特性:
- 结构化输出
返回带概率的类型化结果,代码可以稳定地根据结果分支跳转; - 并行能力
可以基于同一套状态一次性提出多个问题; - 极快
单次决策成本极低,单轮流程内可以执行大量判断; - 自一致性
对相同输入,多次评估能给出稳定答案。
💡 Jev 的一致性,完美解决传统大模型的不确定性问题。同样问题多次调用 LLM,结果可能不一样。而 Jev 被设计为相同输入稳定输出。LangSmith 早期评测显示,在 100 次重复运行中,Jev 的分数几乎没有波动,稳定性远超我们测试过的任何 LLM 评测裁判。
举个例子:视频演示直观展示 Jev 与 LLM 的差异,任务是判断输入文本是否包含各类个人敏感信息 PII。
真实业务场景里往往需要大量决策,并且每一项判断都和前面结果强关联。当决策成本足够低时,瓶颈就变成编排调度,而这正是 LangGraph 的定位。
LangGraph:负责智能体编排
多年来我们帮助团队基于大模型搭建系统,几乎所有人都会遇到两大难题:
- 上下文管理很难
模型要做出正确判断,上下文窗口必须带上全部相关状态。这些信息本身是模糊的,并且会随着应用运行持续变化。 - 模型驱动系统必须保证可靠性
需要容忍故障、支持人工介入,每一步都可观测。
已有框架只能解决部分问题,要么受限,要么无法兼顾两者。于是我们开发了 LangGraph。目前它月下载量超 6000 万次,大量财富 500 强企业在 AI 项目中使用。
状态即上下文
LangGraph 应用由三部分构成:
- 节点(Nodes)
执行单元,可以是普通代码、模型调用、工具调用,甚至一整个子图; - 状态(State)
节点读取、更新的全部信息; - 边(Edges)
决定下一个运行节点,可以是固定路径,也可以基于当前状态动态路由。
任意一张子图,都可以作为更大图里的一个节点。小型、经过验证的组件可以组合成复杂系统。Typesafe 的宣言也秉持同样理念:可读、小型的基础原语,才可以让复杂系统保持可信。
图在执行时,每一步结果都会累积存入状态。这份状态既是后续步骤的上下文,也决定下一个要执行的节点。
你不再是把所有逻辑一股脑丢给模型,而是显式定义:哪些决策需要做、执行顺序、每项决策能看到哪些状态。也就是 Typesafe 所说,让软件基于意图和常识做分支判断。语义判断交给模型,但整体流程保留在可审查、可测试的代码中。
可靠的运行时
正如 Typesafe 宣言提到:一个组件只有在足够可靠之后,才能无人值守运行;只有能够审查、测试、约束它,才能在它之上继续构建。LangGraph 在运行时层面提供这套保障:
- 持久化检查点(Durable Execution)
模型步骤具备不确定性,同样输入可能触发不同调用、走向不同分支。故障后从头重跑风险很高,二次运行可能不会复现原来路径。检查点会在每一步持久化状态,任务失败后,可以从已经完成的决策点继续恢复执行。 - 中断机制(Interrupts)
某一步操作需要人工审核时,可以暂停流程、等待审批,之后继续执行。 - 可观测性
模型驱动步骤每次行为可能不一样,你可以在 LangSmith 链路追踪中查看每一项决策及其背后原因。
这套能力并非 LLM 专属。Jev 同样接收非结构化文本上下文并返回判断,因此它也需要这些运行保障;LangGraph 会自动为图里的每一个节点提供这些能力。
案例:诉讼文档审阅(证据开示场景)
在法律诉讼中,企业在向对方提交文档前,必须逐页审核。单个案件可能涉及几十万页文档。绝大多数审核工作,都是反复执行同一类有限范围的判断任务,非常适合 Jev。
对每一页文档,Jev 在一次请求中回答 3 个问题,每个结果对应图里一条路由分支:
-
该页面是否响应取证请求?不相关则直接搁置。 -
是否包含个人敏感信息 PII?如果有,则调用 LLM 做信息脱敏。 -
是否属于受保护保密资料?若是,流转至律师审核节点,暂停图流程,人工介入。
剩下的文档即可直接交付。演示视频展示完整流程(实际工程中页面会并行处理)。
分类判断全部交给 Jev,只有需要进一步处理时,图才向上流转:交给 LLM 做脱敏,或交给律师判断保密特权。
我们在 LangSmith 上做了对照实验:Jev 在分类环节速度提升 5~6 倍。两次运行都有完整追踪记录,你可以打开任意页面,查看它走了哪条分支、决策背后的概率。LangSmith 还专门提供面向 Jev 这类决策模型的视图,展示每一次决策的输入与校准后的输出。
智能能力的大拆解(The Great Unbundling of Intelligence)
过去三年,绝大多数智能体的做法:所有任务都经过同一个前沿大模型。 Jaya Gupta 提出,接下来会迎来智能能力的大拆解:把大模型的各项能力拆分,每一项能力交给能胜任它、成本最低的专用模型。 Jev 剥离出「判断能力」,输出结构化决策,而非生成文本。能力拆分之后,就需要一个运行时框架把各组件重新缝合:路由每一步、决定何时升级到大模型。这就是编排运行时的工作。
浏览器自动化是很好的实例。浏览器智能体读取页面,决定下一步操作:点击按钮、填写表单、滚动页面。看似开放任务,但任意时刻页面上可交互元素是有限集合,下一步动作本质就是从候选列表里做选择。
Browserbase 的 Stagehand 就是基于这套思路:标记页面可交互元素,Jev 选择动作类型和目标元素;置信度低于 0.7 阈值,则降级回退给 LLM。早期测试中,act () 操作的中位延迟从 1.97 秒降到 0.46 秒,提速约 4.3 倍。
对大多数场景来说,Jev 并不是完全替代 LLM。它处理选择空间有限、自身置信度高的判断;不确定、开放式推理的场景交给大模型。也就是 Gupta 描述的范式转变:从默认上最强前沿大模型,后续再优化,转向默认低成本模型,异常场景才启用前沿大模型。我们会越来越多地看到这种架构:约束动作空间的场景,使用决策模型快速低成本调用;开放推理、模型不确定的场景,保留 LLM。
开发者已经在向这个方向迁移。正如一位开发者本周所说:“我现在正在把我们所有智能体,全部改造成由 Jev 驱动的工作流。”
上手资源
-
阅读 LangGraph 运行时介绍:《三年 LangGraph 图工程实践》 -
了解如何将 Jev 接入智能体框架,含模型路由、自动分类器:《基于 Jev 搭建智能体框架》 -
使用 LangSmith 观测与评估智能体
致谢
作者:Sydney Runkle、Hunt Lovell 感谢 Kevin BFrank、hwchase17、veryboldbagel、ndrezn 的审阅与建议。