发表期刊:bioRxiv
研究领域:虚拟细胞、扰动响应预测、Perturb-seq、单细胞建模、跨细胞背景泛化、生物知识融合、功能基因组学
ML/DL方法:erceiver IO、交叉注意力、潜在空间自注意力、文本嵌入、多源知识融合、群体层面效应预测、多任务学习、Shapley 贡献分析
文章创新:提出Perturbation is Everything,将扰动预测的学习目标聚焦于群体层面的差异表达与表达变化,同时整合生物学知识、对照表达和训练集中的扰动响应统计,预测新细胞背景、新扰动及新数据集中的转录组效应。
1
研究背景:虚拟细胞真正困难的,是预测没有测过的条件
如果敲低一个基因,哪些下游基因会发生变化?如果细胞背景和扰动都没有在训练数据中出现,模型还能给出有用的预测吗?这些问题决定了虚拟细胞模型能否帮助研究者设计新实验。现实中的扰动数据远远覆盖不了所有可能的组合。不同细胞类型、疾病状态、药物、基因干预和剂量相互组合,会产生巨大的实验空间。模型必须从已经测量的条件中学习,再将规律迁移到尚未测量的条件。
这一任务存在两方面困难。首先,转录组并不能完整描述生物系统。一个基因参与什么通路、编码什么蛋白质、与哪些蛋白相互作用,以及一个细胞系具有怎样的背景,都可能影响扰动响应。其次,单细胞扰动效应难以直接测量。常规单细胞 RNA 测序具有破坏性,研究者无法同时获得同一个细胞在干预前后的完整转录组。不少模型尝试预测扰动后的单细胞表达谱,最终却仍通过群体层面的差异基因、变化方向和效应强度接受评价。PIE 因此提出两个相互配合的调整:
直接学习实验能够支持的群体扰动效应,并用已有生物学知识补充对细胞背景和扰动的描述。
2
核心技术
核心技术一:以“细胞背景 × 扰动”作为学习样本

PIE 的一个样本,是一个具体的实验条件:在某种细胞背景中,施加某个扰动。这里的细胞背景可以是细胞系,也可以包含细胞因子刺激等状态;扰动则可以是基因 CRISPRi 敲低,或特定剂量的小分子处理。模型针对每个被测基因输出三类结果:
是否差异表达:预测该基因成为差异表达基因的概率;
变化方向与倍数:预测带正负号的 log fold change,反映上调或下调及其幅度;
平均表达变化:预测群体平均表达变化所在的数值区间。
三个输出头分别学习对应目标,再联合优化。这一设计缩小了需要预测的结果空间,也让训练目标更贴近研究者分析扰动筛选时实际关注的读数。相应地,PIE 的输出主要描述群体效应。
核心技术二:为细胞与扰动接入多种生物学知识
预测一个未见过的扰动,首先需要知道这个扰动是什么。PIE 为不同对象引入不同的信息来源:
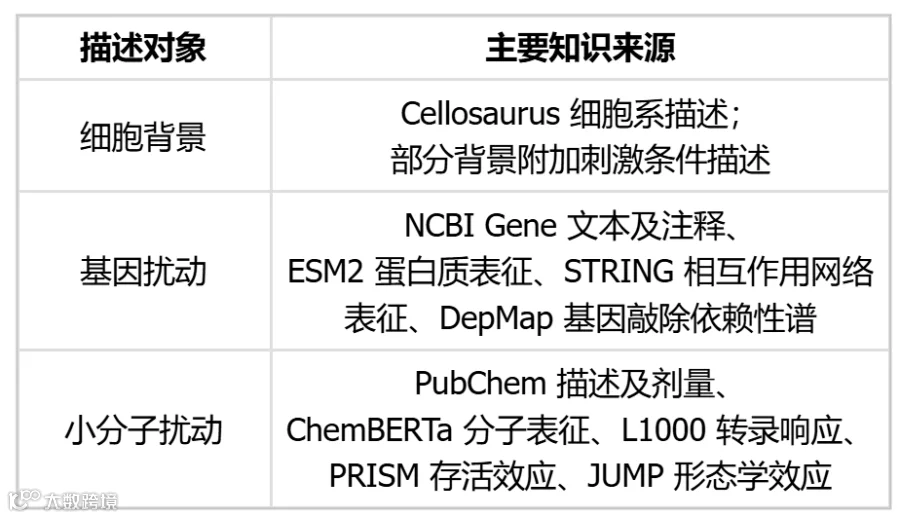
这些输入同时包含文本、序列、网络以及其他实验积累的证据。因此,PIE 使用的“知识”具有多种形式。不同知识源的覆盖率也不同。有些基因或药物缺少某类记录,模型就省略这一来源对应的输入。这使 PIE 可以在不同扰动类型、不同知识覆盖条件下使用共同的建模框架。
核心技术三:把已有实验结果组织成逐基因证据
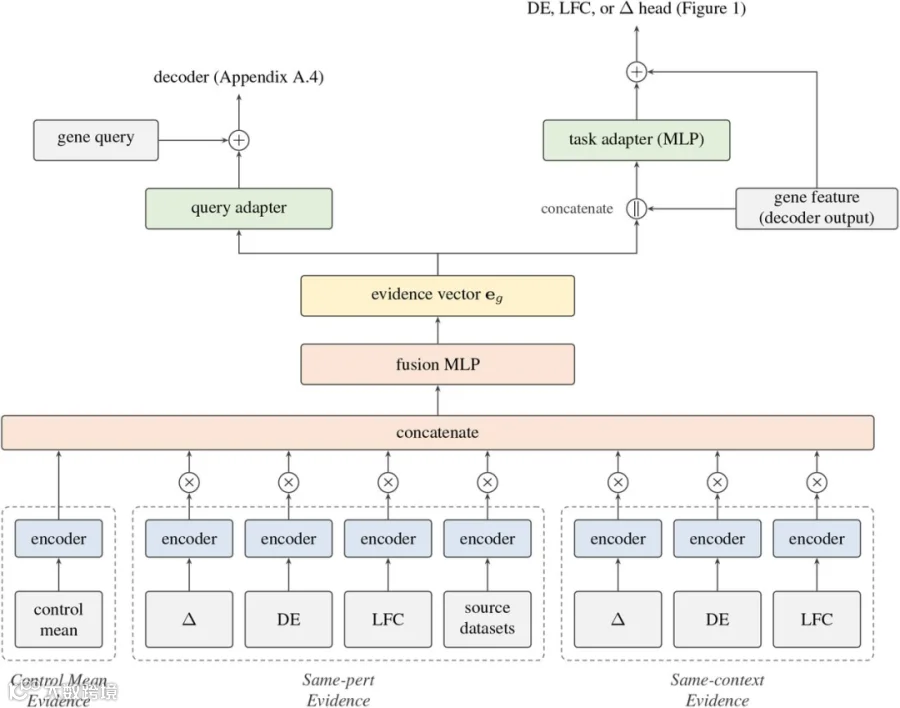
外部知识描述了细胞与扰动的性质,但模型还需要知道:某个输出基因通常如何响应。为此,PIE 为每个基因构建三类实验信息。对照表达证据告诉模型,这个基因在目标背景的未扰动细胞中平均表达水平是多少。相同扰动证据总结同一种扰动在其他训练背景中,对这个基因造成的变化。相同背景证据总结目标背景中,其他训练扰动对这个基因造成的变化。遇到未见细胞背景时,相同背景证据不可用;遇到未见扰动时,相同扰动证据不可用;相应通道会被置空。这里也需要明确:未见细胞背景的扰动响应,不等于完全没有目标背景的信息。 测试时,模型仍然可以获得目标背景的未扰动对照细胞。
核心技术四:用Perceiver IO融合可变输入,按基因解码
PIE 采用 Perceiver IO 的“编码—处理—解码”结构。编码阶段,一组可学习的潜在向量通过交叉注意力读取不同知识源。处理阶段,潜在向量之间通过自注意力交换信息。解码阶段,每个待预测基因构建自己的查询,读取潜在表示,生成该基因的预测特征。基因查询结合了 NCBI Gene 描述的文本嵌入与前面整理的实验统计证据。由于查询来自基因描述,模型可以适应不同数据集的基因集合,并支持对训练中未出现的输出基因进行预测。这为跨数据集学习提供了便利。
3
核心成果
核心成果一:在三种泛化任务中检验预测能力

主要评估使用 Replogle–Nadig CRISPRi Perturb-seq 数据,覆盖 K562、RPE1、HepG2 和 Jurkat 四个细胞系。研究者设置四折实验,每次留出一个细胞系,并在其余细胞系中留出部分扰动,从而分别检验:
已知扰动在新细胞背景中的响应;
新扰动在已知细胞背景中的响应;
新扰动在新细胞背景中的响应。
每折训练一个 PIE 模型,使用同一个选定检查点评估三种任务,测试时不更新参数。在差异表达基因预测 AUPRC 上,结果如下:

其中,未见扰动任务的 AUPRC 达到最强基线的约 3.2 倍;双重未见任务约为均值基线的 2.7 倍。它展示了 PIE 的适用范围及预测信号,尚不能证明 PIE 已在这一任务中全面战胜所有可能的方法。PIE 也并非所有指标都排名第一。在未见细胞背景任务中,它在六项指标中领先五项;效应强度的 Spearman 相关性为 0.734,略低于 Rhaister-O 的 0.741。在未见扰动任务中,PIE 则在六项指标上均取得最高得分。
核心成果二:跨越数据集边界,仍保留预测信号

跨细胞系预测,还不能覆盖真实研究中遇到的全部差异。新研究可能使用不同的测量流程、基因集合和扰动设计。研究者因此进一步测试跨数据集迁移。模型在四类数据上训练:
Tahoe-100M 小分子扰动数据;
Jiang 等人的细胞因子刺激背景下 CRISPRi 数据;
X-Atlas/Orion CRISPRi 数据;
Arc 2025 Virtual Cell Challenge 的 H1 细胞数据。
随后,模型直接预测未参与训练的 Replogle–Nadig 数据。研究者还从训练集中移除了与目标数据共享的细胞系及其衍生细胞系,使测试同时涉及新数据集和新细胞背景。对于训练中出现过的扰动,PIE 的 AUPRC 为 0.378,高于最强基线 Rhaister-O 的 0.283,并在六项指标中领先五项。当扰动也未出现过时,任务进一步变成“新数据集、新背景、新扰动”的同时迁移。PIE 的 AUPRC 为 0.252,高于 context mean 的 0.102。这些结果说明,PIE 学到的预测能力可以跨越部分实验边界。但随着未见条件增加,性能仍明显下降。
核心成果三:知识是否有用,取决于预测什么
PIE 最值得仔细阅读的一部分,是输入贡献分析。针对不同输入组合重新训练模型,再用 Shapley 值分析每类信息的平均边际贡献。结果显示,不同任务依赖的信息并不相同。对于未见细胞背景,已有的相同扰动响应非常重要。同一种干预在其他背景中的实验结果,加上扰动知识,解释了大部分差异基因预测增益。对于未见扰动,外部知识尤其有助于区分不同干预。
逐来源分析中,DepMap 对未见扰动任务的 AUPRC 贡献最大。对于双重未见,增加知识并没有显著提高所有指标。在这一设置下,扰动知识对 AUPRC 的平均贡献很小,甚至略为负值;但它仍改善了变化方向、fold change 相关性和扰动区分能力。
这意味着,不同知识提供不同信号,其价值需要结合泛化任务和生物学指标判断。
4
文章创新
第一,将训练目标直接对齐群体扰动效应。 模型围绕差异表达、变化方向和平均表达变化学习,减少了对难以直接验证的个体细胞响应的依赖。
第二,在共同框架中融合多种知识与实验统计。 细胞背景、扰动性质、对照表达和已有响应共同参与预测。
第三,适应缺失知识源与不同基因集合。 可变输入和基于文本构建的基因查询,为跨数据集应用提供了结构基础。
第四,系统检验多条泛化轴。 评估同时覆盖新背景、新扰动、新数据集及其组合,明确了不同预测任务的难度。
第五,通过消融解释信息来源的实际贡献。 结果揭示,提升差异基因排序与提升响应方向、幅度和特异性,可能依赖不同信息。
PIE 展示了利用已有知识和实验数据预测新条件的一条路线,但目前仍是群体转录组效应模型。对于效应较弱的扰动,真实变化与实验噪声仍然难以区分;当背景与扰动同时未见时,预测能力也会下降。此外,“未见”是相对于模型训练所用的扰动响应而言。某个目标可能已经存在功能注释、依赖性实验或其他数据库记录。因此,这类结果体现的是利用可用先验预测未测条件的能力,需要结合知识源覆盖情况解释。
PIE 带来的启示是,虚拟细胞研究可以同时改进三个环节:更准确地定义预测目标,更充分地描述生物系统,以及更严格地检验模型能否处理新条件。
基于文章中所使用的先进技术,包括深度学习,联川生物为您提供最前沿的生物分析解决方案。联川生物的专业团队将这些先进技术与丰富的经验相结合,为您提供高效、精准的服务。无论您的需求是基础研究还是临床诊断,我们都能够为您提供量身定制的解决方案。选择联川生物,让您的研究获得最新科技的支持,开创更广阔的科学道路。
论文链接:https://doi.org/10.64898/2026.10.02.756297
代码与数据:https://github.com/ArcInstitute/pie.git 官方解读:PIE: A model that draws on curated biological knowledge to predict responses in unseen conditions | Arc Institute
模型、处理后数据与知识源:PIE - a arcinstitute Collection