

让AI实现递归自我改进(RSI),一定要重新训练模型、修改模型参数吗?
华为诺亚方舟实验室联合伦敦大学学院、利物浦大学最新提出的AI智能体系统MEMENTO 3给出了另一条路线,不改变大模型本身,让AI在与环境交互的过程中,自主学习规则、编写代码、验证预测,并不断修正自己的世界模型。

在ARC-AGI-3的25款公开游戏中,MEMENTO 3通关全部183个关卡,平均相对人类动作效率(RHAE)达到满分100,实际使用的动作次数仅为人类基准的44%。
研究团队还将该机制应用到经典Atari游戏《Pong》(乒乓球)中。经过自主探索和学习,MEMENTO 3逐步学习游戏规则,并生成了一套控制器,在三场不同开局的测试中全部以21:0获胜。
更关键的是,在Pong的最终测试阶段,控制器无需继续调用大语言模型,就能根据已经学到的世界模型独立行动。整个过程中,底层大模型的参数始终保持冻结,持续进化的是AI保存在外部的规则知识与可执行世界模型。
01
不训练大模型,让AI自己
学会世界规则
过去,我们希望提升AI Agent的能力,通常会想到更换更强的大模型、优化Prompt、增加工具,或者通过强化学习更新模型参数。
但这些方法并没有完全解决AI进入完全陌生的环境时,它能否像人一样,通过观察和试错,逐渐摸清世界的运行规律?
比如,给AI一个从没玩过的游戏。它不知道方向键有什么作用,也不知道地图上的特殊方块意味着什么,更不知道通关需要满足哪些条件。
传统做法可能是不断尝试,记录哪些操作有效,再根据过去的成功经验选择下一步行动。
MEMENTO 3则希望AI更进一步,不仅记住哪些操作有用,还要弄明白这些操作为什么有效。
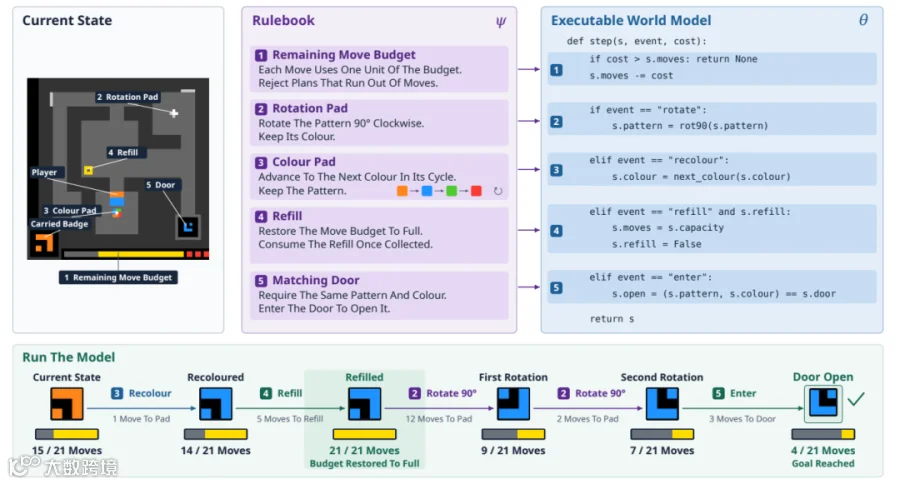
假设游戏中存在一种机关,角色进入后,身上携带的图案会发生变化。AI第一次观察时,可能认为图案发生了左右翻转。
但随后它发现,从另一个方向进入机关,图案依然按照固定方向旋转。
这时,AI就需要推翻原有假设,形成新的规则,每次进入机关,图案都会顺时针旋转90度,与进入方向无关。
MEMENTO 3希望AI学会的,正是这种从经验中发现规律、修正规律,再利用规律指导未来行动的能力。
为此,研究团队提出了一个核心设计Code as Model(代码即模型)。
它将AI对环境的理解拆分成两个部分。
一个是自然语言编写的规则手册(Rulebook),记录当前对环境机制的理解;
另一个是根据这些规则生成的可执行代码,用来模拟环境变化、预测行动结果和规划路线。
相当于AI给自己准备了一本可以随时修改的游戏攻略,以及一个可以提前模拟操作的游戏引擎。
遇到陌生情况时,AI不必完全依赖即时猜测,可以先在自己构建的世界模型里推演,再决定实际执行什么操作。
需要注意的是,这项研究并不是训练出了一个名为MEMENTO 3的新基础模型,它是在已有大模型之上建立了一套能够持续更新外部世界模型的Agent系统。
02
五步循环,让Agent持续修正
自己的世界模型
MEMENTO 3的核心是一套持续运行的反思学习机制。
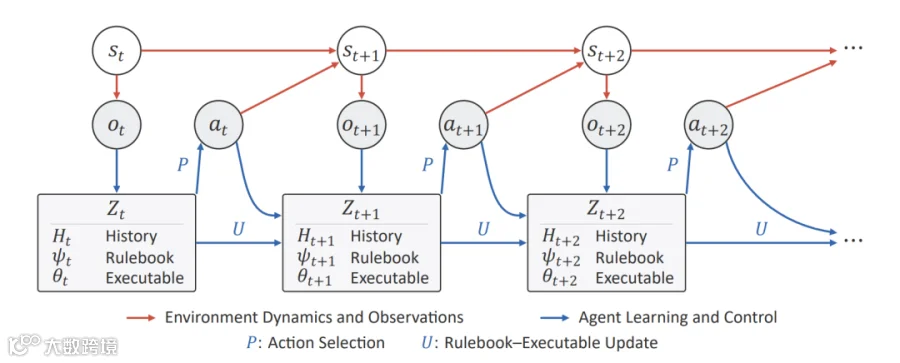
图注:Code as Model 中RSI的示意图。从整体上看,MEMENTO 3形成了一个持续运转的学习闭环。Agent每执行一次动作,都会获得新的环境反馈,并将其加入交互历史,用于更新自然语言规则手册和可执行世界模型。更新后的世界模型又会指导下一步行动,如此循环,让Agent在与环境交互的过程中持续改进。
整个流程包括五个环节:观察、反思、规则修订、代码编译、验证。
首先是观察。AI对环境执行一个动作,记录动作前后的画面变化,并将这些信息保存在交互历史中。
接下来进入反思阶段。AI会把实际观察到的结果,与当前世界模型预测的结果进行比较。
如果两者不一致,就需要判断问题出在哪里:究竟是自己理解的规则错了,还是代码没有正确实现规则?
如果是规则理解错误,AI就修改自然语言规则手册;如果只是代码实现有问题,则可以保留规则,只修复程序。
随后,AI根据规则手册生成或修改可执行代码,让新的世界模型能够模拟环境中的状态变化。
但这里还有一个关键环节,AI不能仅仅因为自己觉得规则合理,就直接采用新模型。
MEMENTO 3设置了双重验证。
一方面,由大模型检查代码是否忠实实现了规则手册中的描述。
另一方面,系统会用新代码重新执行此前记录过的动作,检查它能否准确重现每一次真实观察。
在ARC-AGI-3实验中,这意味着预测结果必须与真实画面的64×64网格逐格一致。
只有通过验证,新规则和代码才会被接受,用于下一轮规划。
如果验证失败,就重新反思、修改和测试。
这个过程形成了一个持续循环:观察环境 → 反思预测偏差 → 修订规则 → 编译代码 → 验证模型 → 再利用更新后的模型继续规划和探索。
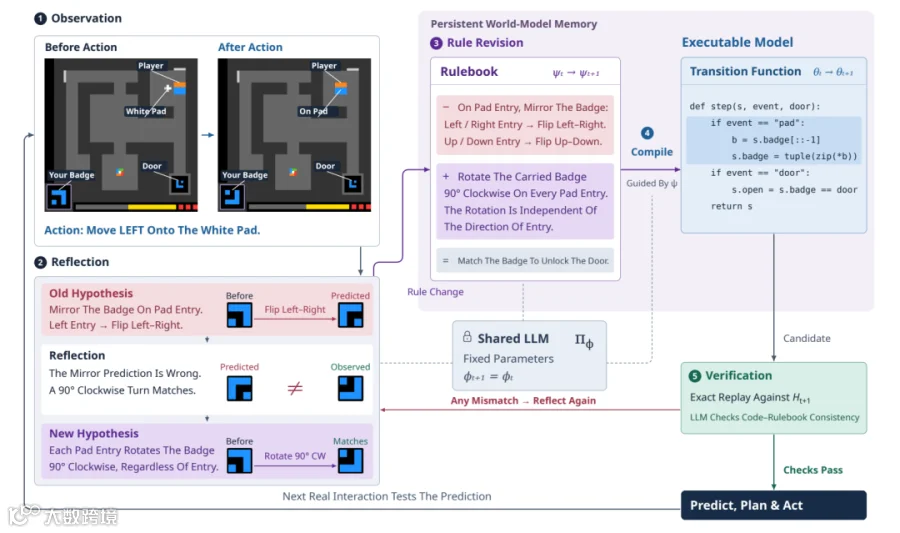
图注:使用冻结的 LLM 进行持续的世界模型学习
随着交互数据不断积累,AI对环境的理解也会逐渐完善。
研究团队还利用Git保存世界模型的修改历史。AI不仅能够查看当前规则,还能回溯旧版本、比较不同修改,甚至恢复之前的代码实现。
因此,这种外部记忆并非简单保存聊天记录,而是持续积累和迭代可用于未来决策的环境知识。
03
25款游戏全部通关,
操作次数比人类少56%
为了检验这套机制,研究团队选择了ARC-AGI-3作为主要实验环境。ARC-AGI-3包含一系列规则未知的交互式游戏。AI需要通过实际操作理解游戏机制,找到目标,并在有限的动作预算内完成任务。
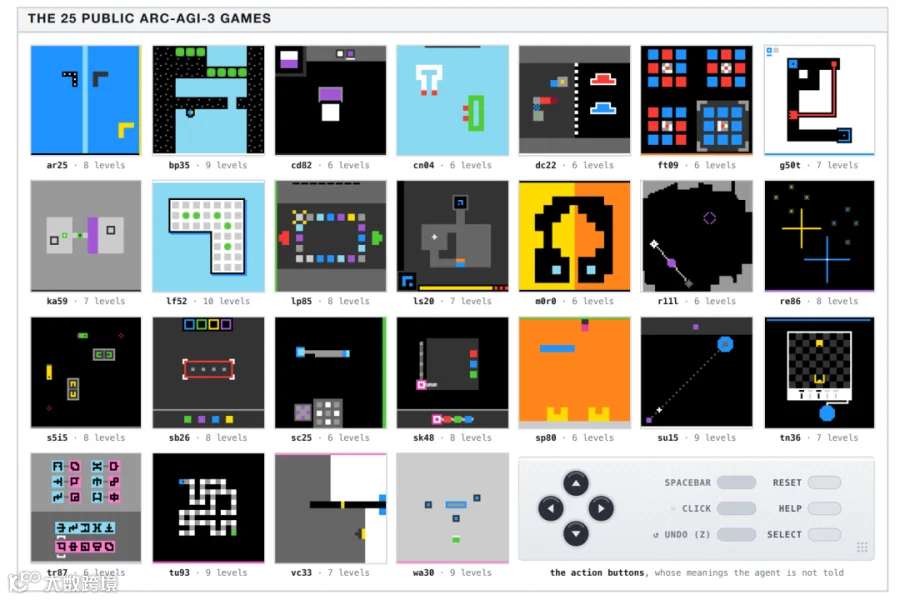
图注:25个公共ARC‑AGI‑3游戏。
与直接回答一道推理题不同,游戏会不断提供新的状态和反馈。AI每走一步,都可能遇到尚未理解的机制。
研究团队使用Claude Opus 5作为底层大模型,在Claude Code环境中运行MEMENTO 3,模型推理强度设置为extra-high。
最终,MEMENTO 3成功完成了25款公开游戏的全部183个关卡,平均RHAE达到100.0。
表1:25款公开ARC-AGI-3游戏中各游戏的RHAE得分。

在动作效率上,其完成所有游戏共使用7518次动作,而对应的人类基准为17135次,仅为人类动作数量的44%。
表2:各游戏的动作次数。结果来自与表1相同的实验运行和评分记录。
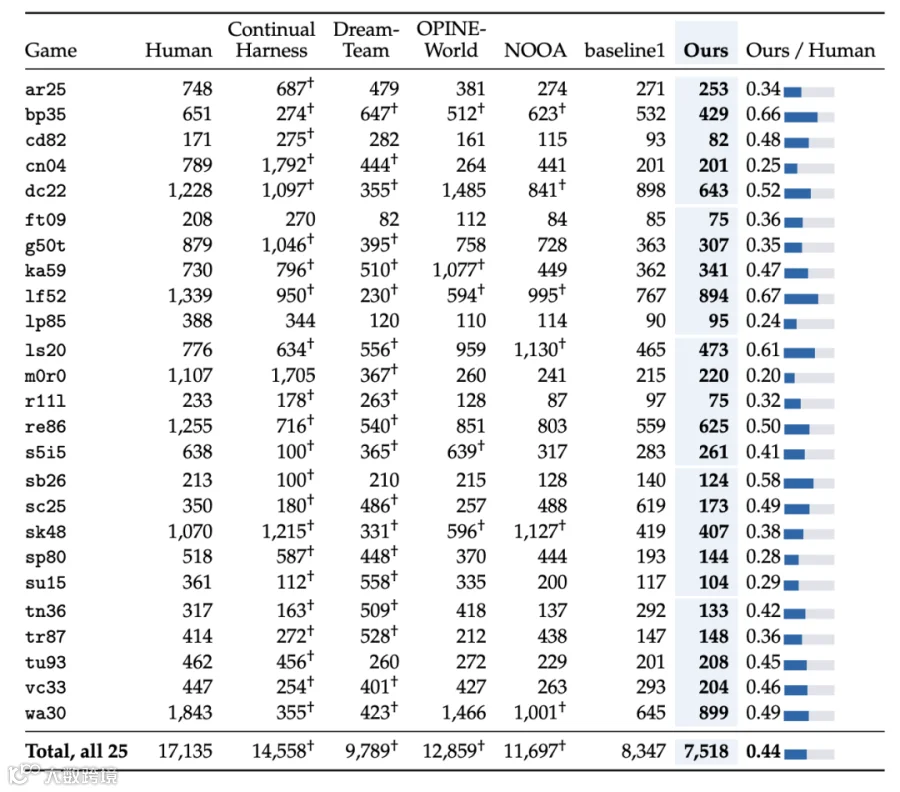
作为对比,论文列出的baseline1同样通关了全部25款游戏,但使用了8347次动作,平均RHAE为99.0。
研究团队还专门测试了自然语言规则手册的价值。
他们保留可执行世界模型和其他系统配置,只移除规则手册,在三款不同难度的游戏上进行对比。
结果发现,加入规则手册后,完成任务的总动作次数从677次降低至617次,Agent内部迭代轮次从830轮降低至678轮,分别减少约9%和18%。
表3:规则手册(Rulebook)消融实验,每个难度区间选取一款游戏。
难度定义为人类基准动作次数除以关卡数量。
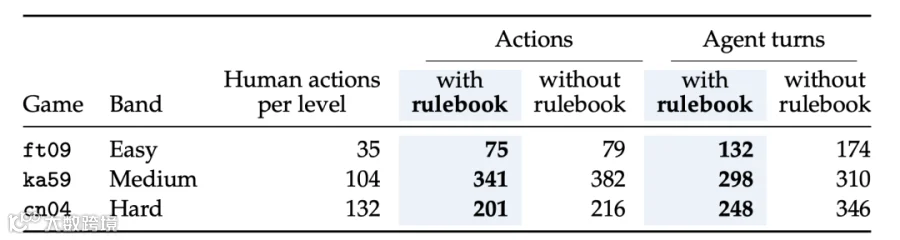
这意味着,让AI先明确写下自己理解的规则,再生成代码,并不是单纯增加一个记录步骤。在这些实验中,显式规则手册帮助Agent更快地修正模型,减少了实际探索成本。
04
从规划到实时控制,
Pong三局全部21:0
除了ARC-AGI-3,研究团队还将MEMENTO 3应用到了经典Atari游戏《Pong》中,进一步测试学到的世界模型能否用于持续的实时控制。
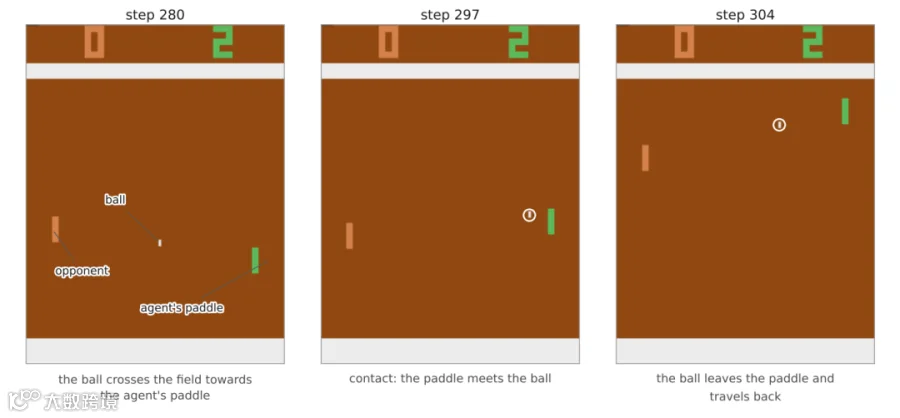
图7:Pong游戏的运行机制。Agent控制右侧球拍,对手控制左侧球拍。双方通过上下移动球拍拦截小球,并将其击回对方一侧;当一方未能接住球时,另一方得分。图中的三个画面展示了一次回球过程:小球飞向Agent的球拍,与球拍发生碰撞后反弹,并重新飞向对手一侧。
与ARC-AGI-3不同,Pong需要Agent根据不断变化的球和球拍位置实时调整动作。为此,MEMENTO 3在交互过程中学习球的运动、反弹以及对手行为等规律,并将其写入规则手册和可执行世界模型。
最终,MEMENTO 3学到的控制器在三个不同开局的测试中全部以21:0获胜,一分未丢。
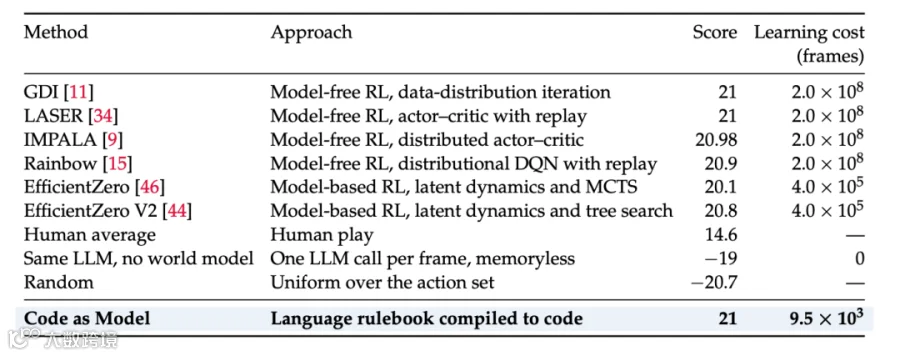
表5:Pong得分。按照强化学习实验中常用的评估指标,单局得分定义为Agent得分减去对手得分,取值范围为−21到+21。MEMENTO 3的得分为下图所示三局测试的平均结果,而论文中引用的其他基线方法则采用各自原论文的评估方式。
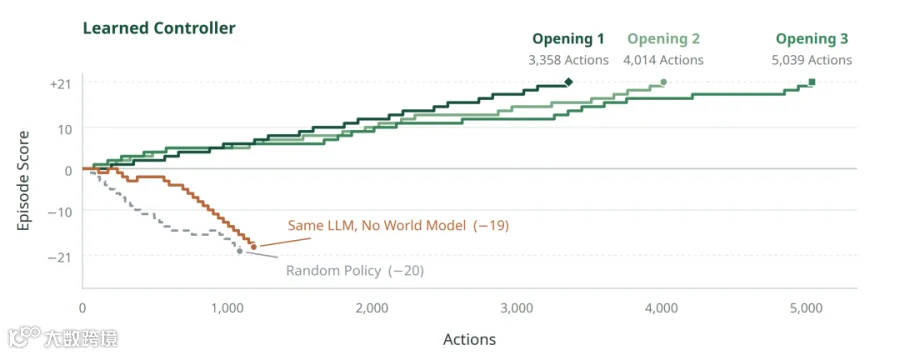
图注:Pong单局得分。
更关键的是,在最终测试阶段,这套控制器不再需要调用大语言模型,而利用已经学到的世界模型来预测不同动作的结果,并独立控制球拍。
作为对比,使用相同LLM但没有世界模型的Agent得分只有-19,而Code as Model达到+21。
这说明MEMENTO 3学到的环境规律,可以进一步转化为无需LLM持续参与的控制能力。
END
关注+星标,获取AI前沿进展与开源一线动态