

智猩猩AI整理
编辑:林夕
视频里的森林想换成雪景,人物想换套衣服,能不能只修改指定内容,同时让整段视频的动作、细节和画面保持连贯?
字节跳动 Seed 团队参与的一项新研究 VINCIE-NExT,尝试用图像编辑能力解决这个问题:
先从视频中提取关键帧,完成图像编辑,再把修改后的图像作为视觉示例,指导模型生成编辑后的视频。
这条「视频→图像→编辑后图像→视频」的路径,让模型能够借助成熟的图像编辑能力完成视频修改,减少对大规模成对视频编辑数据的依赖。

在 OpenVE-Bench 测试中,该方法取得 3.08 的总体得分,高于对比的开源方法 OpenVE-Edit 的 2.49。
这项研究名为《VINCIE-NExT: Unlocking Video Editing from Images via In-Context Modeling》,已被 NeurIPS 2026 接收,并于10月8日发布在 arXiv 上。

该研究工作由字节跳动Seed曾妍团队主导。曾妍现为字节跳动Seed团队研究员、Seedance 2.0视频模型预训练负责人。
据公开报道,她本科毕业于西安交通大学,后在加拿大蒙特利尔大学获得计算机硕士学位,于2021年加入字节跳动。
她的研究覆盖视觉语言预训练与视频生成,曾以第一作者身份发表 X-VLM、PixelDance 等代表性工作。
其中,X-VLM 探索文本与不同粒度视觉概念之间的对齐,获 ICML 2022 接收;PixelDance 则结合文本与首尾帧图像条件,提升复杂场景和大幅度动作的视频生成能力,发表于 CVPR 2024。
01
图像编辑能力,如何迁移到视频
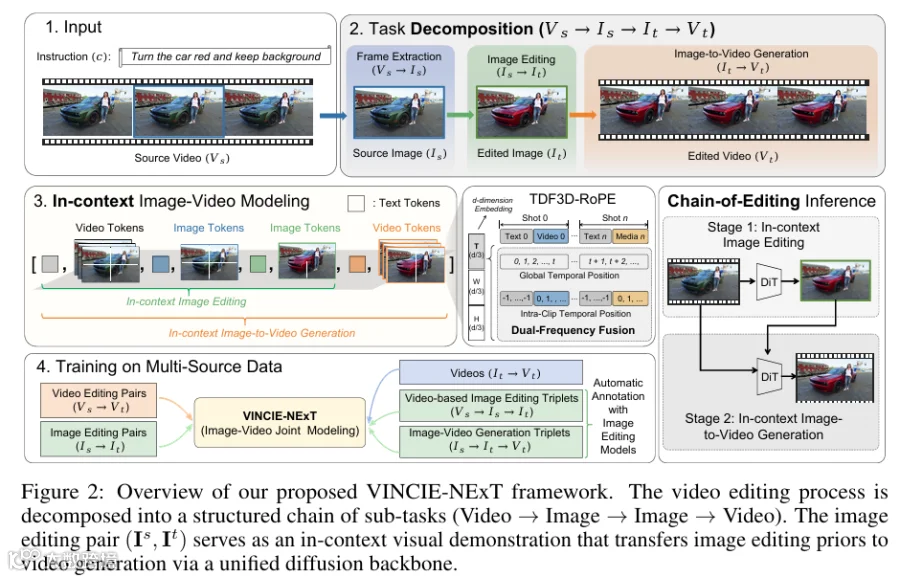
VINCIE-NExT 的核心思路,是将视频编辑拆分为一条由图像编辑串联起来的任务链:
先从原视频中提取关键帧,再根据用户指令编辑这张图像,最后将编辑结果作为视觉参照,指导模型生成完整视频。
相比单纯依赖文字指令,编辑后的图像能直接展示目标外观,为后续生成提供更具体的视觉参照。
模型也因此有机会在修改指定内容的同时,保留原视频中的主体、动作和场景结构。
要让这种方式真正奏效,模型还需要解决一个关键问题:
如何把关键帧中的编辑效果准确传递到视频的其他帧,而不是只生成一张外观相似的画面。
为此,研究团队提出了 TDF3D-RoPE,即时间双频三维旋转位置编码。
它同时考虑不同视觉片段之间的顺序关系,以及不同片段中空间位置的对应关系,使模型既能区分原始图像和编辑后图像,又能识别它们在空间上相互对应的区域。
这套设计的目标,是让模型更准确地把关键帧里的外观变化映射到视频帧中,减少编辑过程中出现的闪烁、重影和细节不一致。
研究还提出了 Chain-of-Editing(CoE)推理策略,将编辑过程拆成两个阶段:
第一阶段生成编辑后的关键帧,第二阶段再利用这张图像作为视觉示例,生成完整视频。两个阶段可以依次执行,并使用同一套模型参数。
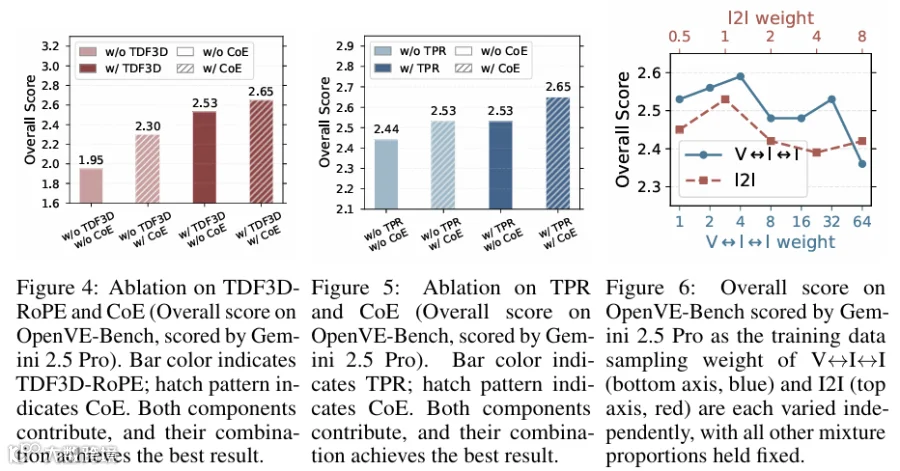
除了模型结构,训练数据的构成也会影响最终效果。
VINCIE-NExT 将图像编辑数据、视频编辑数据,以及从原视频中构建的视频—原始关键帧—编辑后关键帧数据组合起来训练。
其中,第三类数据是这项研究的重要设计:
研究团队利用 GPT-4o 生成编辑指令,再通过 Seedream 4.5 对视频采样帧进行编辑,从而构建带有原视频上下文的图像编辑样本。
论文报告的三类数据规模分别为 120 万、245 万和 163 万个样本。
这种数据构建方式让模型能够学习如何在视频背景下理解图像编辑结果,减少对完整的原视频—编辑指令—目标视频配对数据的依赖。
但视频数据仍然参与训练,论文并未声称完全摆脱视频编辑数据。

02
OpenVE-Bench 上,
总体得分达到 3.08
在实验部分,研究团队使用 OpenVE-Bench 评估视频编辑能力。
该基准包含 431 段视频,覆盖 8 类任务,包括全局风格迁移、背景变化、局部修改、物体移除、物体添加、字幕编辑、创意编辑和相机视角编辑。
按照论文采用的 Gemini 2.5 Pro 评估协议,各项结果以 1 至 5 分计分。
VINCIE-NExT 的总体得分为 3.08,高于开源方法 OpenVE-Edit 的 2.49,论文报告的相对提升约为 24%。
分任务来看,VINCIE-NExT 在全局风格迁移上获得 4.17 分,高于 Runway Aleph 的 3.72 分;在局部物体移除任务中获得 3.24 分,也明显高于 OpenVE-Edit 的 1.85 分。

不过,模型的表现并非在所有任务上都占优。相机视角编辑得分为 2.06,低于 Runway Aleph 的 4.53。
改变相机视角往往涉及新的观察角度和场景几何关系,单纯将关键帧中的外观变化传递到视频中,还不足以解决这类问题。
背景变化和局部添加等需要生成原视频中不存在内容的任务,也仍有提升空间。
03
从关键帧到完整视频,
编辑效果还要过连贯性这一关
论文还通过多组可视化结果展示了模型的编辑能力。
实验涵盖全局场景风格转换,以及火焰、水流、风等局部元素的组合编辑,观察模型能否在改变指定内容的同时,保持不同视频帧之间的连贯性。

研究团队进一步比较了直接进行视频到视频编辑、使用 CoE 并由模型自行编辑关键帧,以及使用外部图像编辑器生成关键帧这几种方式。

论文指出,直接进行视频到视频推理时,部分结果会出现闪烁和重影;通过编辑后的关键帧提供视觉锚点,可以缓解这类问题。
进一步接入外部图像编辑器,也能在不重新训练视频编辑模型的情况下改善部分编辑结果。
这体现了该框架的模块化特点:图像编辑器的进步,可以通过中间图像直接传递给视频编辑环节。
总体而言,VINCIE-NExT 探索了将成熟图像编辑能力迁移到视频编辑的一条路径。
它通过关键帧提供明确的视觉目标,再借助统一的图像—视频建模、位置编码和分阶段推理,将编辑结果延伸到完整视频中。
这项研究仍有明确的能力边界:
风格变化和局部修改相对更适合这种方式,而相机视角变化、复杂几何变换以及新增场景内容,对模型提出了更高要求。
如何在保持原视频时序与结构的前提下,进一步提升复杂编辑的准确性,仍是视频编辑模型需要解决的问题。
END
关注+星标,获取AI前沿进展与开源一线动态