

智猩猩AI整理
编辑:林夕
Meta这次开放模型,连拿回去怎么练也一起安排上了。
10月15日,Meta发布Muse Spark Open,开放这款8160亿参数多模态模型的权重,主打编程与长流程Agent任务。
官方给出的头衔是:迄今最强的美国开放权重模型。
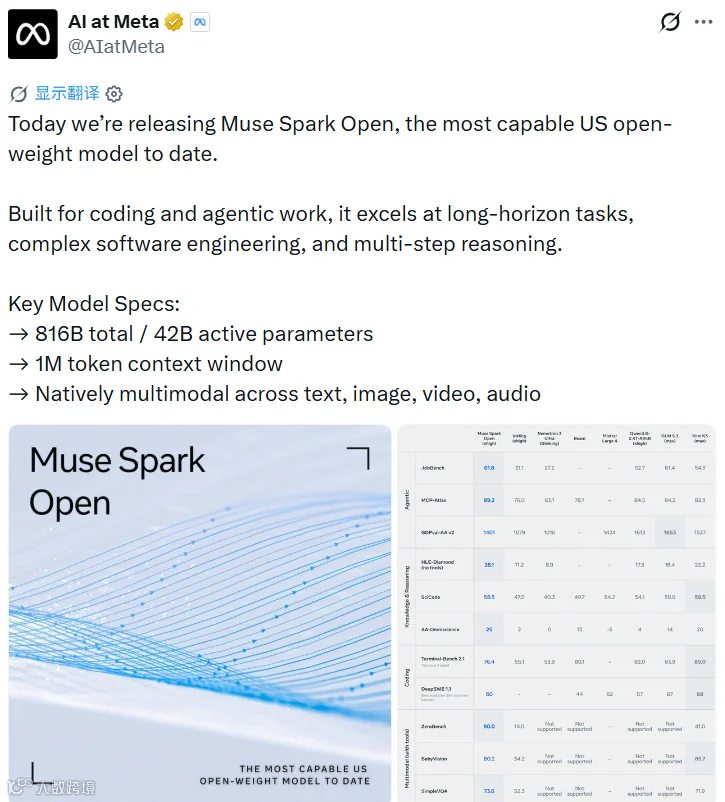
参数够大,口气也不小。
但这次发布里,更值得开发者翻下去看的,是模型之外那张长长的配套清单。
部署有SGLang、vLLM等框架,微调有TorchTitan、LoRA,强化学习有Miles、verl等训练路径,不想自己搭集群,还能选择托管后训练服务。
模型交给你,接下来怎么把它练成自己的Agent,Meta和合作团队也给出了方案。
而且,有人已经跑完了实验,晒出了曲线。
01
开放权重当天,
微调与强化学习同步上线
Muse Spark Open开放权重的同时,TorchTitan同步加入了模型支持,提供多轮监督微调、LoRA和TitanRL强化学习路径。
开发者可以继续用自己的数据和任务训练模型。

能够继续训练的,是一款相当庞大的模型。
Muse Spark Open拥有8160亿总参数,每个Token激活约420亿参数,支持100万Token上下文,可接收文本、图像、视频和音频输入,输出文本。
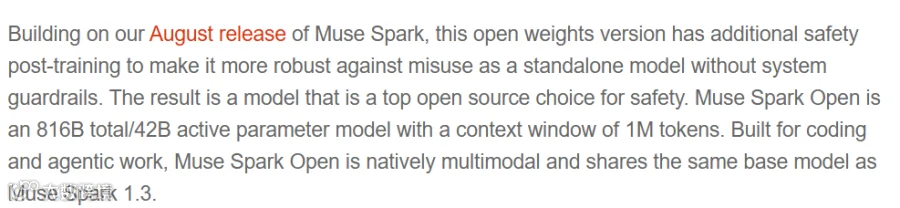
据PyTorch团队介绍,它与Muse Spark 1.3共享基础模型,开放版额外进行了安全后训练,训练覆盖多文件重构、调试和长时间运行的开发任务。

这些配置,指向的是需要连续干活的Agent。
开发者交给它一个代码库,期待的是找到问题、改动文件、调用工具,再根据测试结果继续调整。
任务一旦拉长,模型就得记住前面做过什么,也得接住后面不断返回的新信息。
百万Token上下文,为这样的工作提供了空间。模型采用滑动窗口与全局注意力混合结构,以控制长上下文的缓存负担。
不过,通用模型到了公司内部,照样得熟悉业务。
内部接口怎样调用,代码要通过哪些检查,遇到某类错误应该重试还是换个工具,这些规则通常掌握在开发者手里。
开放权重的价值,也在这里开始变得具体:团队能把自己的经验,继续教给模型。
已有的高质量案例,可以用于监督微调;任务有明确的成功标准,可以尝试转成强化学习反馈;希望缩小参数更新范围,也有LoRA可选。
TorchTitan此次提供的支持,接住的正是这些需求。

02
全参数RL、LoRA RL,
已有实测结果
SGLang与Miles团队公布的实验,把支持训练推进到了实际运行。
团队使用DAPO-Math-17K数据集,通过GRPO训练Muse Spark Open的完整语言模型,分别在64张H200和32张B300上进行了实验。
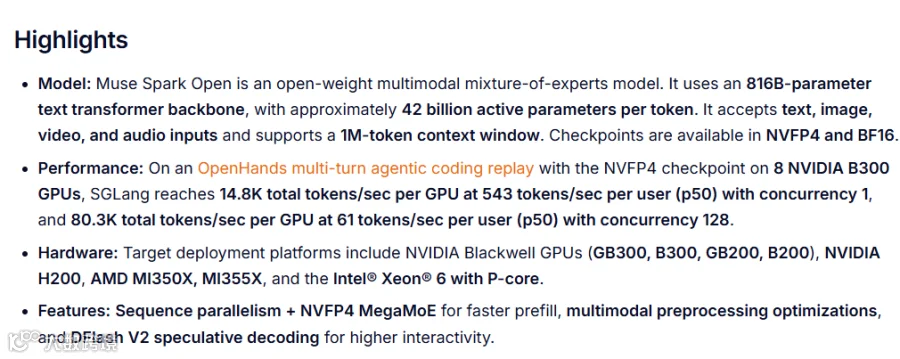
8160亿参数模型交到手里,全参数训练的算力账单依然不轻。
Miles为此提供了分布式训练支持,并支持将优化器状态卸载到CPU内存或NVMe,缓解资源压力。
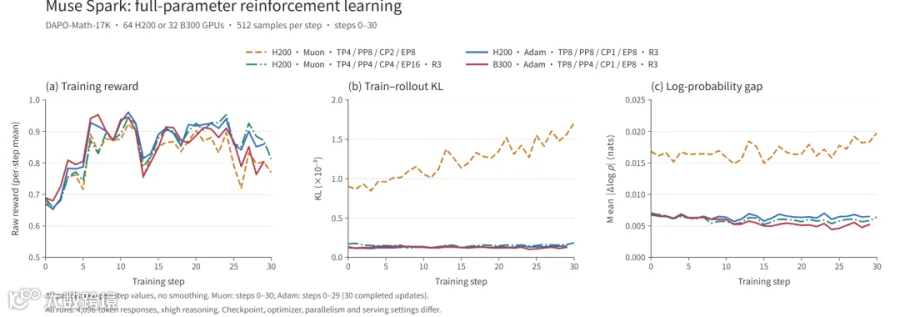
除了让训练跑起来,团队还处理了一个多轮Agent特有的麻烦:执行时走过的路,训练时得对得上。
模型调用工具后,系统会加入工具结果和后续消息。
如果重新应用聊天模板时改变了已有Token前缀,训练看到的序列,就可能偏离模型实际生成的轨迹。
SGLang与Miles团队专门修复了相关模板行为,保持多轮采样轨迹的一致性。
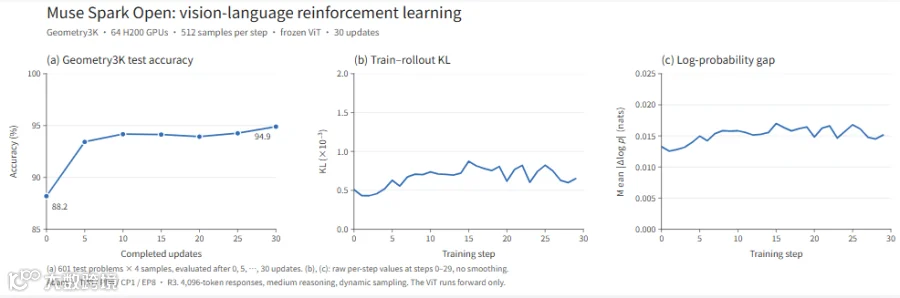
团队还公布了一组视觉语言任务结果:在冻结视觉编码器的Geometry3K实验中,经过30次更新,测试准确率从88.2%升至94.9%。
全参数更新之外,vLLM与verl给出了另一条路线:基于NVFP4量化权重,进行LoRA强化学习。
这一方案由vLLM负责采样,verl FSDP2负责训练。训练端更新适配器,再将适配器同步回推理端,无须每轮同步全部模型参数。
团队在16张GB300上进行了150步GRPO训练。
按照公布的实验设置,AIME 2024的mean@8准确率从0.56提高至0.85。

数学和几何成绩,不能直接折算成编程Agent的成功率。
但这些实验已经公开了训练配置、更新方式和结果,让后续团队有了可以沿用和验证的起点。
从全参数训练到LoRA,路径已经有了。
下一步,才是开发者最实际的问题:选哪条,成本多少,能不能接进自己的系统。
03
“美国最强”的限定词背后,
是中国模型的领先
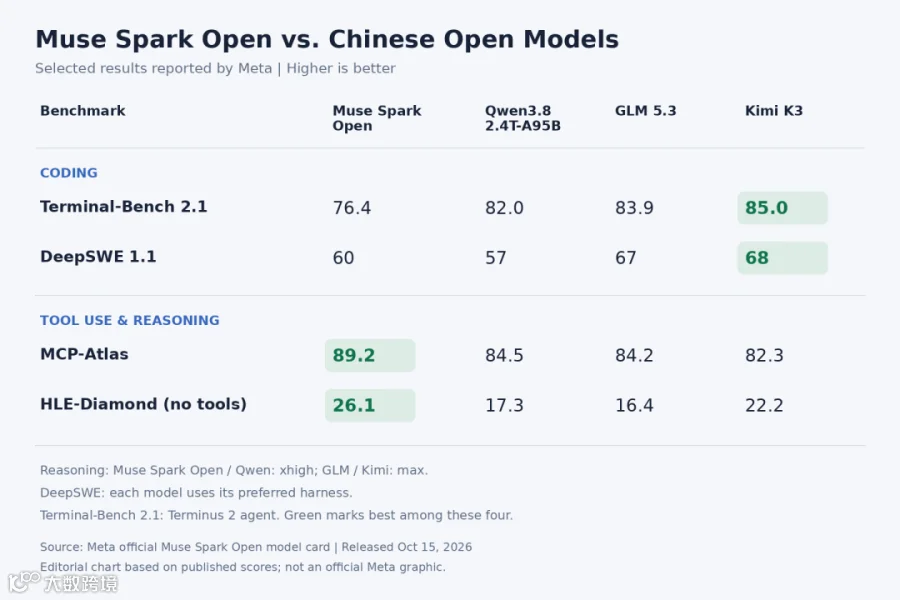
Meta把Muse Spark Open称为“美国最强开放权重模型”,但在它自己的评测表里,几款中国模型的编程成绩更高。
Terminal-Bench 2.1中,Muse Spark Open获得76.4分,Qwen3.8、GLM 5.3和Kimi K3分别达到82.0、83.9和85.0分。
DeepSWE 1.1中,Muse Spark Open为60分,GLM和Kimi分别为67和68分。
而Meta此次强调的训练和部署配套,中国厂商也已经在做。
Kimi K3配套Kimi Code CLI,支持vLLM、SGLang部署,并从监督微调阶段引入量化感知训练,将部署效率纳入训练过程。

DeepSeek则把Agent训练的执行环境做到了大规模生产部署。

其DSec沙盒平台与强化学习框架协同设计,据技术报告,生产环境支持超过38万个并发沙盒,每秒创建超过5000个沙盒,为模型执行代码、调用工具和生成训练轨迹提供支撑。
智谱开放了训练GLM所使用的强化学习框架slime。
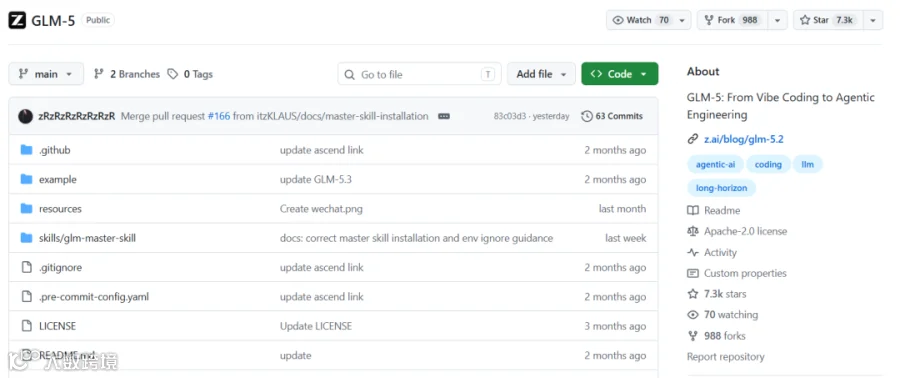
GLM官方仓库也提供继续训练的路径,支持通过slime以及ms-swift开展强化学习或监督微调。
目前,Kimi、DeepSeek和智谱都已推出各自的Agent工具或训练基础设施。
Meta此次开放Muse Spark Open并同步提供后训练支持,将与这些中国厂商在模型能力、训练效率和部署成本上展开更直接的竞争。
END
关注+星标,获取AI前沿进展与开源一线动态