


10月15日早上八点刚过,很多人打开DeepSeek时看到的不是回答,是转圈、报错和连接失败。网页端、APP端和API相继失联。有人正准备写材料,有人卡在代码调试里,还有人把日常流程整个交给了它,突然发现工具没了。
UTen幼狮的舆情演化复盘给出了这场风波的量级。10 月 12 日到 16 日监测周期内,共收录10685条作品、14530次互动,覆盖8993位创作者,其中9966条集中在宕机当天,占比超过93%。
但这条曲线只高了一天。10月16日,作品数回落到447条。一次持续约5小时的全线宕机,没有演变成一场持续的骂战,原因值得拆开看。
01
SIGNAL
故障前三天,已经有人在问是不是崩了
故障不是毫无征兆的。10月12日,小红书用户鸢鸢发帖问「这是 deepseek 什么情况」,说自己话题加载不出来、一直转圈。同一天,B 站用户CH彼得发「deepseek 崩了?」。
这是 deepseek 什么情况
这些声音当时没有形成规模。10月12日到14日三天,合计只有272条作品,互动量基本贴着监测基线走。用户的第一反应是怀疑自己的网络和设备,而不是判断服务整体出了问题。
事后回看,这是典型的前兆信号。散点式的报错反馈已经出现,只是强度太低,没有人在意。
02
OUTAGE
八点之后,痛感从打不开变成活干不了
10月15日八点之后,情况迅速变了。网页、APP和API大面积不可用,用户开始跨平台互相确认。8点22分,抖音用户玄水渡川发了「deepseek 崩了不习惯」,288次互动。8点56分,「趁我对你笑眯眯」写了一句更像撒娇的话,574次互动。
小D宝宝啊 你别崩了呗 没有你我怎么办啊。
这句话看着是玩笑,实际说明了一件事。DeepSeek已经不是偶尔打开聊两句的工具,它进入了写作、办公、编程和内容生产的日常流程。工具嵌得越深,故障的体感就越接近突然停电。
8点57分,Mr.Alpaca韜的质疑帖拿到831次互动,其中371条评论。评论区的问题很朴素,是不是只有我这样,别的地区也崩了吗,是不是被攻击了。9点15分,第一财经介入播报。9点22分,C9观察通报网页和APP同时故障。
10点34分,呼噜还在记录「现在是 10.15 10 点半 我的 deepseek 崩了」。到了晚上,晓龙哥的实验局把这次约5小时的中断对办公场景的影响完整复盘了一遍。
这类内容把技术故障翻译成了生活体验。正在写的材料写不下去,代码调试被打断,本来交给AI的活要临时手动补上。多数用户不关心服务器出了什么问题,但他们清楚知道,自己的进度被卡住了。
03
PULSE
9,966 条,一条标准的脉冲曲线
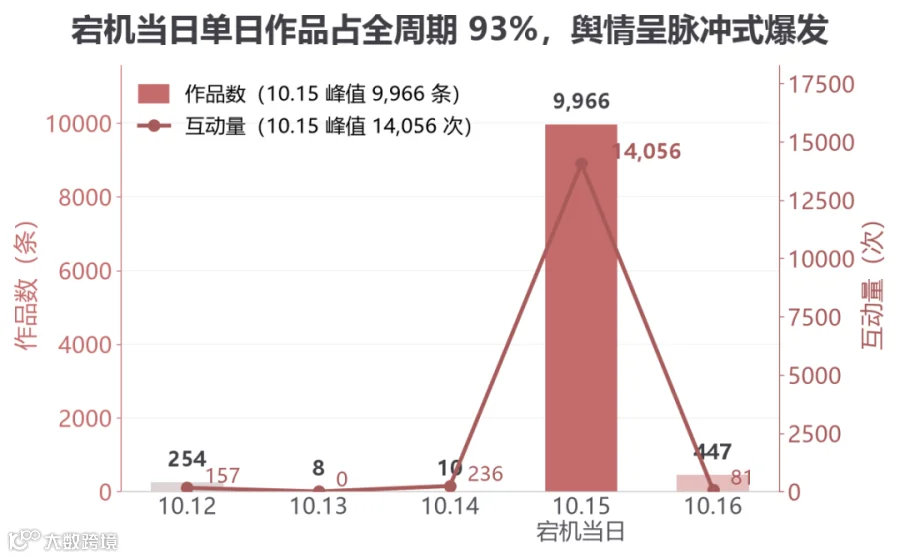
单日9966 条作品、14056次互动,占整个监测周期互动量的96.7%。前一天是10 条,后一天是447条。
报告把这个特征定义为脉冲式爆发。舆情没有酝酿期,故障发生即峰值,处置完成即落潮,整个生命周期被压缩在24小时以内。
这里有个判断值得单独说。脉冲型舆情的破坏力不取决于峰值多高,取决于落得多快。峰值高说明依赖深,落得慢说明处置差。
04
TURN
下午一点,官方做对了两件事
下午一点左右,服务恢复。官方发布致歉说明,同时宣布近7天内所有API用户消耗金额全额返还。

官方做对的是两件事。第一件是修复速度,从早八点到下午一点,约5小时。第二件是补偿范围,没有只算宕机的这几个小时,而是把近 7 天消费全部返还。
对付费用户来说,这是一笔清晰、可计算、能直接到账的回应。报告里有个说法,覆盖范围远超故障本身时间段,形成降维诚意打击。
下午5点28分,机器之心发了「宕机 5 小时,DeepSeek 给补钱啦」,215 次互动。几分钟后,小红书用户独立开发北城发了「DeepSeek 道歉了,近 7 天消费全额返还」,353 次互动。用户开始主动晒补偿到账的通知,评论区出现大量「给补钱了,已原谅」式的表达。
宕机 5 小时,DeepSeek 给补钱啦
同样重要的是它没有做什么。没有否认故障,没有把责任推给用户网络,也没有要求用户逐条提交证明材料。故障造成的损失怎么处理,官方给了一个明确的答案。
这次情绪的快速转向,正是因为恢复服务和补偿用户在同一天完成,抱怨没有留下继续发酵的时间窗口。
05
SHIFT
热帖换了一轮话题,问题没有跟着落下去

把当天的高互动作品按发布时间排开,分界线很清楚13点之前,热帖集中在报障、求证和停工焦虑。13点之后,补偿相关的内容全部是正向立场。
舆论没有转向对立。10月16日,作品数从9966条回落到447条,降幅超过 95%,互动量从14056次降到81次。报告对这次事件的定性,是一次因祸得福的技术性公关范式。
但回落不等于问题消失。16日凌晨,抖音用户喏喏不糯糯发了「大肥鱼×克劳德,真是一对苦命鸳鸯」,把几个大模型放在一起调侃稳定性。互动量只有18次,代表的方向却比早上的报障更值得看。
大肥鱼×克劳德,真是一对苦命鸳鸯
后续讨论里出现了几类声音。要不要准备备用模型,要不要做多端备份,本地化部署值不值得投入,自己对单一AI服务的依赖到底有多深。这部分内容情绪强度不高,专业性反而更强。
尤其是开发者和企业用户。他们关心的是API稳不稳、故障有没有预警、中断时有没有状态页和应急通道。对这类用户来说,补偿能补一次损失,补不了稳定性的缺口。样本里也出现了对算力瓶颈和频繁宕机的担忧,法律视角的介入强度虽然很弱,稳定性仍然是后面要盯着的风险。
06
RESIDUE
当 AI 变成基础设施,用户要的不只是能回答问题
这次事件留下了两层东西。第一层,用户重新看见了自己的依赖程度。服务不可用的那几个小时里,有人发现自己回不到原来的工作方式,有人发现手头没有备用工具,也有人第一次认真考虑,重要任务要不要留第二套方案。
第二层,处置方式本身被记住了。快速修复加上超预期补偿,把一次可能持续发酵的服务故障,控制在了技术问题和体验问题的范围内。
但宽容是有次数的。一次补偿会被记住,多次不稳定同样会被记住。
接下来要补的不只是系统容量和服务稳定性,还有故障发生时的信息沟通。什么时候发现的,影响了哪些服务,预计什么时候恢复,用户的损失怎么处理。
当 AI 开始承担生产力基础设施的角色,用户期待的就不只是它能回答问题。他们更希望在关键的时候它稳定在线,真出了问题,也能尽快说清楚发生了什么、接下来怎么办。
数据来源:UTen 幼狮《总部舆情演化复盘》,监测周期 2026.10.12-10.16。文中数据均为监测样本统计,故障时间、官方回应及补偿信息依据报告收录内容整理。
如果你觉得今天这篇有收获,
欢迎 点赞、在看、转发 三连,我们下次见。
想看完整分析?点击下方 「阅读原文」,数据来源,原帖链接,全部原始数据,了解更多详情 ↓