

左:0xSero,右:听众A
大家都在缺算力,缺得厉害。但过去一年量化方案进步太快,三比特、两点五比特的模型已经能塞进普通硬件,在 CPU 上跑出一年前想不到的速度。一个基本问题摆在面前:不用最贵的卡,能不能把大模型真正用起来?
这场直播里,0xSero 现场演示了整套做法:DeepSeek v4.1 flash 三比特版本,权重约两百多 GB,加上 engram 表一百九十 GB 放 SSD,配一张 3090 和 DDR4 内存,整机约八千美元,解码每秒 15 个 token、预填充每秒 1450 个 token。他让模型全程在 CPU 上驱动浏览器做研究、建 gist,还展示了 YouTube 上一期整条流水线都由 AI 在本地完成剪辑和发布的 DHH 播客——慢,但私密、稳定、归自己所有。
0xSero 是本地推理与超低比特量化方向的实践者,做 EXL3 量化并用 CPU 加大容量内存加 24GB 显卡跑大模型,GitHub 上有 TurboQuant(KV cache 量化)、local-ai-registry(各型显卡的本地推理配方)等项目。这场直播从量化原理讲到整机配置、现场演示和适用场景,他的主要观点包括:
量化方案的差距在算法,不在比特数。 GGUF 这类朴素的舍入方案,每个权重都引入误差,精度一路往下掉。EXL3 用滑动窗口把所有权重一起调,目标是让误差最小;同样两比特,保住的图像保真度明显更多。
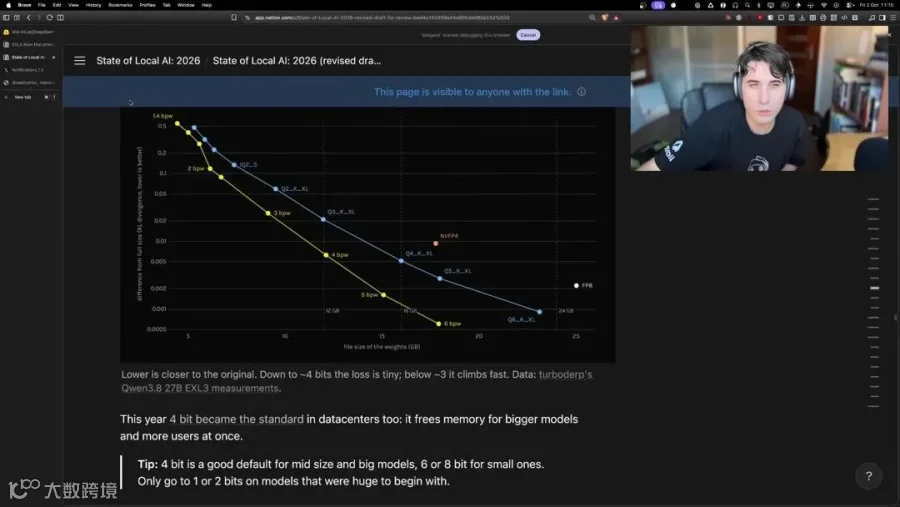
超低比特量化的质量已经接近原版。 他用 KL 散度对比三比特版 DeepSeek 与原版,top agreement 约 94.8%,而 GGUF 他见过最高也就 89%。代价是解码慢约 5%,kernel 都优化好后慢 5% 到 8%。
八千美元整机,就能在 CPU 上跑非常大的模型。 EPYC 7443P、512G DDR4(当时约两千三百美元)、Gen 4 主板加一张 3090,整套他花了约一万二,扣掉 3090 最少六千五。DeepSeek v4.1 flash 解码 15 tok/s、预填充 1450 tok/s。
同样的模型,四张 RTX Pro 6000 只是贵十倍。 他把同一个模型放在四张 RTX Pro 6000 上对比,那基本是十倍的价钱。CPU 这套机器扔在那儿非常稳定,蹲 eBay 淘一套就行。
不受时间约束的任务,就该排队过夜跑。 剪视频、做内容这种一小时还是八小时做完都没关系的活,排上队让它夜里干完发出去。DHH 那期播客整期都是 AI 在本地剪的,标签也是它自己查出来的。
被限制的时候,本地模型是唯一出路。 他经常碰到 Claude 说不行、GPT 也不行的情况,安全相关的功能只能换别的。任何比较私密的事情,本地模型都很合适。
像助手一样跟 AI 说话,最好你拥有它。 如果它在帮你打理生活、管邮件和各种事情,所有权就变得很重要。
同价位下,买更快的卡比买 DGX Spark 划算。 三四千美元的 DGX Spark 对比一张或两张 3090,肯定还是买更快的划算。内存越小,Spark 给你的优势就越小。
量化原理:从丢颜色到EXL3的误差最小化
0xSero:大家都在缺算力,缺得厉害。所以要是能做到一比特,他们早就做了。而且在高峰时段,他们真有可能把模型量化一下,或者对外直接提供更小的量化版本,不用四比特,改用三比特、两点五比特。因为量化方案,这就是我想给大家看的,过去一年进步太大了,简直不可思议。举个例子,原图在我 Twitter 上有,不过我们这儿就不看了。八比特的时候,你能看清这台 Spark,能看到 DGX Spark,它的各个侧面、打光、线圈、上面的字,全都挺清楚。那如果我们用三比特来表示颜色,也就是构成这张图的那些像素颜色,那我们就只有五百一十二种颜色。
0xSero:颜色就这么多。所以你看,它开始丢东西了,图像的保真度在往下掉。再降到两比特,只剩六十四种颜色,你能看到两侧已经看不出区别了,机器的边缘你也看不太出来,还有这块莫名其妙的棕色,完全说不通。这还是我们把数字四舍五入的情况下,就是单纯把数字舍入一下,很多量化方案就是这么干的,把数字舍入一下。很多人发布的量化版本,都是 agent 开箱就能做出来的那种,老一套的 GGUF 之类。
基本上技巧是这样的:你本来有十六比特的数字,现在想量化到两比特或者三比特,就说三比特吧。三比特给你八个取值,所以你得把每个数字都舍入到这八个值里的一个。GGUF 我理解就是这么工作的。要是有谁听到这儿觉得我说错了,欢迎纠正我。但正因为这样,你量化的每一个权重上都会引入误差,每个权重都差一点点,模型的输出就和原本设计的不一样了。
0xSero:于是精度就一路往下掉,比特越低掉得越厉害。EXL3 的做法是,拿一个十六比特的权重,套上一个窗口,然后把模型里所有那些数字、所有那些权重都往上往下调,不管是什么序列,都在调,目标是让误差最小。你能看出它们用的算法带来的差别。这边是两比特,用的是 GGUF 那种非常笨、非常朴素的版本。我这么说只是做个对比,不是说现在大家都是这么做的。看右边,你能看到我们保住了更多精度、更多图像保真度,边缘还能看出来。它还是两比特,就只有两比特,但你用上了这种滑动窗口的算法,就能拿到更多数据来用。
0xSero:这个挺难解释的。我写了篇文章,很快就会发出来。但这张图大致能说明我的意思。在座有谁比我更懂这块的,欢迎开麦来讲。
好,我们回到 DeepSeek。我用的 DeepSeek 量化版本之一,我记得链接还在,我给你们的是一个仓库链接,那个模型叫 mia-labs-exl3-3-bpw。它的精度同样更高,靠的是算法,代价是解码更慢。也就是生成 token 更慢,因为要多做一些数学运算,对,得多算一些东西。大概慢百分之五。如果把 kernel 这些都优化好,是慢百分之五到八。
0xSero:但三比特、甚至降到两比特之后的画质保留,我自己做到过两比特,效果夸张得离谱。所谓 top agreement,就是拿这个模型的两比特版本和 DeepSeek 原版做对比,跑一个叫 KLD 测试的东西,也就是 KL 散度,喂一堆数据给它们,看它们有多大程度上一致,也就是它们预测出的 token 有多少比例是相同的,量化后的小模型和原版有多像。这个每权重两点五比特的版本是给 step five 做的,那个模型还没发布,但我一直在做。要等他们十月十五号重新放出权重我才会发布。它的 top agreement 大概是百分之九十四点八。而 GGUF 我见过最高也就百分之八十九。也许他们有更好的办法。
总之,怎么把本地 AI 的成本压下来,这就是目标。量化是其中一环,让模型塞得进去,包括 KV 缓存的量化、模型本身的量化,同时保持高质量的还原。这是第一步。第二步就是找出用能接受的速度跑这个应用最便宜的硬件。看,这就是成果。顺便说一句,这是在 CPU 上跑的。等这边跑完我们还会在 Pi 上看,那边更快。因为 T3 这类代码默认把推理过程藏起来,也不显示流式输出,所以会显得更快。话说回来,这个模型是三比特的,权重大概两百八十、两百二十 GB,然后那个 engram 表是一百九十 GB,这个可以放 SSD 上,因为查找是常数时间。看看这个,语音转文字用的是 Superwhisper,跑在我 MacBook 上的本地模型,叫 Parakeet。所以它就在我 MacBook 上完成,全程留在本地。
0xSero:我们再确认一下,看看为什么这个还在 Pi 里跑。这同样是跑在 CPU 上,加一张 3090。3090 大概一千五,我觉得,一千三也能拿到,甚至压到一千美元。或者用 Intel Arc B70,显存更大,AMD 的卡也行,只要有二十四 GB 显存,其实无所谓。
0xSero:有了这样一张卡,再加上 DDR4 内存,配一块 Gen 4 主板。有 Gen 4 主板、DDR4 内存和一颗还不错的 CPU,整机大概八千美元,你就能让 DeepSeek v4.1 flash 跑在这个速度上。这可是个非常大的模型。你也可以换一个聪明程度差不多的模型,跑到每秒六七十个 token。如果真需要速度,可以在那张 3090 上跑 Qwen3 27b 之类的,每秒两百个 token,推理非常快。我自己用得挺多的,剪视频、做视觉素材、折腾家里的服务器。
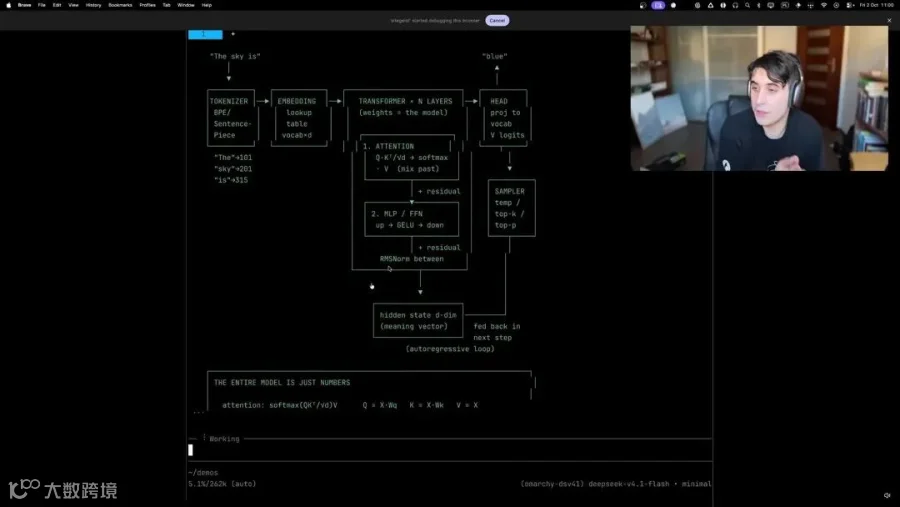
几个月前在 CPU 上跑出这个速度是不可能的,因为你要明白,CPU 每个线程一次只能执行一件事,而 GPU 能并行成千上万件事,可能上百万,我不确定具体能跑多少线程,每张 GPU 都不一样。但这东西跑得比一年前的模型还快,说明你完全可以蹲 eBay 淘一套,机器扔在那儿就行,非常稳定。我试过极限情况,同样的模型放在四张 RTX Pro 6000 上,那基本是十倍的价钱。你能告诉我什么是 LLM,并用 ASCII 画出来吗?不要调用任何工具,只解释。这就是差距,用 6000 跑的差距。而这边还同时开着多个会话,代码那边一直在干些蠢事,一直不停。
总之你们应该看过那个视频了。我再找找另一个。还有一个我想给你们看的,基本是同一个提示词,我让它做一个 HTML 可视化。全程都在 CPU 上。做研究的时候它真的挺好用,这是我自己的使用感受,找资料、深挖、用浏览器、操作电脑都挺强。就是太慢了,每秒三十个 token,其实平均速度就是这样,三十三左右,现在这速度简直没法忍。而我在本地能跑到每秒两三百 token。当然那很贵,大多数人没有那种硬件,但它每天都在变好。我觉得再过一年左右,大家会有比过去便宜得多的选择。
0xSero:对,我特别特别烦。不过 Opus 对我来说一直特别好用。我让它给我做一个 3Blue1Brown 那种交互式可视化,讲量化是怎么运作的,用 HTML 放在浏览器里,右边再放一个 wiki,让我能学到各种不同的量化格式。尽量快点做。但话说回来,你要是有一台游戏本、一台游戏台式机,里面那块显卡可能就值得一用。如果你已经有硬件,有内存,只是很久没试过 CPU 卸载,那就拿我 GitHub 上的仓库,随便挑一个,扔给 Claude 之类的,它很快就能帮你跑起来。这回出来的数据质量很高,右边一边聊一边把所有数学过程都显示出来,你能看到每一步在干什么,非常好。16G 显卡,64G 内存。我觉得你可以试试 Qwen 3.8 Next Flash。也许吧,但得用 2.5 比特或者 3 比特。不行,3 比特装不下,得压到 2.5 比特。
整机配置:CPU加24GB显卡跑DeepSeek
听众A:你测试推理用的是哪些 CPU?
0xSero:做这种内存卸载,我用的是 ROMED8-2T 主板,有七个 PCIe 插槽,基本能用上四个。如果用转接线和拆分卡,一个机架能上到十六个,但我觉得不值,电费太高了。CPU 是 EPYC 7443P。
0xSero:这就是整套配置,我当初买的时候就是这个,大概是去年七月买的——不对,那是三个月前,所以是八月。512G 的 DDR4 花了差不多两千三百美元。现在大概要四千了,因为内存:DDR4 在跌,服务器用的 DDR5 也在跌,但跌也就是几个百分点,还是很贵。这套能跑什么?能跑 Qwen 3.8 Next Flash,或者 GLM 5.3 Flash。
0xSero:我也把 GLM 5.3 Flash 用 CPU 卸载跑起来了,跑到多少来着,大概每秒 30 个 token,昨天刚试的。所以用力压一压,每秒 30 到 40 吧。当时买的是华擎那个 Roam 主板,还有 3090。我觉得一张就够。
0xSero:EPYC 7443P,整套东西加起来我花了大概一万两千美元,但大头其实是 3090。扣掉六千的话,跑这个模型最少大概六千五。内存频率好像是 2400。
0xSero:好,这是我在 RTX Pro 6000 上跑的那个。大家有什么问题吗?
听众B:我有一个。你刚说你用 Superwhisper,为什么选它而不是 OpenAI Whisper?还是说只是你一直用这个?
0xSero:就是当时手上有什么就用什么。
听众C:对,我有个相关问题。你说一年前花两千五左右买了半 T 内存。我也一直在看便宜点的,比如波兰的 OLX 上有很多更便宜的,但是二手的,没有保修之类的。你买的是全新的、带保修的吗?
0xSero:不是,我觉得那不重要。只要你在做这事就行。我不知道 OLX 的消费者保护规则怎么样,如果它的用户保护规则还不错,得当面交易,那你就尽量照着来。二手没关系,大部分本来就是二手的。这内存很老了,所以才便宜,整体上更划算。它那边显示大概是两万三。
0xSero:五千美元左右,对,差不多这个数。要拿下得六千五到七千。但你也得看它还能干别的什么。
让我在 Omarchy 里做一个应用,显示我 CPU、内存和所有显卡的全部状态,就像个仪表盘,把各项数据和占用情况都列出来,也许再加上 NVMe,我猜有两块 NVMe,也可能只有一块。我会建议你买点系统内存,配一张显卡,便宜的就够,然后装个 Pi 或者 OMP 之类的,用起来试试。
好,模型又跑起来了,谁也踢不掉它。刚才它崩了,我只好把速度降了一点,现在每秒少四个 token。这事得在我 MacBook 上做,太傻了。
你怎么看新的 DGX Spark,那个 64G 的?RTX 我觉得挺可预期的,会是个跑小型混合专家模型的好机器。你内存越小,它给你的优势就越小。因为如果价格一样,比如说一张 3090,或者两张 3090,对比一台三四千美元的 DGX Spark,那肯定还是买更快的划算。我在考虑搞一台 256G 内存的 M5 Ultra。
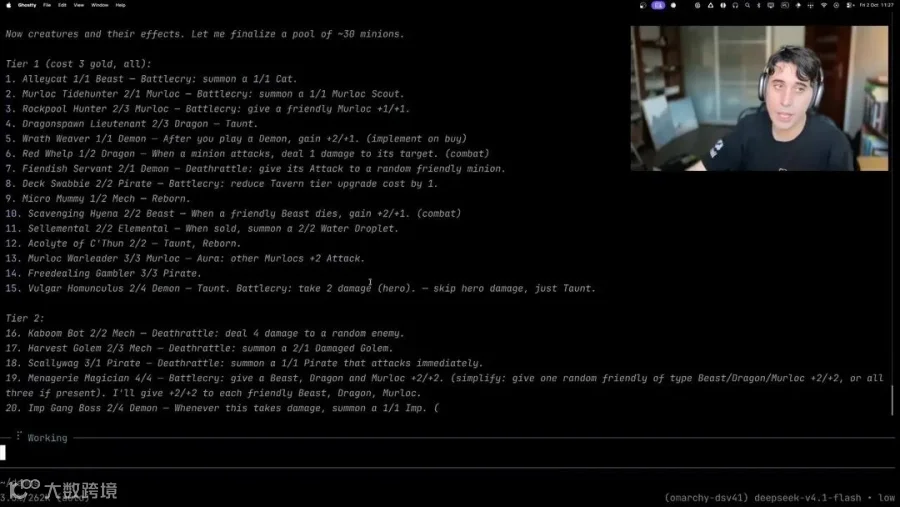
现场演示:浏览器Agent与酒馆战棋克隆
0xSero:我觉得那对你来说就是最好的选择,因为 DeepSeek 是用 C 写的。看,出来了,开始跑。我们问它点什么?有人有 prompt 可以扔给我吗?另外提醒一句,你应该尽快上 256G 内存,不然价格又要涨一波。谁给我个 prompt,让我扔进去试试。
听众D:有。做一个能在浏览器里跑的炉石传说酒馆战棋的仿制品。
0xSero:我先确认它是低思考模式。好,这回又是全跑在 CPU 上。我刚才为了加速加了个东西,结果它崩了,所以只好降一点速,但应该还行,凑合能用。出来了,跑起来了。这是稳定版,或者说是一个能让我赚几百万的生意。别出错。
这种想法的问题在于,生意本身不是赚钱的那个东西,它只是个叫法。你得自己去卖东西,没人会主动来买。我不知道该怎么解释——你得做出点东西来。你知道我们多少人手里攒了三十个项目,全是垃圾,没人会碰、没人会用,还占着机器空间。我们自己都不用,别人凭什么用?
现在跑多快?我觉得这个大概得跑十五分钟才能完,甚至更久,希望别拖到一个小时,看它推理多少了。我再看一下质量。你说吧,有人想说点什么。
听众A:抱歉。你测过不同的 CPU 和内存吗?
0xSero:没有,我只有一颗 CPU。
听众A:对,要是我有更多,测一下这里到底是算力更重要还是带宽更重要,会挺有意思。
0xSero:好,我明白你的意思。顺便说一下,我刚看了一眼,现在解码是每秒 15 个 token,预填充是每秒 1450 个 token,这数字太夸张了,简直不可思议。GLM 5。
0xSero:GLM 5 刚发布的时候就是这个速度。你继续说。
听众A:是只有 DeepSeek 这个模型这样,还是别的模型预填充也这么快?
0xSero:预填充的话 DeepSeek 更快,还是因为它本身的结构。但 GLM 5.3 Flash 能跑到每秒 570 个 token。
0xSero:预填充,这是冷启动的状态。另外一个是什么来着——Qwen3 Next Flash 的预填充是每秒两千八百个 token,但它更多部分能塞进显存里,所以。现在你可以拿它做什么,这大概是个很好的思路。比如说你有个做内容的生意,手上有大量视频素材,你想把它们剪出来,这就是我经常干的事。它是一小时做完还是八小时做完,其实无所谓。那我可以去睡觉,把这个任务排上队,它帮我把内容剪好,剪完就发出去。
所以我打开我的 YouTube 工作室。顺便说一句,这些全都是私密的,我把它们全锁了。我再也不想做 shorts 了。我觉得看这种短视频对脑子完全是毒药,尤其是 YouTube 上的 shorts。YouTube 的 shorts 做得太糟糕了,全是赌博式的、乱七八糟的脑腐内容。总之,这是 DHH 的播客。这一整期都是 AI 剪的。它把多条音轨、多条视频流合到一起,做得非常好,而且是在本地做的。它在夜里把它发出去,标签也配好了,标签是它自己查出来的,整个是在我的 6000 上跑的。
所以这个任务同样不受时间约束,三十分钟做完还是三小时做完你都不在乎,只要做完就行。像这种事就很合适。任何你需要做的、比较私密的事情也一样。比如说,假设你是做软件开发的,或者管服务器的,之类的,你某天可能要用到一些安全方面的功能。真到那时候,Claude 说不行,GPT 说不行,你总得用点别的。这种情况比你以为的多得多。也许别人没有,但对我来说是真的,我经常被限制、被卡住,做不了想做的事。
0xSero:所以对我来说这非常有用,这方面我经常用本地模型。另外,我觉得跟一个 AI 交朋友本身就不是好主意,我觉得这不明智。真的像朋友一样天天跟它聊天,可能把它当个帮手聊聊还行,我也说不清,这个话题很复杂。但重点是,如果你要像助手、像朋友一样跟一个 AI 说话,那你最好拥有它,而不是让它归别人所有。如果你的家人归别人所有,那会很怪——我不是说你应该把它当家人,但如果它在帮你打理生活,帮你管邮件、管你的各种事情,那所有权就变得很重要。
抱歉,等一下,我得挪一下头。其实我的头位置挺好的。你看,我们看一下所有 GPU,然后……别,别跑,什么都别跑。行,这样没问题。所以到现在,我们还是有每秒五十个 token 左右。预填充是每秒七百五十到一千个 token。这是 Qwen3 27B 跑出来的。
你用哪个浏览器工具给 agent 用,有推荐吗?我自己写了一个。我知道你可能听腻了,其实也不算我写的。有个插件叫 Sitegeist,是 Pi 的作者 Mario Zechner 做的,他做了 Pi,你们应该知道 Pi。我以前用的是自己那套工具,后来停掉了,换成了 Sitegeist,因为它界面更好看。我在这儿打开它,能跑起来吗?因为我可能把它弄坏了。好,它在这儿,DeepSeek 也在。你能看一下我的 Sitegeist,再看一下上游版本,告诉我有什么区别,然后出一份报告吗?是我设置错了。好,现在有了,它启动了。
我不会去碰浏览器,我的鼠标就放在那儿,我手都举着。Sitegeist 会做网络抓包,我不知道那是什么意思,抱歉,你要是能解释得更清楚点,我可能能回答你。所以你能看到它在浏览器里运行,它能真的去导航、点按钮,你在浏览器里能干的事它都能干。而且它可以通过界面来做,就像你看到的这个界面。你能导航到 HackMD,新建一个 HackMD 文件,然后把你刚做的那段 markdown 加进去吗?
0xSero:所以它能像你自己用浏览器那样去用你的浏览器,它连着同一批网站,非常厉害,用处极大。它为什么离线了?有点怪。可能是我的网络问题,或者 HackMD 在拦它。那我们来试试,好吧。我觉得是 HackMD 在拦 agent。
0xSero:等一下,我们换个别的免费网站,也能做同样的事。要不去 GitHub,建一个 GitHub 的 gist——就是文件上传那个,算了,不说 GitHub 了。好,我们把这次运行暂停,把它解开。对,就是去逆向分析私有 API,监控并复现请求。这个我一般用 Burp Suite 来做,模型那边我就直接告诉它们要干什么,我通常不太在意它们用什么工具,除非它们写的是我要用的代码库。
所以你能看到,它在控制我的浏览器,它导航过去,直接把 gist 建好了。你看。现在想象一下这用在你的邮箱上能干什么。对,我不确定,我以为预填充缓存应该是能用的,但我们看看,别出错。好,它又回到推理了。哦不,哦不。但你们觉得这个可用性怎么样?你们才是实际用它的人,你们感觉如何?

速度与用途:预填充快在哪,适合什么任务
听众A:我觉得需要查资料、做研究这种比较长期的任务可以用它。日常用的话它大概挺慢的,虽然现在的速度其实也差不多够了。但如果我想干一晚上的活,我觉得它完全够用。
0xSero:对,我也这么觉得。我现在做的一切基本都是以目标的形式来跑,大量用 tmux 这类工具。也许它有办法扩展,但到现在为止我还没能让它真正扩起来。你可以开多个会话,是可行的,只是非常慢。
KV 池是二十六万上下文,但还能往上加,我挺确定我想要的话能到一百万。而且在更长的上下文下它也不会变慢,因为我优化了很多 kernel,所以它就一直跑。这个到今天结束我觉得还能再快百分之五十。
确实会崩,过了七万八千左右就开始崩,是 GPU 换页的某个问题,是我这边的原因。现在它在看那个文件夹,在决定要做什么,我大概不该去打断它干活。叫它别推理,效果并不好。
你们还有别的问题或者要求吗?结尾我肯定会分享一个视频,把结果放出来:第一次,第二次。好,那我觉得就到这儿了。总结一下我们聊的东西:我们聊了模型,聊到模型确实已经追上了所谓的前沿,聊到我们可以用快得多的速度跑模型。没听到的最后那个问题,算了,不说了。总之你可以在更便宜的硬件上用更快的速度跑模型。量化在变好,而且 CPU 和内存现在真的挺可用,就像你左边看到的这样。希望这些对你们有帮助。谢谢大家抽时间过来,回头见,拜拜。
原视频:How I run huge models on the CPU (Deepseek-v4.1-flash)
https://www.youtube.com/watch?v=XtM-Y8eHM_A
中文播客:在小宇宙App搜《播客快译》
编译:磊哥Thomas