


经过两年多的谈判、批评,甚至遭到互联网巨头的抵制,终于迎来了这一天:欧洲议会以348票赞成、274票反对的结果通过了第13条(现更名为第17条)。
随着第13条的实施,互联网将迎来一场彻底的变革。该法规旨在强制Facebook或YouTube等数字平台在发生版权侵权时支付赔偿金;若无法赔偿,则需屏蔽大部分在线分享的内容以避免法律纠纷。
第13条不会立即生效,因为还需要欧盟理事会的批准,之后由28个成员国在两年内将该指令纳入各自的立法中。然而,欧盟委员会的批准是使其获得通过的关键一步。
第13条充满争议的通过之路
你还记得吗?2018年7月4日,维基百科发起了一场抗议活动,反对第13条所代表的审查制度。用户无法在其页面上搜索信息。事实上,虽然欧盟希望内容创作者因其工作得到认可和报酬,但有许多个人和企业要求一个自由且无审查的互联网。
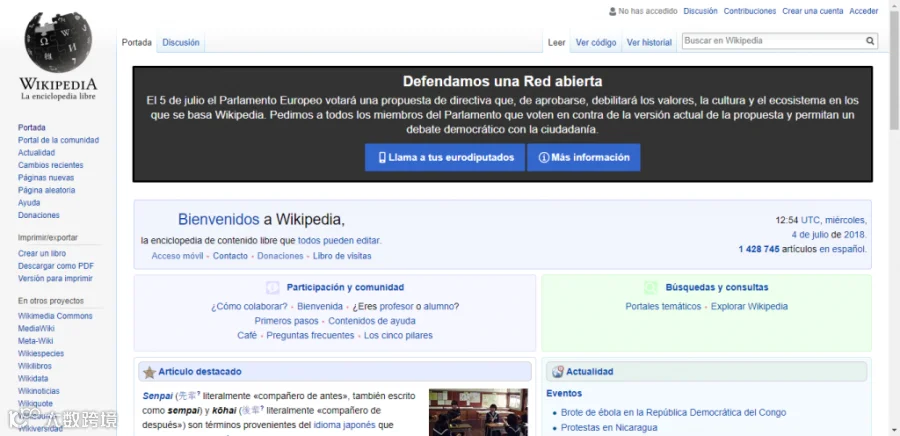
在此事件之后,欧盟修改了第13条的文本,并增加了一项针对维基百科等机构的例外规定以及其他成立不足三年的小型企业。
对于像Menéame或Digg这样的内容聚合器,可以分享新闻片段,但不能包含完整文本,而媒体可能会就其内容的使用索取补偿。在这方面,Wikimedia警告称,这一法规豁免不仅模糊不清,而且不足:
今天,欧洲议会以348票对274票通过了一项新的版权指令,这将损害自由知识。我们认为这是一个令人失望的结果,其影响必将在未来几年内持续显现。
— Wikimedia Foundation (@Wikimedia) March 26, 2019
新版权法将如何影响用户
为了了解新的版权法规,只需回顾一下Facebook在审查暴力或色情内容时遇到的问题,例如那张被称为“凝固汽油弹女孩”的照片。这将是新自动化系统的一个小例子:一个能够自主审查的算法。未经事先指令或任何人类介入,该算法将自主决定对互联网上上传的所有内容进行审查,无需人工干预即可屏蔽其认为侵犯作者版权的内容。
第13条:审查算法与Content ID的先例
迄今为止,搜索引擎和内容分享平台允许用户上传和查找任何内容,除非内部政策或法官要求,否则没有删除义务。而现在,在《第13条》的保护下,这些企业将通过自动化算法过滤用户上传的内容或链接,以追踪并搜寻侵犯版权的材料(视频、图片或文本)。
这项法规并未明确数字企业应如何行动以保护版权。总体思路是每款平台开发自己的受版权保护内容识别系统,例如备受争议的Content ID(即YouTube目前用于识别用户上传内容中受版权保护的视频或音乐的系统)。该系统曾在视频创作者中引发巨大争议,正如其中一位创作者Keunam此前向我们解释的那样:
“YouTube先封锁再询问。西班牙的法律立法非常糟糕,因为如果是短视频且你明确表示这是恶搞,你就可以使用它;这是基于另一作品的新创作,因此我的作品被退回,但话说回来,他们在仔细调查之前会先进行封锁。””
如果这是在不同平台上保护版权的方式,那么这些系统将必须包括图像、声音和文本识别,以便在检查内容时检测是否使用了受保护的作品。
第11条:Canon AEDE的回归
另一方面,新法规的第11条借鉴了Canon AEDE(西班牙谷歌税)的理念,并将其扩展到整个欧盟。该条款旨在赋予媒体编辑对其内容更大的权力,因为他们将有权就链接其内容索取经济补偿。
当然,这不仅在平台之上强加了一项难以实现的、部署无懈可击且快速自动算法的任务,还侵犯了言论自由。
那么模因(memes)呢?
许多 模因和动图 并非以营利为目的生成,而是基于第三方内容创作的。考虑到这一点,已决定允许旨在模仿内容以用于教育或幽默目的的作品继续流通,包括parody(戏仿),这些作品可以继续传播。当然,模因将不受该规则约束。
然而,一个必须面对的重大问题是,互联网平台开发的过滤器和检测工具可能无法区分恶搞与真正违反法规的内容,从而预防性地对其进行限制……
反对这些措施的人指出谷歌税在西班牙和德国产生的负面影响,因为绝大多数用户拒绝了它,而且它非但没有帮助小型编辑者,反而对他们造成了损害。
总体而言,人们对新法规的看法是,互联网可能从一个开放、富有创造力且便于分享的平台,转变为一个由控制和专制主导的地方,因为法律未能区分那些利用他人劳动牟利的人与普通用户。
图片来源:Depositphotos