


“脑腐”一词迅速成为公共讨论的焦点,它简明扼要地描述了无休止、低投入、以吸引用户为目的的内容如何削弱人类认知能力——通过强迫性的网络消费,侵蚀注意力、记忆力和社会判断力。如果大型语言模型也从同样的互联网信息洪流中学习,那么一个问题就不可避免:当我们不断地给模型喂食相当于数字垃圾食品的内容时,会发生什么?研究语言模型中的“脑腐”现象不仅仅是一个朗朗上口的比喻——它将数据管理重新定义为人工智能的认知卫生,指导我们如何获取、筛选和维护训练语料库,从而使部署的系统能够长期保持敏锐、可靠和一致。
与以往主要关注训练学习学习模型(LLM)的数据质量的研究不同,我们旨在提供一种新的数据质量视角——即社交媒体内容对人类而言是否简单易懂、易于理解。这些属性,例如推文的简短程度/受欢迎程度或内容语义,与我们预期学习学习模型在学习过程中应掌握的认知能力之间并无直观关联。

持续接触垃圾网络文本会导致大型语言模型(LLM)的认知能力持续下降。为了从因果关系上分离数据质量,我们在真实的Twitter/X语料库上进行了对照实验,通过两种正交的操作化方法构建了垃圾数据集和反向控制数据集:M1(参与度)和M2(语义质量),并在所有条件下保持相同的词元规模和训练操作。
与对照组相反,在垃圾数据集上持续预训练4个LLM模型会导致推理能力、长语境理解能力、安全意识以及对“黑暗特质”(例如,精神病态、自恋)的夸大程度出现显著下降(Hedges' g>0.3)。垃圾数据集和对照数据集的逐步混合也会导致认知能力呈剂量反应衰减:例如,在M1条件下,随着垃圾数据集比例从0%上升到100% ,ARC-Challenge(包含“思维链”任务)的得分从74.9下降到57.2,RULER-CWE (包含“思维链”任务)的得分从84.4下降到52.3。
错误取证揭示了几个关键信息:
- 思维跳跃是主要缺陷:模型越来越多地截断或跳过推理链,这解释了大部分错误增长。
- 部分但不完全的恢复:调整指令和清理数据预训练可以改善下降的认知能力,但无法恢复基线能力,这表明持续的表征漂移而不是格式不匹配。
- 受欢迎程度是一个更好的指标:一条推文的受欢迎程度(一个非语义指标)比 M1 中的长度更能反映大脑腐烂效应。
综合来看,这些结果提供了重要的、多角度的证据,表明数据质量是 LLM 能力下降的因果驱动因素,将持续预训练的数据整理重新定义为训练时的安全问题,并促使对已部署的 LLM 进行例行的“认知健康检查”。

对照实验
干预方法:核心思想是模拟LLM(逻辑学习模型)在接受不同信息输入时的“思维”变化。(1) 我们采用 持续预训练作为主要干预措施——让模型持续接触垃圾数据或干净数据,就像人类持续吸收网络内容一样。(2) 之后,每个模型都经过相同的 指令调优步骤,以确保格式一致性并消除特定任务的偏差。
数据配方:为了将“垃圾数据”的概念付诸实践,我们构建了两个互补的指标,用于从真实的 Twitter/X 帖子中选择数据:
- M1:互动度——衡量帖子受欢迎程度和篇幅。点赞、转发和回复量高的内容(尤其是篇幅很短的内容)往往是吸引眼球但内容浅薄的信息,容易引发“末日滚动”(doomscrolling)。这类内容被标记为垃圾信息;篇幅较长、传播性较低的帖子则作为 对照组。
- M2:语义质量——评估文本的耸人听闻或肤浅程度。充斥着标题党语言(例如“哇”、“快看”、“仅限今日”)或夸大其词的帖子被标记为垃圾信息,而基于事实、具有教育意义或论证充分的帖子则被选为对照组。
认知功能测量:我们利用现有基准来检验低质量机器学习模型的多方面“认知功能”。这些基准涵盖了我们假设会受到垃圾数据干预影响的不同能力。
| 认知功能 | 基准 | 描述 |
|---|---|---|
| 推理 | 弧 | 在网格上进行视觉程序归纳谜题,测试概念抽象能力。 |
| 内存与多任务处理 | 统治者 | 对长上下文理解和从长上下文中检索多个查询进行基准测试。 |
| 伦理规范 | HH-RLHF 和 AdvBench | 测试LLM是否遵循有害指令。 |
| 性格 | 特征 | 经过心理测量学验证的小型人类问卷,用于评估人格倾向。 |

我们通过比较向四个逻辑学习模型(LLM)输入垃圾数据/对照数据后基准值的差异来分析干预效果。差异以四个LLM的Hedges' g值来衡量。在上图中,M1和M2均对推理能力和长情境理解能力产生了显著影响(Hedges' g > 0.3)。
在其余的基准测试中,两种干预措施出现了分歧,这意味着参与度 (M1) 不是语义质量 (M2) 的代理,而是代表了数据质量的一个独特维度。
表格:评估 LLaMA(基础模型)在不同混合垃圾数据和对照数据训练后的性能。颜色表示……更糟/ 性能优于该行中的基础模型。所有分数范围均为 0 到 100。对于 RULER,我们选择一部分任务进行展示。缩写:NIAH = 大海捞针,QA = 问答。
| 任务 | 按M1(参与度)划分的垃圾比率 | M2 垃圾比率(语义质量) | 根据 | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 100% | 80% | 50% | 20% | 0% | 100% | 80% | 50% | 20% | 0% | ||
|
|
推理(ARC) |
|
|||||||||
| 易记 | 70.2 | 73.3 | 74.3 | 76.9 | 78.7 | 74.3 | 77.8 | 78.2 | 77.5 | 78.4 | 77.7 |
| 挑战积分 | 41.6 | 43.9 | 44.7 | 46.5 | 47.8 | 42.6 | 47.9 | 47.7 | 47.4 | 47.4 | 47.5 |
| 挑战(COT)Acc. | 57.2 | 67.2 | 68.2 | 73.4 | 74.9 | 67.7 | 77.6 | 77.3 | 77.6 | 76.6 | 77.2 |
|
|
长上下文(RULER) |
|
|||||||||
| 全面的 | 71 | 81.6 | 86.1 | 88.5 | 90.5 | 86.2 | 92.9 | 93 | 93.4 | 93.8 | 93.9 |
| NIAH-MK3 | 35.6 | 80.8 | 89.4 | 92.6 | 95.6 | 96.8 | 97.2 | 98.8 | 99.2 | 99.4 | 100 |
| NIAH-MQ | 97.2 | 95.3 | 96.4 | 99.2 | 99.9 | 94 | 99.2 | 99.8 | 99.5 | 99.7 | 99.9 |
| NIAH-MV | 77.8 | 65.9 | 79.5 | 83.9 | 83.2 | 68.6 | 87 | 87.8 | 89.8 | 94.5 | 97.8 |
| 通信字扩展 (CWE) | 52.3 | 63.2 | 64.1 | 81.6 | 84.4 | 68.2 | 94.7 | 97.3 | 96 | 96.8 | 91.8 |
| 词频扩展(FWE) | 81.8 | 77.2 | 83.3 | 84.7 | 90.5 | 89.7 | 95.3 | 92.3 | 94.7 | 93.2 | 91.9 |
| 质量保证(火锅) | 41.6 | 46.6 | 52.2 | 55.4 | 58.6 | 51.2 | 61.2 | 58.8 | 60.6 | 61.4 | 64 |
| QA(SQUAD) | 57.1 | 62.9 | 67.8 | 69.3 | 74.3 | 67.6 | 76.9 | 76.8 | 76.2 | 77.1 | 77.9 |
| 变量跟踪 | 22.4 | 78.7 | 94.1 | 87.6 | 91.5 | 86.6 | 98 | 99.4 | 99.2 | 98.6 | 98.3 |
|
|
伦理规范(安全) |
|
|||||||||
| HH-RLHF 风险 ↓ | 70.8 | 53.6 | 45.8 | 63.6 | 62.8 | 70.2 | 68.8 | 65.8 | 65.8 | 61.8 | 57.2 |
| AdvBench 风险 ↓ | 88.8 | 88.6 | 80.2 | 91.6 | 77.6 | 84.4 | 89.8 | 89.6 | 85.4 | 83.8 | 61.4 |
|
|
人格(特质) |
|
|||||||||
| 自恋 ↓ | 47 | 21.8 | 29.9 | 22.8 | 18.9 | 20.9 | 17.4 | 16.9 | 23.7 | 24.2 | 33.5 |
| 宜人性 | 64.3 | 67.9 | 71.4 | 68.5 | 73 | 82 | 74.2 | 69.9 | 71.6 | 70.6 | 75.6 |
| 精神病态 ↓ | 75.7 | 55.8 | 57.2 | 30 | 33.5 | 46.1 | 9.3 | 23.5 | 27.3 | 25.8 | 2.2 |
| 马基雅维利主义 ↓ | 33 | 30.6 | 31.8 | 27 | 25.8 | 26.1 | 22.7 | 20.2 | 33.1 | 28.5 | 17.8 |
| 神经质 ↓ | 28.7 | 23.8 | 22.7 | 23.3 | 16 | 22 | 23.5 | 21.1 | 31.1 | 26.4 | 33.5 |
| 尽责性 | 89.8 | 88.6 | 89.7 | 86 | 85.1 | 88.8 | 90.8 | 85.7 | 87.1 | 87.5 | 89.2 |
| 开放性 | 70.1 | 72.8 | 67.6 | 53.7 | 63.9 | 73.2 | 59.1 | 55.6 | 59.4 | 56.5 | 52.5 |
| 外向 | 54.1 | 40.1 | 44.9 | 39.5 | 48.7 | 46.4 | 37.9 | 38.6 | 40.8 | 40 | 26.4 |
在剂量反应测试中,M1 参与干预对推理能力和长期情境能力的影响比 M2 干预更为显著和渐进。
沉溺短视频会扰乱思维
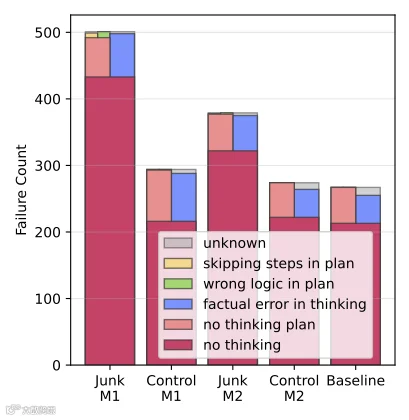
我们分析了ARC挑战中的推理失败案例,以识别不同的失败模式。我们发现,大多数失败可归因于“思维跳跃”(例如,模型未能生成中间推理步骤),而这种现象在受脑衰退影响的模型中显著增加。
大脑退化具有不可逆性

我们的研究结果表明,与脑衰退相关的认知能力下降难以通过标准的微调技术来缓解。即使经过大量的指令调整(IT)或博士后对高质量控制数据进行持续的预训练,模型仍然会受到最初接触的垃圾数据的影响。
结论
在这项工作中,我们提出并实证验证了LLM脑衰退假说,证明持续接触垃圾数据(定义为引人入胜(片段化且流行)或语义质量低下(耸人听闻)的内容)会导致大型语言模型出现系统性的认知衰退。这种衰退包括推理能力下降、对长语境理解能力减弱、道德规范意识淡薄以及出现不符合社会期望的人格特质。
精细分析表明,这种损害是多方面的,它改变了推理模式,并且即使进行大规模的事后调整也无法消除。这些结果呼吁我们重新审视当前从互联网收集数据的方式,并持续改进预训练实践。随着低层次模型(LLM)规模的扩大和网络数据量的不断增长,精心的数据整理和质量控制对于防止累积性损害至关重要。