阿波罗新上线公众号:分享实战案例拆解

正文
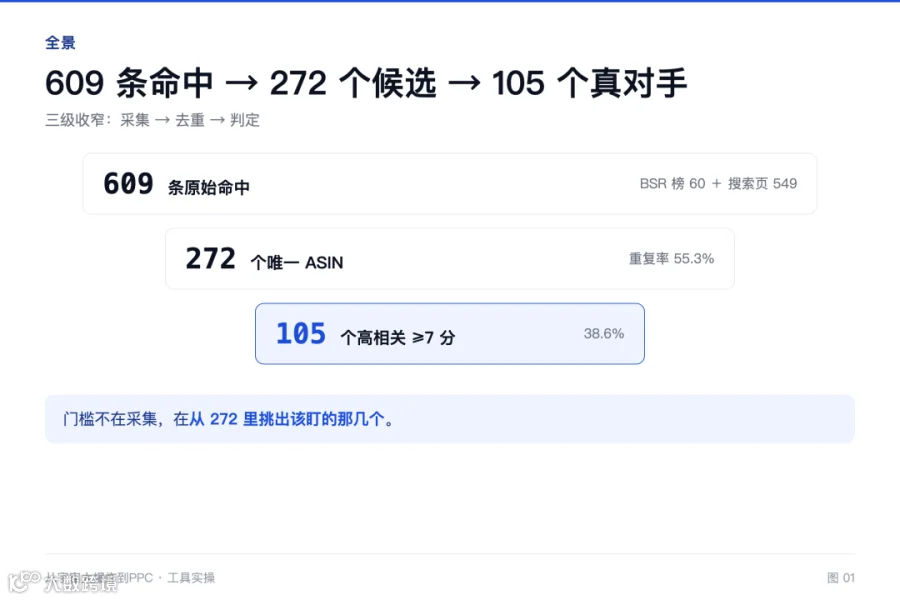
609 条原始命中,去重后 272 个 ASIN —— 我拿一个制冰机的链接,把亚马逊上跟它抢流量的对手全扒了一遍。
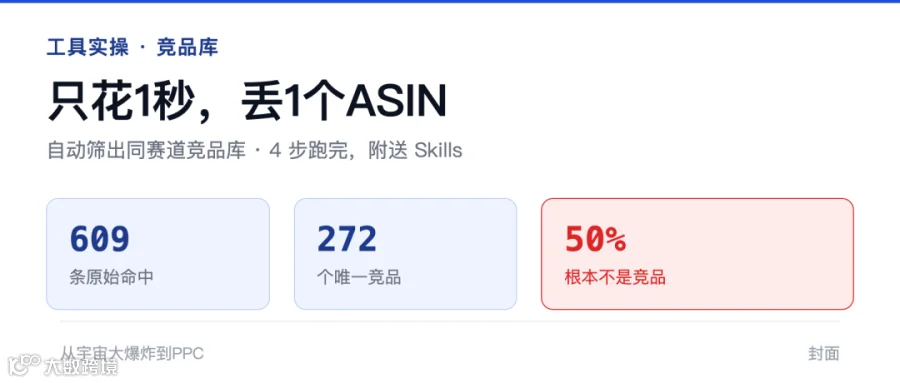
结果是这样的:这 272 个候选里,够得上“直接竞品”的只有 58 个,占 21.3%。
剩下的 214 个呢?配件 46 个、替代方案 78 个、八竿子打不着的 12 个,还有 11 个是我自己品牌的其他型号。
这就是我想跟你聊的一件事:搭竞品库最难的一环在筛选,不在采集。爬一屏回来太容易了,难的是爬回来之后,没人告诉你这三百个里哪几个才值得盯。
这篇文章把我搭的这套流程完整拆给你:从一个 ASIN 出发,把爬取、去重、判定这三件事串成一条流水线。文末附送这套 Skills。
一、竞品分析是单点动作,竞品库是基础设施
先说个容易被混掉的区别。
竞品分析解决的是“这个对手最近为什么涨”,看三五个就够了。
竞品库解决的是“我这条链接在整个赛道里,到底在和谁抢”,需要一份长期维护的名单。
前者靠眼睛,后者靠流水线。用做前者的方式做后者,你会累死,而且做不全。
我见过太多人的“竞品库”是这么攒的:打开搜索框,搜个大词,把前两页眼熟的抄进表格;过两周想起来再补一次。
这份表格有三个先天缺陷。
它永远不全,因为搜索页只给你二十来个位置,你抄完第一页,第二页的对手已经在吃流量了。
它没有去重,同一个对手会在五个关键词里各出现一次,你表格里就记了五遍,看起来“对手很多”,实际是五个人穿了五件衣服。
第三条最坑,叫“它没有判断”。抄完一屏,你没法一眼看出哪个是对位的,哪个只是类目碰巧一样。
我用实测数据告诉你为什么这一条最贵。
我抓的这个 ASIN 是做台面制冰机的,类目挂在 Appliances > Refrigerators, Freezers & Ice Makers > Ice Makers。
如果我偷懒,直接用“类目等于 Ice Makers”当筛子,会发生什么?
筛出来的名单里会混进 3,100 到 9,450 美金的商用制冰机,Hoshizaki、Manitowoc 这些牌子。它们和我的台面机在同一个类目节点下,但它们面向的是餐厅后厨,不是家庭厨房。你把它们写进竞品库,再花时间去研究它们的定价策略,这时间全是浪费的。
反过来也有:跟你抢同一批搜索词的对手,可能根本不在你这个类目节点里。它们的类目可能挂得跟你不一样,但搜 nugget ice maker 的时候,它们就排在你旁边。
所以类目是个假筛子。它太粗,会把商业机混进来;它又太死,会漏掉类目不同但流量重叠的人。
那什么才是真筛子?
答案是:你得逐个看它跟你的关系。不看类目,看它能不能抢走同一批搜索流量。
这句话听着像废话,但它直接决定了工具该怎么搭。因为“逐个看”就是几百次判断,人工做不完,这才是整件事的技术难点。
二、别用大模型一个个问“这个是我竞品吗”
这是我一开始走进的岔路,也是这整套工具里最重要的一个认知翻转。
我一开始真拿大模型试过。把自家 Listing 和候选商品丢进去,问“这两个是不是同赛道竞品”。跑了几十条我就停了,原因有三个。
慢。每个候选都要等它完整生成一段话,272 个候选排队等,黄花菜都凉了。
贵。每条都是一次完整推理,token 哗哗地烧。
会飘。最要命的是这个,同一个候选,换个问法、换次脾气,它可能给你两个答案。
而竞品库是要长期维护的东西。今天的标准和下周的标准不一致,这份名单就废了。
问题的本质是:我把一个判断题,交给了一个作文机器。
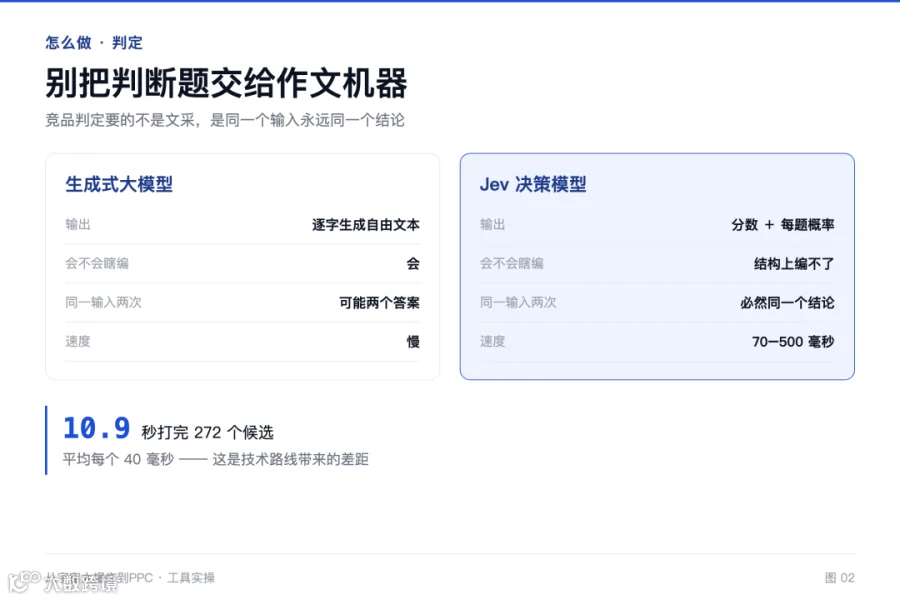
生成式模型的核心能力是“把话说清楚”。它一个字一个字往外蹦,天生擅长写长文。但竞品判定需要的是稳定性:同一个输入,永远给同一个结论。
这就引出了我最后用的东西:Jev。
Jev 是 TypeSafe 做的一个决策模型,官方叫 System One。它和生成式大模型是两条完全不同的技术路线:
|
|
生成式大模型 |
Jev(决策模型) |
|---|---|---|
输出 |
逐字生成的自由文本 |
只返回「打几分 + 每个分数的概率」 |
会不会瞎编 |
会 |
结构上编不了,只能在给定选项里选 |
同一输入两次 |
可能两个答案 |
必然同一个结论 |
慢 |
一个请求 70 到 500 毫秒 |
实测下来,272 个候选,Jev 打完分只用了 10.9 秒,平均每个 40 毫秒。这个速度差来自技术路线的不同。
三、四步流水线:从一个 ASIN 到一个竞品库
铺垫说完了,下面是具体怎么搭。整套东西我拆成四步,每一步只干一件事。
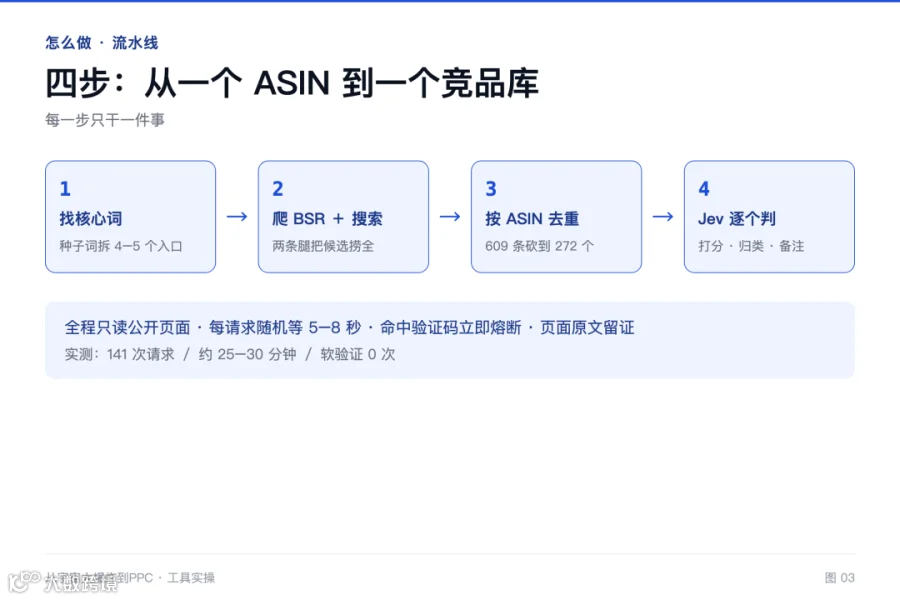
第一步:找核心词,从一个种子词拆成四五个入口
你只有一个 ASIN,得先知道从哪些口子进去才能遇到对手。
先看你自己的 Listing 标题和类目,提炼出一个种子词,比如 ice maker。再把它拆成四到五个覆盖不同形态的核心词。我这次用的是 countertop ice maker、nugget ice maker、portable ice maker、bullet ice maker、ice maker machine。
为什么非要拆这么多个?因为一个大词只能覆盖一种表述习惯。搜 nugget ice maker 的人和搜 bullet ice maker 的人,需求不一样,遇到的对手也不一样。只用一个词,你的竞品库天然缺一半。
我实测这五个词的命中量非常均匀,每个词的 5 页都是 109 到 110 条,说明它们各自都代表了一个真实的流量入口,没有凑数。
第二步:爬 BSR 榜加搜索页,两条腿走路
这一步是把候选捞全。
第一条腿是 BSR 榜:从你自己的详情页里找到最细一层的类目节点,然后爬这个类目的榜单。第二条腿是关键词搜索页:每个核心词爬前 5 页搜索结果。
为什么要两条腿?BSR 榜代表“卖得好的”,搜索页代表“搜得到但未必卖得好”。只爬搜索页,你会漏掉那些不投广告但自然排名很稳的老对手;只爬 BSR 榜,你会漏掉正在冲量的新玩家。

我这次跑出来的原始数据:
来源 |
量 |
|---|---|
BSR 榜前 2 页 |
60 条 |
5 个核心词 × 各 5 页 |
549 张卡片 |
原始命中合计 |
609 条 |
第三步:按 ASIN 去重,这一步砍掉一半以上
这是最被低估的一步。
609 条原始命中里,有大量重复。同一个对手会在 countertop ice maker 第 1 页出现,又在 portable ice maker 第 3 页出现。去重之后剩 272 个唯一 ASIN,重复率 55.3%。
换句话说,如果你手动抄表格,你有一半以上的行是同一个人的不同影子。
去重的时候别只做减法,顺手记三个东西,它们后面非常有用。
出现频次。这个 ASIN 被几个关键词、几页命中过。被越多入口命中的,越是真对手。实测 272 个里,只有 82 个被 3 次以上命中。
最好位次。它在所有搜索页里排得最靠前的那一次。
来源标记。它来自 BSR、搜索,还是两边都有。实测有 52 个是“只在 BSR 榜、搜索页完全没出现”的,这批往往是被忽略的隐形对手。
第四步:让 Jev 逐个判,打分、归类、给理由
到这一步,你手上是一份 272 行的 ASIN 名单。现在让机器读它。
我给 Jev 提了三组问题。
第一组打几分,一到十,看它和我抢同一批搜索流量的程度。
第二组归哪一类,六选一。
第三组是一个断言,“这个商品是我的直接竞争对手”,让它给出概率。
这里有个设计上的讲究,值得单独说:备注不是模型编的。
普通大模型会给你一句很漂亮的话当理由,但你没法验证。我的做法是让 Jev 只负责打分和归类,理由由代码按证据拼装:类目是否一致、标题命中了哪几个核心词、品牌是否相同、价格差多少。
所以最后每条备注长这样:
B0C4YHDX3Q | 9.8 分 | 直接竞品
类目「Ice Makers」与目标一致;标题命中核心词「countertop ice maker」;品牌不同(Silonn vs EUHOMY)→ 抢同一批搜索流量,是最该盯的对位竞品
每一句你都能自己回去核。
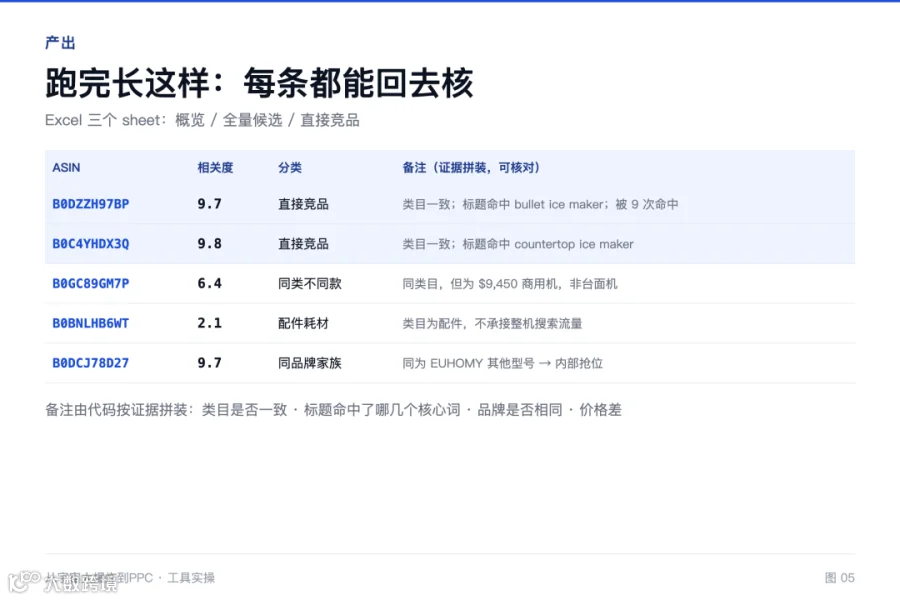
四、跑完长什么样(这是真实结果,不是示意)
272 个候选,Jev 打完分,分布是这样的:
档位 |
个数 |
占比 |
|---|---|---|
高相关(7 分及以上) |
105 |
38.6% |
中相关(5 到 7 分) |
29 |
10.7% |
低相关(5 分以下) |
138 |
50.7% |
六类归类的结果更说明问题:
分类 |
个数 |
占比 |
|---|---|---|
替代方案 |
78 |
28.7% |
同类不同款 |
67 |
24.6% |
直接竞品 |
58 |
21.3% |
配件耗材 |
46 |
16.9% |
无关 |
12 |
4.4% |
同品牌家族 |
11 |
4.0% |
把配件、替代、无关加起来,是 136 个,正好占一半。

这就是我开头那件事的完整证据:你要是手动扒一屏回来,这份名单里一半的东西根本不是你的竞品。
三种最典型的“假竞品”值得点名。
第一种是配件耗材,比如“制冰机水泵替换件”、“冰格硅胶垫”。它们会出现在同一个搜索结果里,但它们不卖机器,跟你不在一个生意上。
第二种是替代方案,比如“冰箱用制冰盒”、“威士忌冰石”。它们满足“要冰块”这个需求,但不跟你抢制冰机的搜索词。
第三种最容易被忽略:同品牌家族。这次筛出来 11 个,全是我自己品牌的其他型号。它们确实在跟我抢流量,但那是内部抢位,处理和外部竞争完全不是一回事。
而该盯的那批对手,特征非常清晰。比如被 9 次命中、最靠前一次排第 1 的那个,被 6 次命中的那个,它们同时出现在多个核心词的多个页面里。
这就是“被命中的次数”为什么比“排名”更能说明问题。
五、踩过的坑:反爬和解析
流水线跑通之前,我在这两块上花的时间比写逻辑还多。挑四个最值得说的。
坑一,一个 2KB 的空页面,看起来像选择器写错了。
第一次跑搜索页,解析出来 0 个商品。我以为是页面结构变了,去翻 DOM,翻半天没找到原因。
真相是亚马逊返回了一个 2KB 的空壳页,里面没有商品,只有一行 meta refresh,5 秒后自动跳回原来的 URL。这是个软验证中继页。
它不会触发“机器人拦截”的报警,因为文案对不上。它也通不过解析,因为里面确实没内容。结果是静默失败,你以为是自己代码写错了,实际上是被拦了。
修法是判定“正文小于 60KB 且含 bm-verify”,等 8 秒,用同一个连接重试。
坑二,每次新建连接,就是在告诉对方“我是脚本”。
这个坑对应的是“打开太快、关页面太快”。我一开始用一次性的 HTTP 请求,每次都是新连接、新会话、没有 cookie 延续。对亚马逊来说,这几乎就是脚本特征。
改成持久连接加 cookie 容器,并且开局先访问一次首页热身。效果是改完之后 141 次请求,0 次软验证。改之前,一个小样就吃了一次。
坑三,代理出口在哪,价格就显示哪个国家的货币。
我用代理访问,价格显示成 S$190.28,因为出口节点在新加坡。修法是加一个 cookie 强制美元,i18n-prefs=USD。
顺手提醒一句:如果你也在做跨境数据抓取,币种不对这种事不会报错,只会让你的数字全错。
坑四是最阴的一个,美元金额是按“分”渲染的。
强制美元之后,页面上的价格变成了这样:
页面显示 |
真实价格 |
|---|---|
$3999 |
$39.99 |
$5143 |
$51.43 |
$49999 |
$499.99 |
如果不处理,你会得出“一个台面制冰机卖 5143 美金”这种结论,而且全程不会有任何报错。
我是在核对自家产品价格时才发现的:这台机器的实际售价是 51.43 美元,而工具吐给我的是 5143。
这类错误最危险的地方在于它不吵不闹。
六、这套东西的边界
说了这么多好处,得说清它不干什么,不然你用起来会失望。
它只读公开页面,不登录、不操盘、不改你账号的任何设置。
它给的是判断依据,不是最终决策。高分候选我还是建议你人工扫一眼。机器判得准,但它不知道你的供应链、你的利润结构。
分数是“同赛道相关度”,不是“威胁程度”。一个 9 分的对手可能是个刚上架的小白,一个 7 分的可能是压着你打的老牌。分数只回答“它跟你在不在同一个赛道”。
它需要你有四到五个想清楚的核心词。这一步我建议人工来,因为拆词的角度直接决定了你这份名单的覆盖面。
另外提醒一句关于节奏的。整套抓取我刻意放慢了,每次请求之间随机等 5 到 8 秒,不并发。141 次请求跑了大概 25 到 30 分钟。
这个时间是故意花出去的。慢一点,稳;跑得快被封了,你得重来。
总结
第一,竞品库的难点在“爬回来之后没人告你哪几个是同赛道”,不在“爬不到”。
第二,类目是假筛子。同一个类目里既有 9,450 美金的商用机,也会有不在你类目里、但抢你搜索词的人。
第三,判断这件事别交给作文机器,交给只做判断题的决策模型。它给同一个输入永远同一个答案,还快 40 到 200 倍。
第四,去重属于核心环节,别把它当保洁工作。实测 609 条原始命中里,55.3% 是重复的。
一句话收口:这个工具不帮你“找竞品”,它帮你把一屏噪声压成一张能用的表。
它值不值,就看那 50% 的噪声原来要花你多少时间去筛。
附送 Skills
这套东西我打成了一个 Skills 包,你照着就能搭一套自己的。
包里有什么:
文件 |
干什么 |
|---|---|
crawl_amazon.py |
抓取层:限速、反爬熔断、断点续跑、页面留证 |
build_competitor_lib.py |
步骤一到三:从 ASIN 到去重后的候选池 |
score_competitors.py |
步骤四:Jev 逐个打分 + 六类归类 + 证据化备注 |
export_table.py |
导出三个 sheet 的 Excel(概览 / 全量候选 / 直接竞品) |
run_pipeline.py |
一条命令跑完全部 |
你需要准备两样东西。
一个是你自己的 ASIN,加四到五个核心关键词。拆词的角度我建议你自己定,这是整件事里唯一需要动脑的地方。
另一个是 Jev 的 API key,也就是 TypeSafe 的 System One 决策模型。
四条你必须知道的坑,包里都已经处理好,但你得知道为什么:
bm-verify 软验证页,2KB 的空壳页加 5 秒后自动跳转,看起来像选择器写错了。每次新建连接就是触发反爬,必须用持久连接加首页预热。代理出口决定币种,非美国出口会回本地货币。美元价格是按“分”为单位渲染的,$3999 实际是 $39.99。
里面含全部脚本、两个参考文档(Jev API 口径和反爬实测记录)和一份使用说明。
拿到之后,把 key 配好,一条命令就能跑出你自己的竞品库。

在阿波罗特训营,Lingfei会结合真实账户,带大家拆解广告结构、预算分配和优化决策。不只是告诉你广告怎么调,更重要的是让你知道,为什么要这么调。


首个AI全链路跑通案例:新品14天从0到日销100单
2026-04-27
运营花几天搭建的关键词库, Codex不到1小时完成:亚马逊运营效率正在被重新定义
2026-08-04
提升自然订单,不是多开广告:4步搭建正确广告架构
2026-08-21
亚马逊新规:变体评论不再全部共享,哪些产品会受影响?
2026-08-22
新品一上架就开大预算广告,真的能快速推起来吗?
2026-08-13
亚马逊Listing进入CDQ时代?关于评分、属性和排名,官方到底怎么说
2026-08-12
[案例分享]断货30天 我如何几天做回到日出200单
2026-07-22