


我做这个工作台,起点并不是“让 AI 给我出运营建议”。我手里有四份沃尔玛导出文件,想先解决更基础的问题:同一个数字能否追溯到源文件?三个不同层级的报表会不会被重复加账?一个 ACoS 究竟是怎么算出来的?
下面用我自己的真实导入批次讲完整实现。涉及产品、SKU、Item ID、活动名和单品表现的部分,本文和配图均已去除。

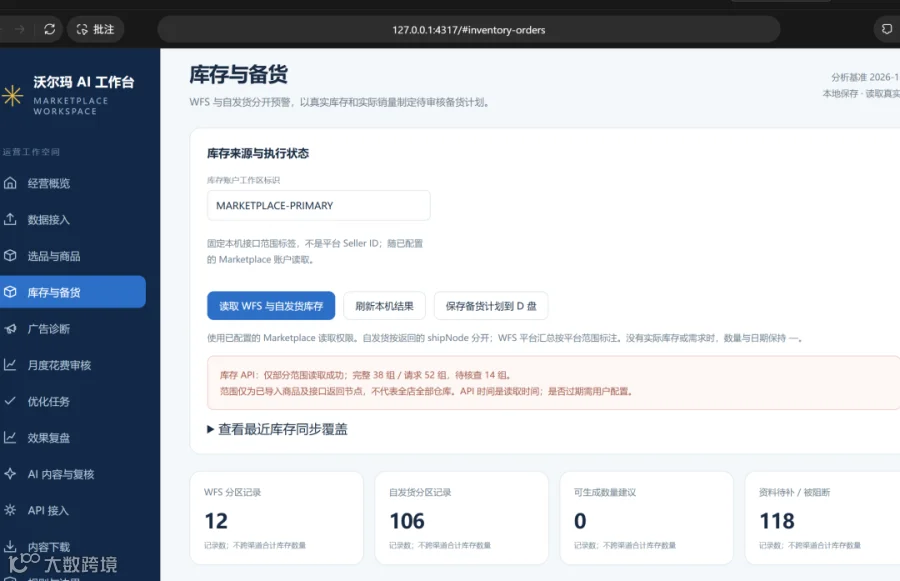
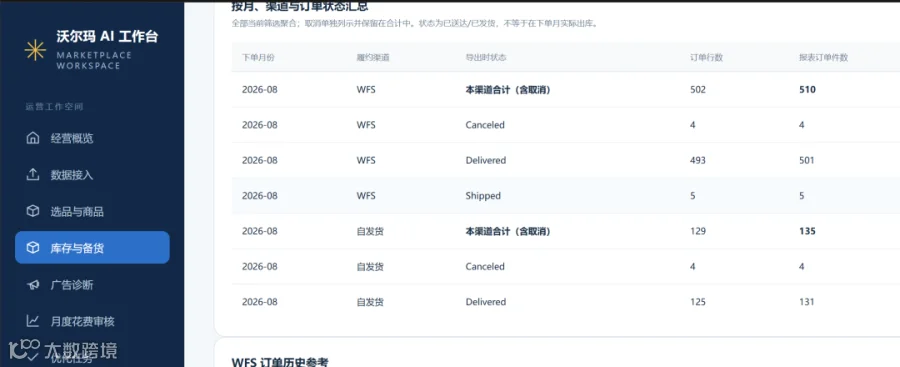
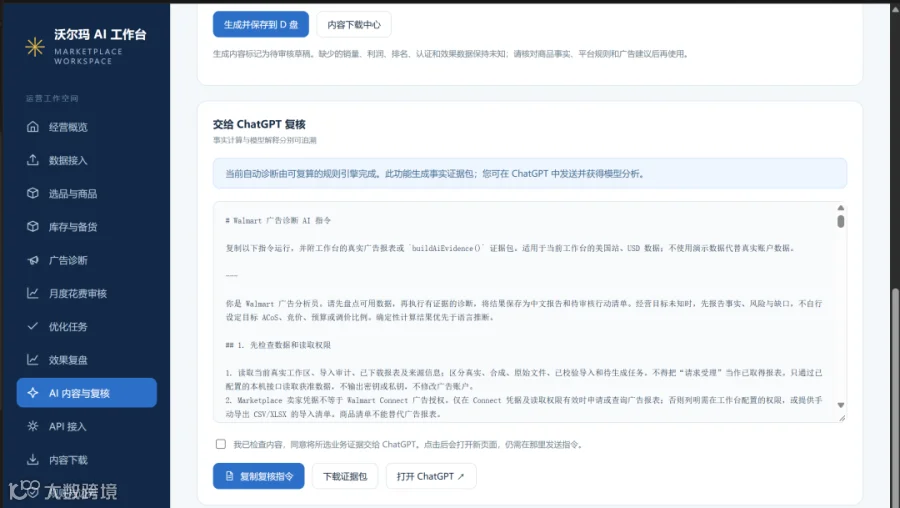
架构只留五个环节
原始 CSV → 来源与字段校验 → 同口径指标计算 → 证据包 → AI 草稿与人工复核
我给 Codex 的需求是:做本地只读网页,先支持四类 CSV;保留源文件、哈希、原始行号;未知口径保留“未知”;不把不同报表的花费相加;所有预算和竞价建议只输出待审核文本。第一版不需要广告账户写入,也不用先把 API、BI 和自动化流程全接上。
① 导入:每张表都有自己的身份
商品清单只用于映射核验;Item、Keyword、Item Keyword 是三个独立广告视角。工作台为文件记录类型和 SHA-256,并保留原始行。核心调用来自本地服务:
const sources = incoming.decoded.map(x => x.source);
const analysis = await buildUploadedAds(sources, {
  accountLabel: incoming.accountLabel,
  windowDays: 14, // 由人工核实,不能从上传时间猜
  asOf
});
代码里,每个来源的身份近似于 “报表类型 + 文件哈希”。相同来源重复上传不再累计;同一候选行出现冲突,会隔离等待核查。界面可以追到原始文件与行号。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
如果直接把三行相加,会得到 9,977.88。这不是账户总花费,而是把不同观察层级重复累计。原始行按日期与维度校验身份;月度视图再按 sourceId、广告类型、月份及实体维度分组。
② 计算:确定性代码先于语言模型
先从同一个来源选出已通过身份校验的 SP 行,再累计原始分子和分母。下面是实际代码逻辑的节选与展开,省略页面格式化:
const source = analysis.sources.find(s => s.type === 'item');
const rows = analysis.normalizedRows.filter(r =>
  r.included && r.sourceId === source.id &&
  r.campaignFamily === 'SP'
);
function sumOrNull(rows, key) {
  if (!rows.length ||
      rows.some(r => r.metrics[key] == null)) return null;
  let sum = 0, correction = 0;
  for (const r of rows) {
    const y = r.metrics[key] - correction;
    const next = sum + y;
    correction = (next - sum) - y;
    sum = next;
  }
  return sum;
}
const kpi = {
  impressions: sumOrNull(rows, 'impressions'),
  clicks: sumOrNull(rows, 'clicks'),
  spend: sumOrNull(rows, 'spend'),
  orders: sumOrNull(rows, 'orders'),
  sales: sumOrNull(rows, 'sales')
};
const ratio = (a, b) =>
  a == null || b == null || b === 0 ? null : a / b;
const acos = ratio(kpi.spend, kpi.sales);这里有两个关键点:空值不补零,分母为零就不计算;先汇总花费和销售额,再算 ACoS,而不是平均每天的百分比。实际项目还校验负数、无效日期、重复与冲突行,金额累计使用误差补偿。
③ 质量门槛:有数,也要知道不能说什么
这批文件生成的核查标记包括:6 行点击数大于展示数、89 行源报表缺 SKU、7 条映射未确认、3 个广告来源的报表口径待核。标记可能重叠,不能把这些数加成“错误总数”;原行也不会因此被悄悄改成 0。
9 月只覆盖 14—30 日,10 月只覆盖 1—13 日;真实导出时间、日期基准、时区、币种和销售范围仍未确认。所以 33.09% 只是报表列的描述性比值,不能直接推出完整月环比、利润或停投动作。这一步是技术上的“结论门槛”,不是文末随手加一句免责声明。
const canJudgeMaturity =
  analysis.meta.exportedAt !== 'unknown' &&
  analysis.meta.timezone !== 'unknown' &&
  analysis.meta.dateBasis !== 'unknown' &&
  analysis.meta.salesScope !== 'unknown';
const maturity = canJudgeMaturity
  ? '继续按导出日与归因窗口逐行计算'
  : 'unknown';
④ 给 AI 的是证据包,不是一堆原始表
计算结束后,我才让 Codex 参与解释。传给它的是指标、来源、质量标记和判断限制,不是让它重新心算 CSV。证据包的最小结构可以写成:
const evidence = {
  source: { type: source.type, sha256: source.sha256 },
  period: source.dateRange,
  metrics: kpi,
  ratios: { acos },
  qualityCounts: analysis.qualityCounts,
  limits: {
    windowDays: analysis.meta.windowDays,
    timezone: analysis.meta.timezone,
    dateBasis: analysis.meta.dateBasis,
    maturity
  }
};
给 AI 的写作约束也很简单:每条判断写明事实、来源、缺口和下一步核查;缺成本与预算就写“待补”,不编目标 ACoS,不生成可直接执行的调价比例。工作台只读,最终由运营审核。
⑤ 验收:先让数据对得上,再谈体验
本地服务监听 127.0.0.1:4317。项目有自动化测试;我又拿这批真实文件核对来源行数和汇总。当前代码测试结果是 203 项通过、0 项失败。如果要复现,我会让 Codex 先通过这四项验收:
① 同一文件重复导入,不能重复累计。
② SP Item 来源:2,368 行、30 个日期;花费 4,645.71。
③ 空值、零分母、冲突行都有明确状态。
④ 每个分析数字都能回到来源文件和原始行。
npm test
npm run dev
# 打开 http://127.0.0.1:4317
# 本次验证:203 passed / 0 failed
这套工作台的价值,是把“报表里有个数字”变成“我知道它怎么算、来自哪里、现在能不能用于决策”。Codex 帮我把这条链路做成工具;判断业务口径和是否执行动作,仍然要由运营承担。