


近期有企业反馈,在验收AI搜索优化(GEO)服务时遇到困惑:外包方仅提供几张包含品牌名称的AI答案截图,便宣称“品牌可见度显著提升”。虽然截图属实,但其证明力远弱于暗示的业务价值。
核心问题在于认知错位:用第一层的表象数据,去论证第三层的业务结果。本文将拆解GEO效果的层级逻辑,提供科学的验收标准。
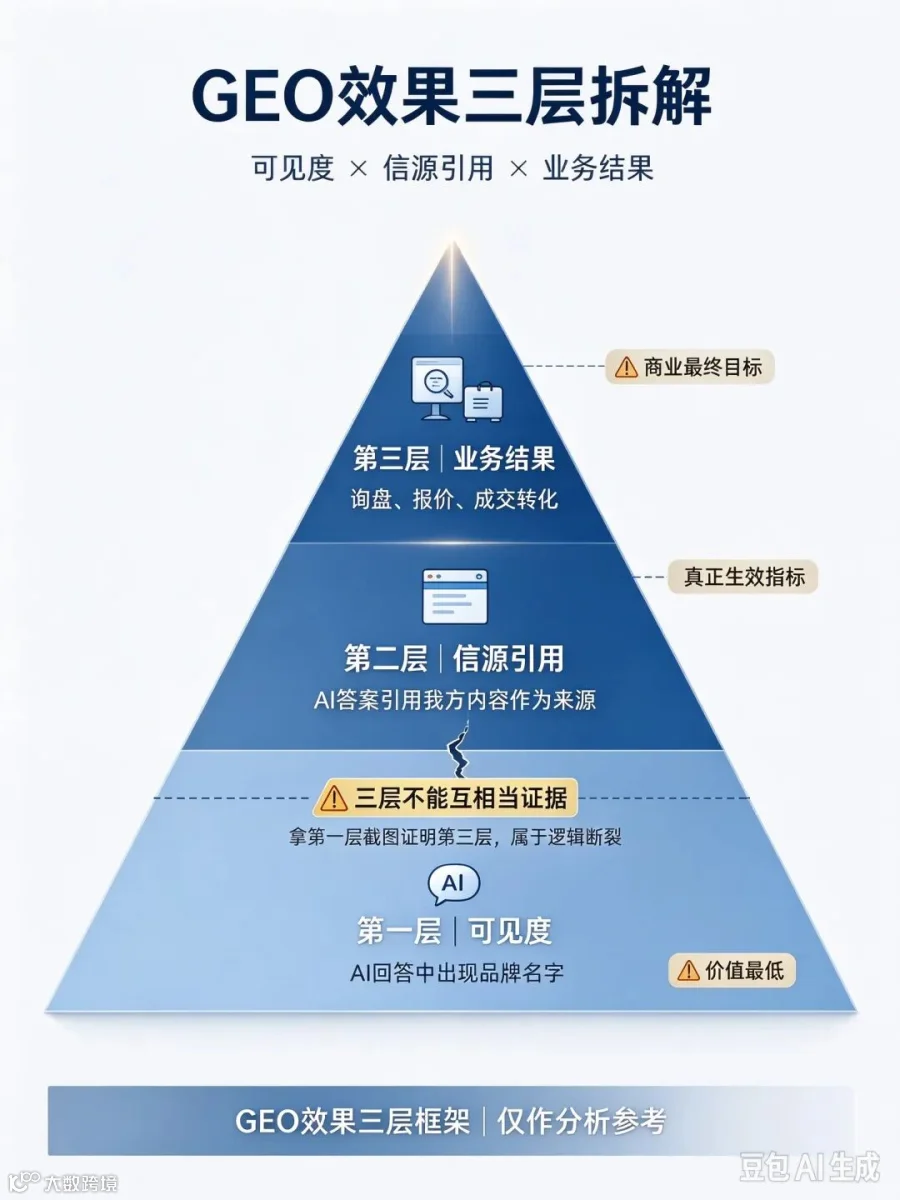
GEO效果的三层逻辑:不可互相替代
GEO的效果并非单一指标,而是由三个层级构成,且彼此不能直接互为证据:
第一层:可见度。在AI回答中是否出现品牌或产品信息。
第二层:信源引用。AI生成的答案中,是否直接引用了企业发布的内容作为来源。
第三层:业务结果。询盘、报价及最终成交量的实际变化。
多数争议源于拿第一层的截图去证明第三层的结果。第一层最易获取但价值最低,第三层最具商业价值但受多重因素影响,中间隔着复杂的因果链。
截图的局限性:属于最弱证据
单张AI答案截图仅能证明在特定时刻、特定引擎、特定问法下,品牌信息曾短暂出现。它无法验证稳定性、持续性以及内容是否被真正引用。
Google官方文档明确指出,即使网页符合基础规范,也不保证被抓取、索引或呈现。因此,截图必须配合固定问句、固定周期及可复现的记录才有参考意义,单独查看极易产生误导。
核心交付物:第二层信源引用
相比波动较大的可见度,内容是否被AI视为信源引用,才是内容优化工作的直接产出。不同AI引擎的信源偏好存在显著差异:
- 豆包:首选今日头条(占比约35.2%);
- 通义千问:首选搜狐号(占比约28.7%);
- DeepSeek:偏好技术社区,如CSDN(占比约24.6%)。
这意味着,内容必须发布在目标引擎收录的平台上,才可能进入引用池。“发布平台”和“发布时间”是可量化、可验收的过程指标,但需注意:铺量仅代表获得机会,不等于必然被引用。
证据分级体系:从一级到五级
为科学评估效果,建议将证据分为五个等级:
一级(最弱):单张AI答案截图,仅证明某一刻发生。
二级:单次查询记录,包含引擎、问句、日期,证明特定条件下发生。
三级:可复现记录,他人使用相同问句能重现结果,排除偶然性。
四级:时间序列数据,同一问句在固定周期内的多次记录,反映趋势变化。
五级(最强):信源可追溯,明确显示AI引用了企业具体内容,证实内容工作生效。
验收时需核对:服务商提供的材料处于哪一级,而其承诺的结论又对应哪一级。严禁用一级材料推导三级结论。
验收前置条件:建立基线
许多“无效”争执的根源在于缺乏基线对比。建议在项目启动前执行以下操作:
选取5至10个不含公司名的品类或场景类固定问句,在目标引擎中进行测试,并保存原始问句及答案。以此为基准,后续复测才有比较依据。若服务商无法提供基线测量,其后续的“提升”说法将难以验证。
合同条款与验收边界
可写入合同的指标:过程类数据,如交付篇数、发布平台、复测频率、记录格式等。
不可写入合同的指标:结果类承诺,如保证被引用、保证排名等。各大平台官方均声明不接受付费影响排名。
注意时滞差异:不同引擎收录速度不同,第三方实测显示豆包更新较快,DeepSeek相对较慢。验收周期应根据具体引擎特性设定,避免一刀切。

常见误区答疑
问:AI能搜到公司名,是否代表有效?
答:不一定。品牌词答案多源自企业自有资料,AI仅为复述。应重点关注不提公司名、仅问品类和场景时的表现。
问:服务商提供大量截图,可信吗?
答:需判断证据等级。单张截图效力最弱。只有提供包含问句、引擎、日期且可复现的记录,才具备参考价值。
问:询盘增长能否归因于GEO?
答:不能单独归因。询盘受季节、展会、价格及销售能力等多重因素影响。严谨的表述应为“同期进行了AI搜索优化,询盘出现变化”,而非直接因果关系。
结语
科学验收GEO服务,关键在于区分证据层级与业务结果。企业应追求可复现的记录和清晰的信源引用,而非仅仅依赖表面化的截图。
参考资料与免责声明
- Google Search Central:《Google 搜索的运作方式》及搜索质量相关官方说明。
- 各 AI 引擎信源占比与引用时滞数据来源于第三方实测(16,800 次查询反向工程),非官方数据,仅供参考结构。
- “效果三层”与“证据五级”为本文分析框架,非行业标准;目前行业尚无统一的 AI 可见度计算标准。
数据与效果边界说明:本文所述框架仅为分析工具。各 AI 引擎规则以官方文档为准。GEO 服务无法承诺被 AI 引用、具体排名或固定周期见效。本文不构成对任何具体服务商的评价,也不含价格及套餐信息。
[#AI搜索优化#][#GEO#][#外贸获客#][#深圳外贸#]