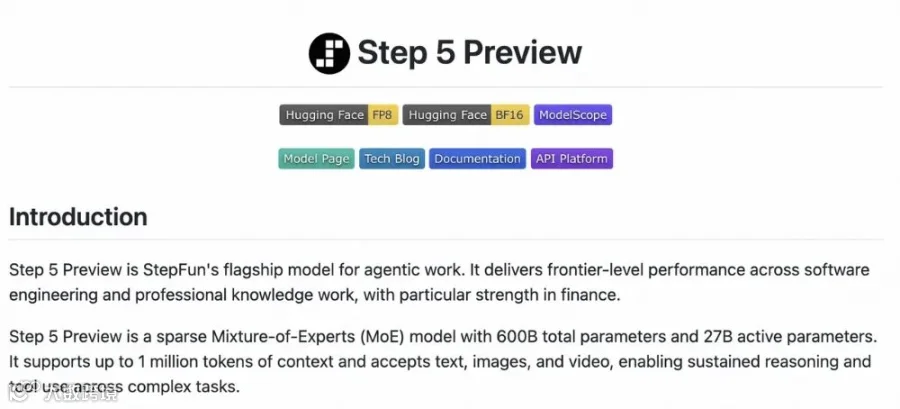
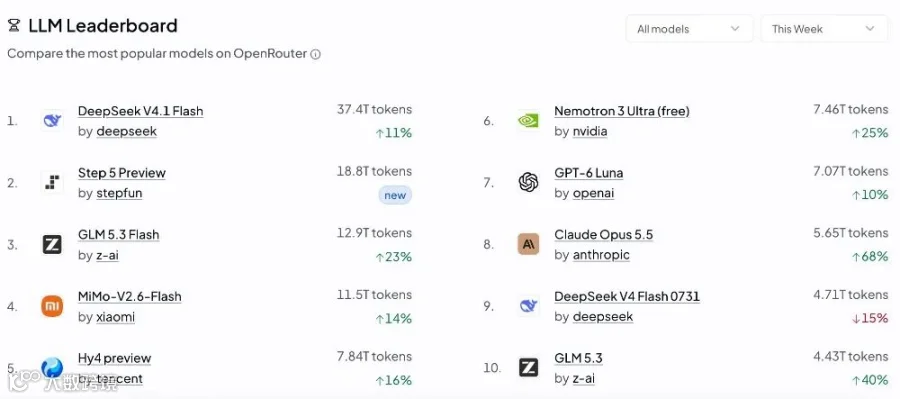
智东西10月15日报道,阶跃星辰正式开源大模型Step 5 Preview,BF16与FP8两个版本同步上线HuggingFace和ModelScope。该模型刚登上OpenRouter Token全球使用量周榜第二,展现出强劲的市场潜力。
https://huggingface.co/stepfun-ai/Step-5-Preview
https://modelscope.cn/models/stepfun-ai/Step-5-Preview
Step 5 Preview采用稀疏MoE架构,总参数量600B,激活参数仅27B,支持100万Token上下文窗口。在Artificial Analysis的Intelligence Index榜单中取得44分,位居全球开源模型前三。
发布后,该模型迅速进入全球开发者视野。截至2026年10月15日,其在OpenRouter平台的周榜、日榜均位列第二,近七日用量约18.8万亿Token。
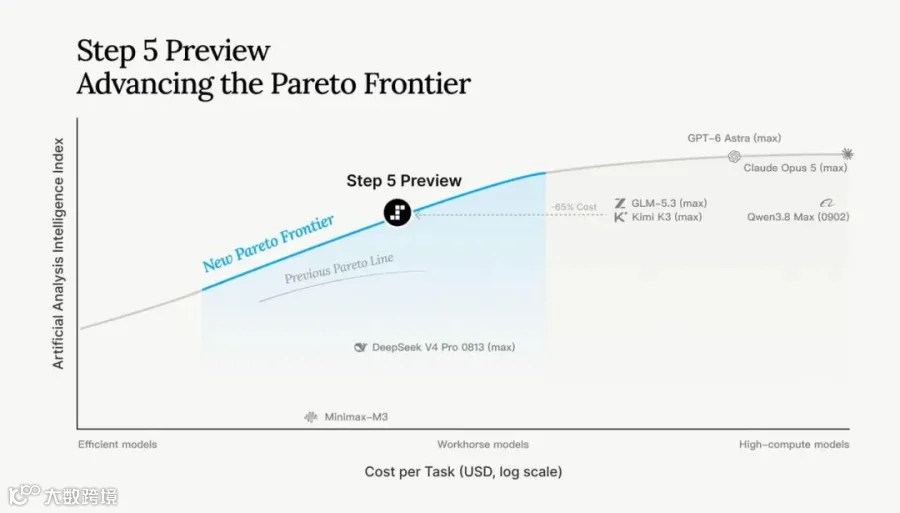
成本方面,Step 5 Preview单任务平均成本仅为Claude Opus 5的1/8。前者单次总开销0.71美元(约合人民币4.75元),后者为5.86美元(约合人民币39.22元)。
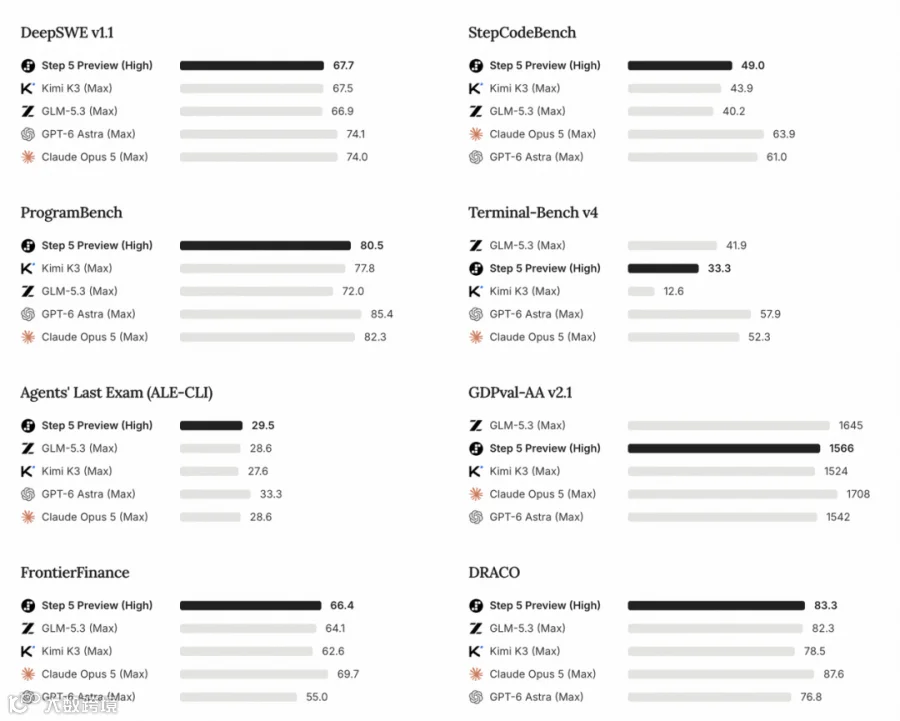
基准测试显示,Step 5 Preview在软件工程、专业知识工作及金融领域等复杂任务中表现均衡。在Agents' Last Exam的CLl子集ALE-CLI、金融投资研究评测FrontierFinance及跨领域深度研究评测DRACO上,其表现优于Kimi K3、GLM-5.3,仅次于GPT-6 Astra或Claude Opus 5。
Step 5 Preview为何能在榜单和实际使用中表现出色?以下是对其技术设计的深度解析。
92层窄深架构:从架构层面提高计算效率
Step 5 Preview由92个Transformer模块堆叠而成,模型深度与Qwen 3.8 Max、Kimi K3等万亿参数级开源大模型相当,但总参数量不足这些模型的1/4,激活参数不足1/3。
阶跃星辰指出,在智能体任务中,模型需不断调用外部工具,每次调用可能带来大量新文本。考虑到Token效率,模型未必有机会通过显式思维链充分推理,因此更加依赖读取上下文时的“隐式推理”。
在Transformer中,信息沿token时间方向和网络深度逐层传播。若层数不足,多跳依赖的信息可能在完成传递前耗尽网络深度,导致长文本中的复杂推理失败。相比通过循环或递归结构增加等效深度的技术路线,阶跃选择了更直接的“加深层数、控制网络宽度”策略。
这种“窄而深”的设计既为多跳推理提供了更长的信息传递路径,又控制了参数规模及响应计算开销,使模型获得与万亿级模型相当的长程任务能力。
在注意力机制配置上,Step 5 Preview按3:1比例交错布置两类注意力层:3/4为高效的Gated滑动窗口注意力层,1/4为稀疏全注意力层。团队对比多种线性注意力方案后发现,滑动窗口注意力结构最简单,且对投机解码更为友好。
Sparse GQA:给百万Token上下文的注意力“瘦身”
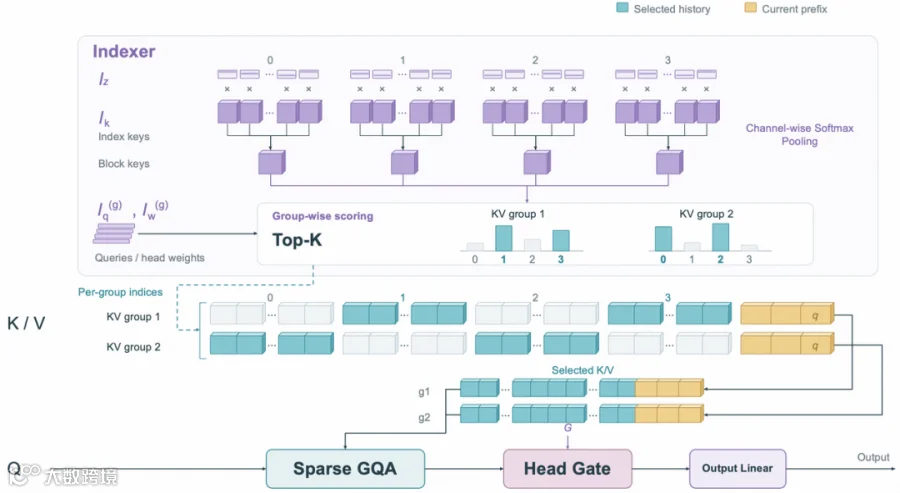
为解决上下文长达100万Token时全注意力层成为训练和推理效率瓶颈的问题,阶跃在全注意力路径上采用了Sparse GQA(稀疏分组查询注意力)机制。即在标准GQA中引入稀疏索引,模型先筛选再计算,无需对全部历史信息做注意力计算。
尽管DeepSeek的DSA等工作已有类似探索,但阶跃在实际部署中需克服筛选器开销、GPU利用率及筛选精度与数据读取量权衡三道难关。相比MQA和MLA结构,GQA虽会放大这三重矛盾,但因长上下文精度更好且利于多GPU并行推理而被选中。
▲稀疏GQA示意图1
-
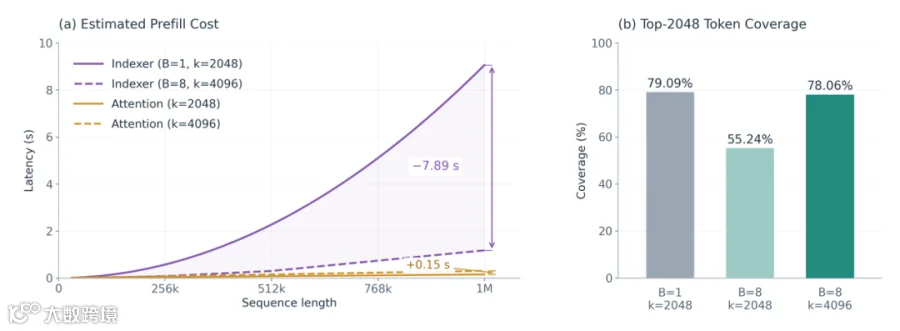
利用相邻token语义相近、筛选结果高度重叠的特点,对相邻token的筛选结果取并集、合并计算,以改善GPU利用率;
-
经反复试验,确定每8个token为一组、共筛选4096个token的配置。文本越长,该方案节省的计算越多,且信息覆盖率与更精细方案几乎相同(78.06%对79.09%)。
在稀疏机制下,筛选器先将共享索引键压缩为块表示,每个KV分组独立选出相关历史块,主计算路径只读取被选中的原始K/V及当前块内可见位置,从而避免了对百万级Token全量计算注意力的开销。
▲稀疏GQA示意图2
三层手段压住数值爆炸与梯度尖峰:实现更稳定的训练
为确保设计落地,阶跃在FP8低精度训练框架下,针对数值爆炸和梯度尖峰问题采取了三项措施:
1. 隐藏状态转为FP32精度
低精度训练速度快、成本低,但模型加深后,少数极大值数据点在低精度格式下易失控。改用高精度存储这部分数据后,极端值下降近十倍,且额外成本影响不大。
2. 归一化层缩放因子转为FP32
模型归一化层采用零中心RMSNorm,其调节参数在低精度格式下若停在临界值,会导致计算通道反复“开关”,引发输出震荡。将该参数改为高精度存储后,震荡问题明显缓解。
3. 细粒度梯度钳制
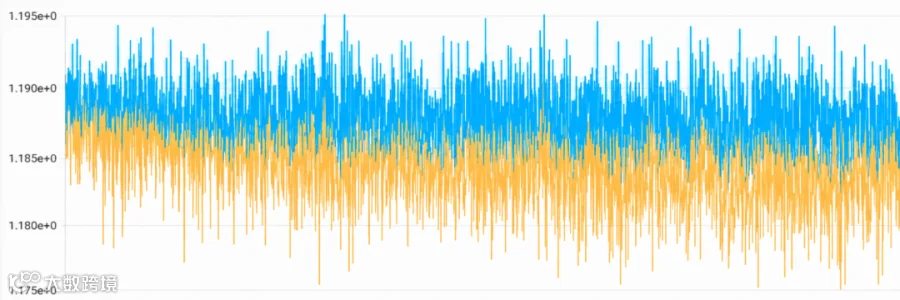
梯度尖峰并非源自数据噪声或输出层,而是起于中间某些层并在反向传播中被放大。由于异常梯度极为稀疏,团队只需对每层梯度中极小部分(占比0.00004%)进行限幅,即可抑制尖峰,使训练收敛曲线更平滑。
▲细粒度梯度钳制之前(蓝色)和之后(橙色)的LLM损失比较
结语:从架构优化到开放部署
Step 5 Preview的技术设计涵盖了模型推理、长上下文处理和训练工程等多个维度,是一系列围绕能力与效率平衡的设计取舍。
当前大模型行业,参数和榜单分数仅是门槛。模型需扛得住调试、便于大规模部署并接入真实业务流程,才能转化为生产力。Step 5 Preview通过两条路径推进落地:面向开发者,官方放出BF16、FP8两种精度权重;面向普通用户,模型接入腾讯WorkBuddy开放为期两周的免费试用。
双渠道并行让阶跃星辰的覆盖人群从Agent开发者延伸至办公用户和有本地部署需求的研发人员。模型权重的开放意味着这些技术设计将接受更多真实环境和复杂任务的检验,也让阶跃的技术探索有机会进入更广泛的应用场景。
模型能力的竞争仍在继续,但比拼的已不只是模型本身。如何让前沿模型的能力真正走进实际应用,或许是下一阶段大模型竞争中更值得关注的问题。