

阶跃星辰开源Step 5 Preview,昇腾1024卡液冷超节点同步点亮
新智元报道

2026年10月15日,阶跃星辰正式开源新一代旗舰模型Step 5 Preview。该模型在AI编程、软件工程、专业知识工作及金融等领域达到前沿水平。
伴随模型开源,昇腾基于vLLM推理引擎实现0Day支持,并针对模型架构与硬件特性完成高效推理优化。同日,首套1024卡Atlas 950 SuperPoD液冷超节点点亮,为Step系列大模型提供算力服务,性能对标海外先进算力。
Step 5 Preview:全能前沿,架构革新
Step 5 Preview采用稀疏MoE架构,总参数量达600B,每个Token激活27B参数。模型支持1M Token上下文窗口,并具备图像、视频等多模态输入能力。
在软件工程、Agent智能体、专业工作和金融等多个垂直方向,Step 5 Preview均展现出极具竞争力的表现。

Step 5 Preview与主流前沿模型在Agentic Benchmark上的性能对比
技术架构上,Step 5 Preview引入全新的Sparse Attention结构以支持百万级Token上下文。其通过Indexer选择Token,并在选中范围内计算Self Attention。为解决Index计算瓶颈,模型以Region(8个Token)为单位压缩Indexer Key,有效兼顾了效率与性能。
首套1024卡昇腾950液冷超节点点亮
10月15日,随着Step 5 Preview的开源,首套1024卡Atlas 950 SuperPoD液冷超节点同步上线点亮。
昇腾Atlas 950 SuperPoD液冷超节点基于灵衢高速互联架构与超节点技术体系打造,是业界规模最大的1024卡超节点产品。它可提供1 EFLOPS FP8及2 EFLOPS FP4精度算力,高效适配万亿参数大模型的推理需求。
该超节点具备256TB全局统一内存编址能力,NPU卡间互联带宽达TB级,时延低至3μs,彻底突破传统集群内计算与存储资源的通信瓶颈。通过系统性架构创新与全域资源统一调度,实现了集群算力的高效释放与稳定运行。
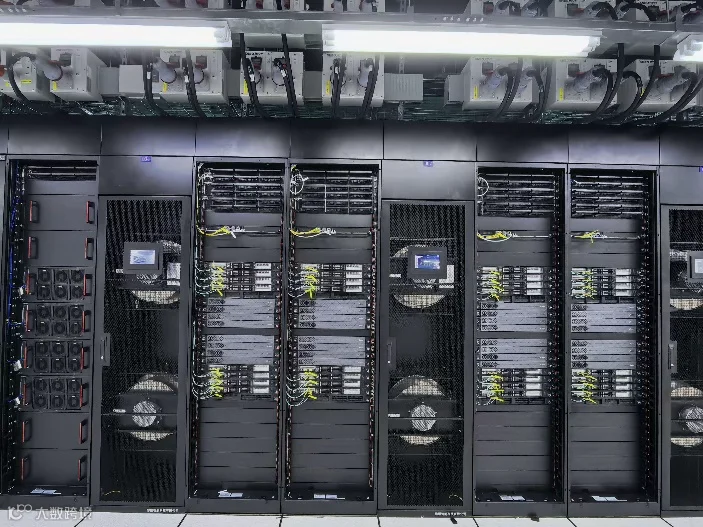
首套1024卡昇腾Atlas 950 SuperPoD液冷超节点点亮
未来,阶跃星辰将与昇腾持续探索大模型推理的性能极限,挖掘模型落地应用价值,共同践行“智能阶跃,十倍每一个人的可能”的发展愿景。
昇腾软硬协同优化,释放950超节点强大推理潜能
昇腾基于vLLM Ascend推理引擎,围绕Step 5 Preview模型架构与950超节点硬件特性,构建了高效的推理优化方案。从Ascend C与Triton融合算子,到多流并行、计算空泡优化,再到MTP投机解码、NPU Graph图执行,持续打通模型、算子和推理框架之间的优化链路。
算子优化:Ascend C与Triton协同,兼顾极致性能与开发效率
针对Step 5 Preview的稀疏注意力、模型连接结构与混合专家网络,昇腾结合CANN算子能力与Triton编程,实现分散计算和数据处理的高效执行。
1. IndexerLogits与SparseAttn Ascend C算子:昇腾950超节点新增FP8算力,支持IndexerLogits原生FP8计算。通过将Token打分与TopK、Sort等筛选过程融合为Indexer Logits Ascend C算子,并使用成对Region搬移提升带宽;借助SparseAttn算子利用Vector单元的SIMD能力替代Scalar运算。
2. Triton融合Kernel加速:围绕Norm、Indexer key压缩实现关键融合算子(如QK Norm、Index Key压缩等)优化。通过添加AutoTune自动寻优昇腾亲和的Tiling大小,使能950超节点中的SIMT能力,实现性能加速。
3. MoE专家路由优化:围绕Hash TopK专家选择,优化路由前处理与精度传递,减少跨层重复操作。
4. MXFP8量化:昇腾950超节点硬件单元实现MXFP8反量化,通过重新量化权重为MXFP8格式,在精度几乎无损的情况下极致发挥硬件算力。
从核心注意力到专家路由,从融合计算到数据搬运优化,多层次算子协同使Step 5 Preview的架构特点与昇腾硬件能力更紧密结合。
通信优化:FullMesh + CLOS融合架构与算法创新,大幅提升通信性能
1. FullMesh+CLOS最大化带宽:950超节点同时利用FullMesh + CLOS进行通信,最大化提升Allreduce、Allgather、ReduceScatter等通信原语性能。
2. Dispatch Server级去重,减少跨服务器重复传输:在高吞吐方案中,若同一Token被多个位于同一远端服务器的专家选中,则先发送一份主副本至跨服务器,再在服务器内分发,从而减少重复流量。面对多个发送方,按组分发任务并结合并行通道与批量提交,减少零散发送。
3. Combine通过双缓冲,实现Reduce与通信回传重叠:专家计算完成后,先对同一输入的多份结果进行局部归并,再按数据块回传。两个输出缓冲区交替使用,使上一批结果回传的同时下一批继续进行Reduce(归并),减少等待时间。
框架优化:序列并行、多流并行、Tiling下沉协同,减少重复操作与调度开销
推理效率不仅取决于算子执行速度,还取决于推理框架如何减少重复操作。通过将无数据依赖的计算并行化,利用图模式和异步调度减少计算单元等待,使各阶段衔接更紧密。
1. MoE序列并行:围绕模型连接结构,引入序列并行以降低冗余计算和通信。
2. Vector/Cube/通信多流并行:结合昇腾向量、矩阵计算单元及通信单元可并行执行的特点,通过多流调度组织计算与访存交叠,减少串行等待和计算空泡,提高硬件资源利用率。
3. NPU Graph图执行优化:将解码阶段的计算纳入图执行,结合持久化缓冲区和输出复用,减少重复调度、临时分配与数据拷贝,使高频解码过程更紧凑。
4. 多Token预测优化与Tiling下沉:适配Step系列模型的多Token预测(MTP)机制,提升单步生成效率。通过Attention算子的Tiling下沉,消除主模型与草稿模型、每步推理之间的断流,减少Device空泡,提升运行效率。
5. Prefill Indexer Key压缩阶段Slot预分配:将模型内动态搜索可用Slot(用于存储Index Key压缩后的位置)改为预分配,消除了层间的冗余操作。
通过算子执行、图运行与调度策略的协同设计,适配方案从多个层面压缩推理过程中的非计算开销,持续挖掘硬件与模型的性能潜力。
Step 5 Preview昇腾量化版本推理部署指导
用户及开发者可访问以下链接获取Step 5 Preview昇腾量化版本的推理部署指导进行体验(实际性能与部署方案、参数配置及软硬件环境等因素相关,并将持续优化提升):
vLLM Ascend:
https://docs.vllm.ai/projects/ascend/en/latest/tutorials/models/Step-5-Preview.html
注:文中性能比例来自对应算子或局部链路的专项对比测试,实际收益随硬件配置与业务负载变化。