大数跨境

告别「先建图再出发」,大模型如何重塑机器人导航?

告别「先建图再出发」,大模型如何重塑机器人导航? AI科技评论
2026-10-16
7
导读:把 Coding Agent 塞进机器狗?浙大团队推出 SuperNav,让机器人在陌生商场里“边看边找”。
浙大团队推出 SuperNav:将 Coding Agent 引入物理世界,实现机器人“边看边找”的通用导航

    编辑丨岑峰


传统具身导航往往依赖预先构建的地图或硬编码流程,导致机器人在陌生环境中缺乏灵活性。浙江大学 ZJU3DV 团队联合深圳大学、灵知机器人推出的通用智能体导航系统 SuperNav,摒弃了“先建图、后行动”的传统范式,创新性地将数字世界的 Coding Agent 能力迁移至物理世界。
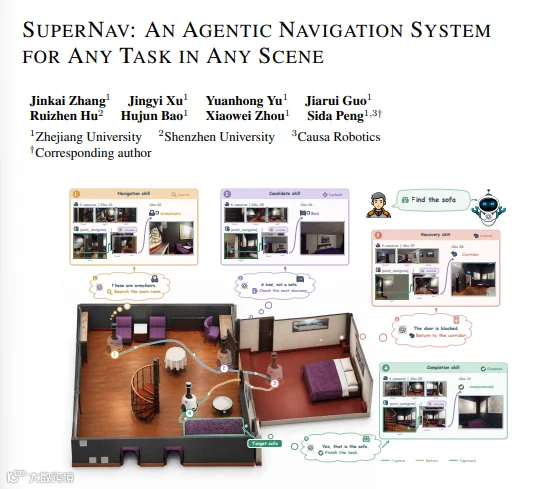
SuperNav 采用“Pixel Goal(视觉指点)+ 底层运动”的解耦架构,使大模型能够像人类一样通过调用工具和技能,在完全陌生的虚拟及真实环境中完成复杂的开放指令导航。目前,该系统已在多个国际权威基准测试中表现优异,并成功部署于四足机器人 Go2,相关代码已全面开源。


论文信息与核心成果

SuperNav 旨在赋予通用智能体在任意陌生环境中执行任意导航指令的能力。团队在 Habitat-GS、AI2-THOR 和 HM3D 三大主流基准上进行了数千次任务测试,并将系统部署于真实机器人。结果显示,SuperNav 不仅保持了高导航成功率,更展现出类人的移动决策能力。

▎论文:SuperNav: An Agentic Navigation System for Any Task in Any Scene

作者:Jinkai Zhang、Jingyi Xu、Yuanhong Yu、Jiarui Guo、Ruizhen Hu、Hujun Bao、Xiaowei Zhou、Sida Peng
单位:浙江大学、深圳大学、灵知机器人


研究背景与目标

在日常场景中,如“找个地方坐”或“拿杯咖啡”,机器人需具备理解日常请求、在陌生环境中自主搜索目标的能力。现有系统多依赖预建地图或特定任务流程,难以适应环境变化。SuperNav 的目标是提供通用的移动能力,无需为新环境建图或为新任务编排流程,即可实现自主导航。


核心设计理念

受数字世界中 Coding Agent 自主调用工具解决问题的启发,团队尝试将此类能力引入物理世界。初期实验发现,直接让 Agent 调用底层接口虽能完成任务,但效率极低。为此,团队聚焦于 Physical Agent 的设计,优化其观察、交互及任务执行的可靠性。
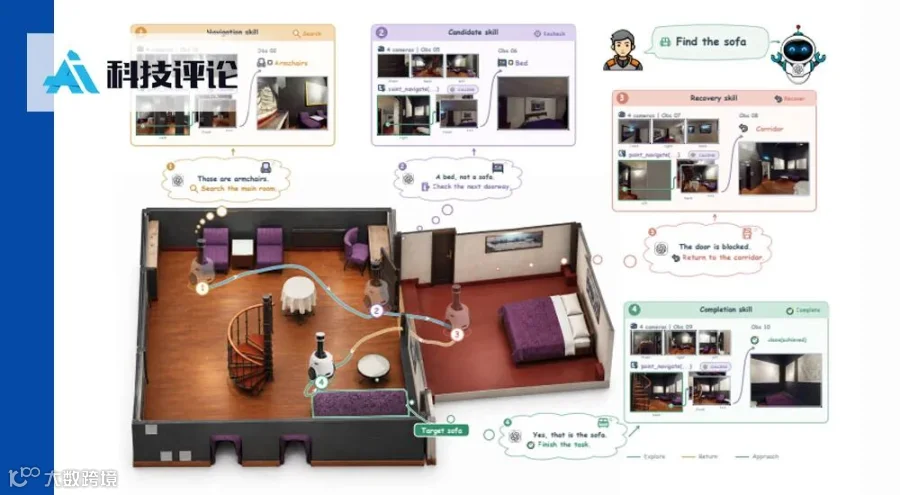
SuperNav 采用持续循环的工作模式:观察环境、决策下一步、调用工具移动、反馈结果。系统包含两类核心组件:
  • Tools(工具):负责查看四周、执行移动及记录进度;
  • Skills(技能):作为操作手册,提供搜索策略、目标核验及受阻改道经验。
在底层控制上,团队放弃了低效的 WASD微操,转而采用基于 Pixel Goal 的导航小脑。智能体只需在画面中指出目标位置,底层运动模块负责具体执行。这种“视觉指点 + 底层运动”的解耦设计,显著提升了效率并降低了累积误差。


实验效果展示

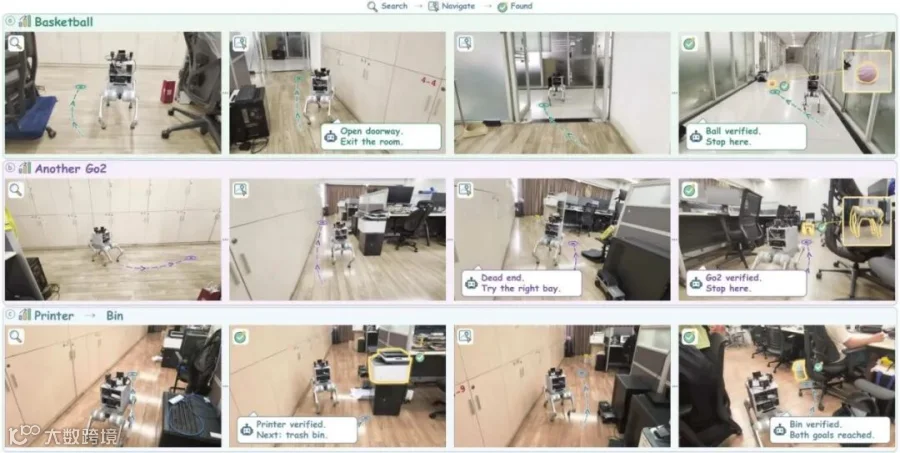
在真实办公环境中,四足机器人 Go2 能够执行寻找篮球、打印机及垃圾桶等复合指令,并在遇到死路时自主规划替代路径。
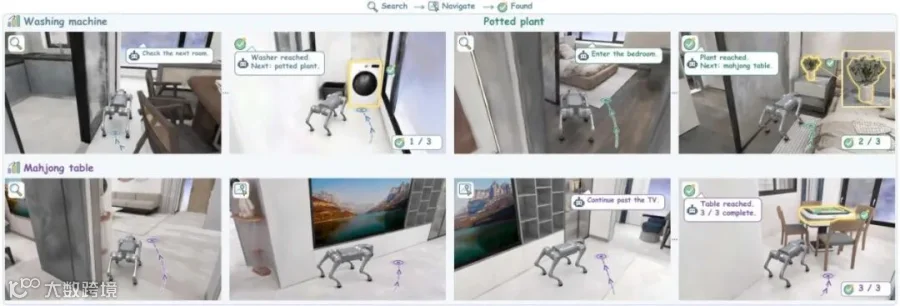
在 Habitat-GS 仿真中,机器人可按顺序精准定位洗衣机、盆栽和麻将桌等多个目标。
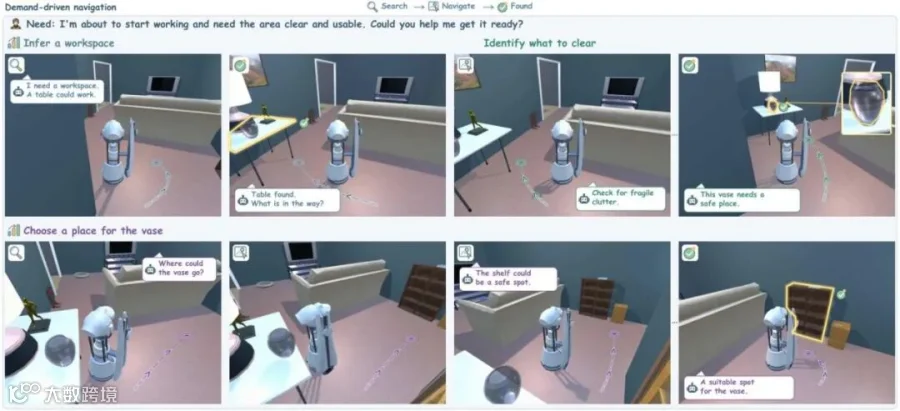
在 AI2-THOR 中,面对“准备工作区”等含蓄指令,智能体能自主推理并找到桌子、花瓶及合适的置物架。


资源获取

SuperNav 代码已开源:https://github.com/zju3dv/SuperNav
论文全文:https://arxiv.org/abs/2610.12126v1
项目主页与演示视频: https://zju3dv.github.io/SuperNav/


深度对话:技术细节解析

▎从 Coding Agent 走向 Physical Agent,最大的技术鸿沟是什么?

A:主要差距在于物理世界执行存在噪声和误差,且反馈模糊。编程任务可通过编译错误明确判断进展,而导航中机器人停下并不一定意味着到达正确位置。此外,机器人视角受限,每次行动都会改变后续观测,且试错成本高。因此,我们将观察、移动和反馈封装为易用的工具,并将经验转化为可读取的 Navigation Skills,使模型能通过后续观察验证决策有效性。

▎为何放弃 WASD控制,选择 Pixel Goal 方案?

A:WASD 控制虽然成功率尚可,但效率极低,需要大量 Agent Steps,且细碎的控制决策易导致上下文冗余和误差累积。Pixel Goal 将决策简化为“指向画面中的位置”,由底层执行器转换为具体运动。这种解耦减少了大模型的高成本往返推理,同时允许底层闭环修正细微运动偏差,提升了计算效率和容错率。

▎Sim-to-Real 过程中遇到了哪些挑战?

A:主要挑战在于工程适配。仿真中可直接获取深度和位姿信息,而真机需依赖传感器和标定。初期使用的 Diffusion Policy 在真机上表现不佳,最终改用结合 LiDAR 地图和相机内外参的传统规划器来确定空间对应关系。系统本身无需网络微调,具备良好的场景泛化能力。

▎SLAM 技术会被边缘化吗?Agentic Navigation 与端到端视觉导航的关系如何?

A:SLAM 不会边缘化,其在定位和空间几何建模上的优势不可或缺。SuperNav 旨在降低预建图成本,但在执行中仍利用在线建图和里程计。未来趋势是统一框架下的分工协作:SLAM 提供定位,几何规划器处理路径,学习策略处理局部运动,大模型负责任务理解和高层决策。SuperNav 的视觉点接口设计正是为了兼容不同底层技术,便于集成更先进的算法。

未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8994
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读278.0k
粉丝0
内容9.0k