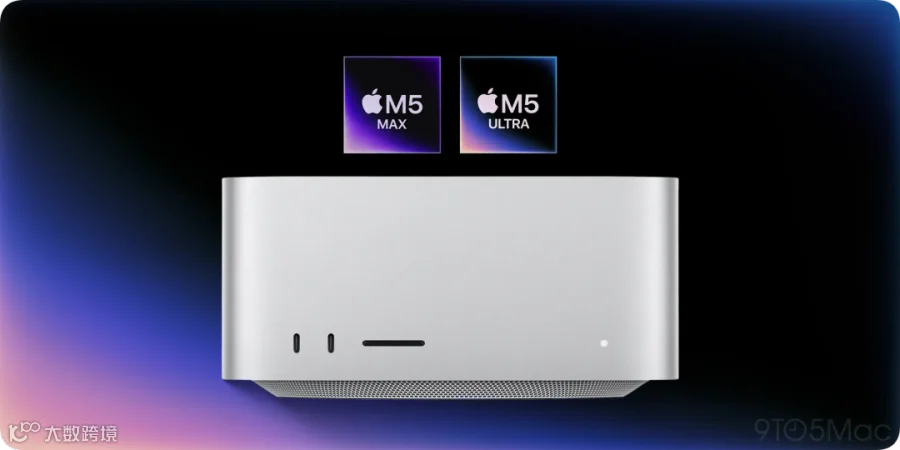
大数跨境

刚刚,Mac Studio 迎来小扎最强开源模型,苹果等来了最意外的助攻

刚刚,Mac Studio 迎来小扎最强开源模型,苹果等来了最意外的助攻 APPSO
2026-10-16
3
导读:小扎给苹果送来大模型
扎克伯格曾公开嘲讽苹果在 iPhone 之后缺乏创新,如今却主动展示 Meta AI 在 Mac 上的运行效果,并感谢苹果及其新任 CEO John Ternus 的支持。促成这一合作的核心,是拥有 8160 亿参数的超大模型及其本地化部署的共同愿景。
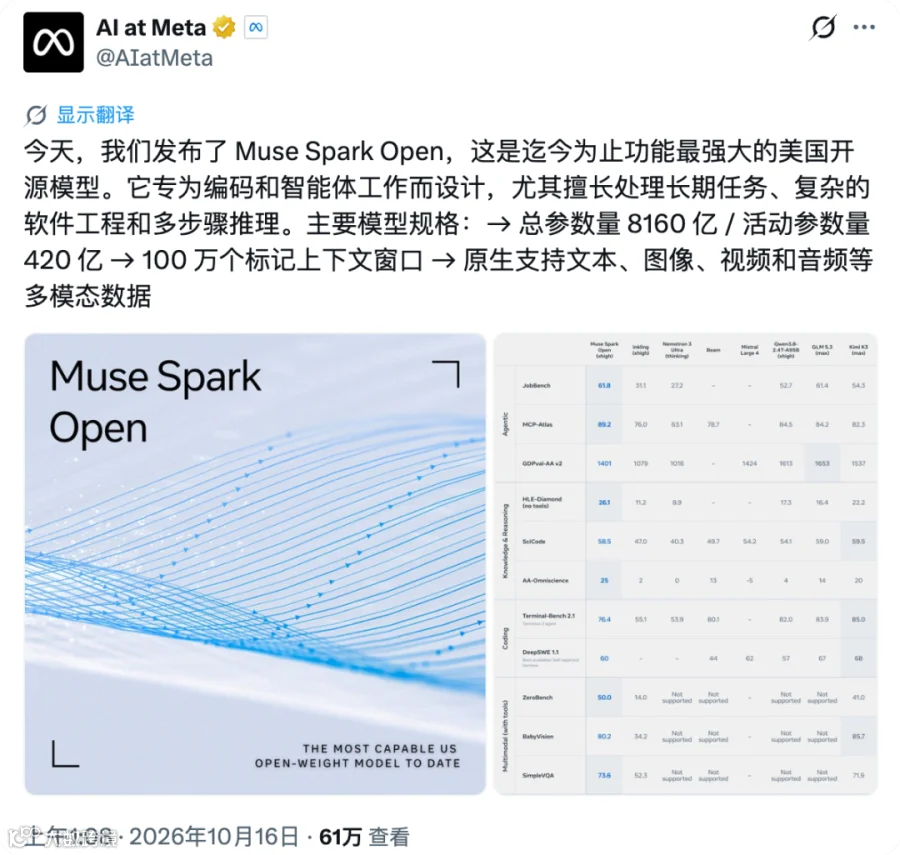
近日,Meta 发布开放权重模型 Muse Spark Open,并与苹果联合演示了其在多台 Mac Studio 上的运行方案。开发者可在本地使用该模型进行代码编写、视频分析及智能体任务执行,推理过程完全无需经过云端服务器,实现了数据隐私与算力的双重自主。
随着 AI 深入处理私人及企业敏感数据,数据存储与处理权归属成为关键议题。开放模型与本地 AI 的结合,让用户能够自行部署模型,将推理留在本地设备。苹果多年积累的自研芯片、统一内存架构及开发工具链,为此提供了坚实底座,使 Mac 向“AI 时代首选个人电脑”的目标更近一步。

Muse Spark Open 发布:开放权重与本地部署的新标杆
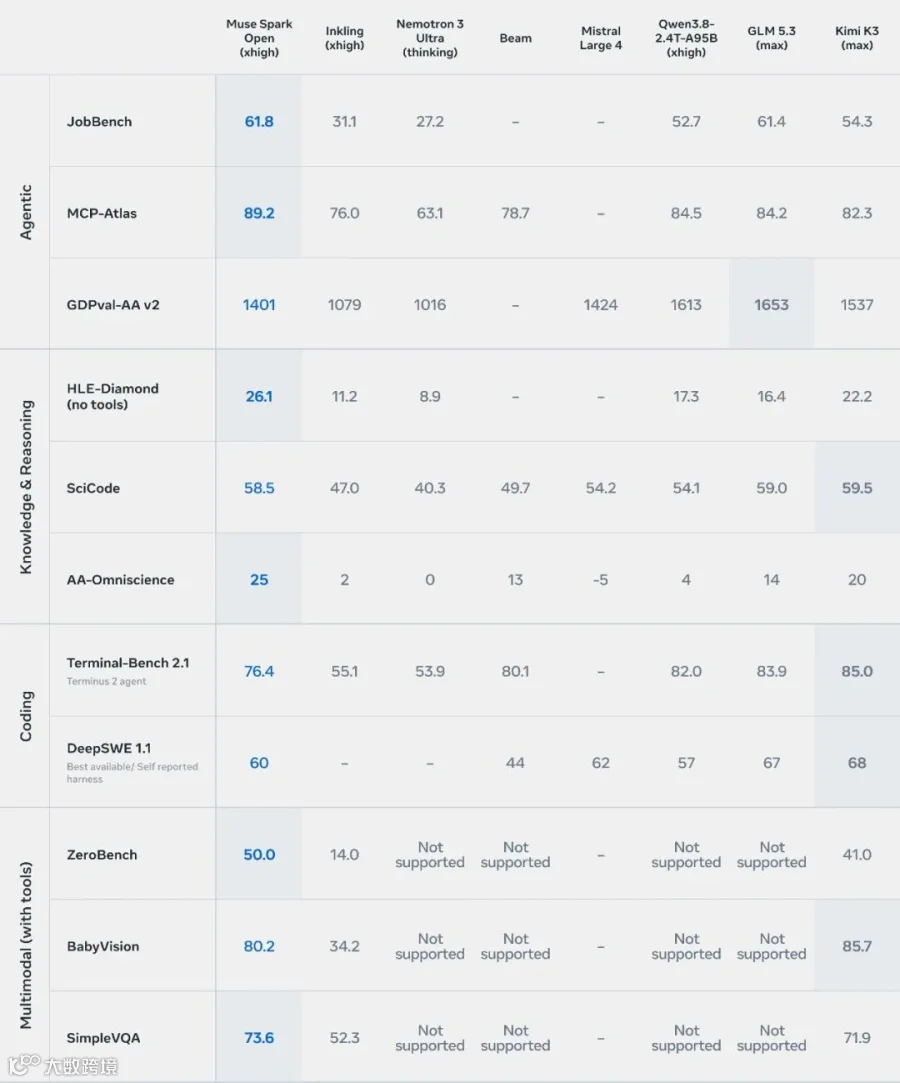
Muse Spark Open 的发布兑现了扎克伯格此前的承诺。今年 8 月,Meta 推出较小规模的 Muse Glimper 时曾表示将开放更大更强的模型。如今,参数量达 8160 亿的 Muse Spark Open 正式亮相,Meta 称其为目前能力最强的美国开发开放权重模型,性能接近闭源的 Muse Spark 1.3。
开发者可下载模型权重在自有硬件上部署,或通过云服务商使用。其许可证允许一定范围内的商业应用,为企业私有化部署留出空间。Meta AI 负责人 Alexandr Wang 指出,虽然开放版本能力略低于最新闭源模型 Muse Wonder,但其开放性赋予开发者自主选择运行环境和研究模型的权利。
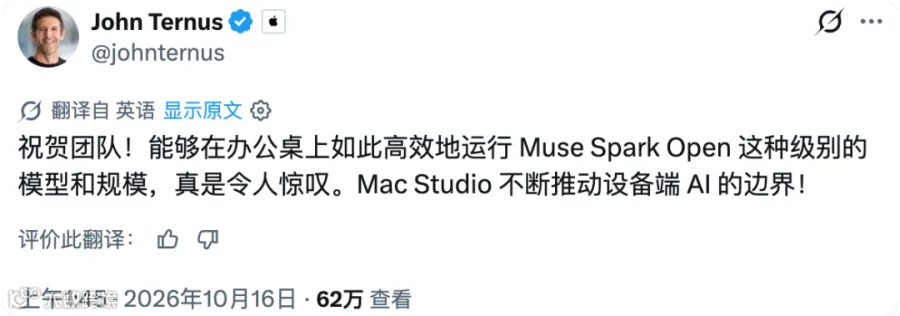
扎克伯格在社交平台晒出 Meta 智能体在 Mac 上运行的照片,感谢 Ternus 及苹果团队的支持。Ternus 回应称,在桌面设备上高效运行如此规模的模型令人振奋,Mac Studio 正不断拓展端侧 AI 的边界。Wang 幽默地表示,看到两家科技巨头“重归于好”令人高兴。据悉,双方已合作数月,前苹果员工、现 Meta 员工 Daniel Gross 在其中发挥了关键作用。
这种合作重构了模型能力与用户数据的关系。在本地运行模式下,Meta 无法查看或控制用户的使用内容,提示词和推理过程完全保留在用户掌控的环境中。这不仅保护了个人隐私,也满足了企业对代码、文档等业务数据自主管理的安全需求。

技术解析:8160 亿参数如何在 Mac 集群中高效运行

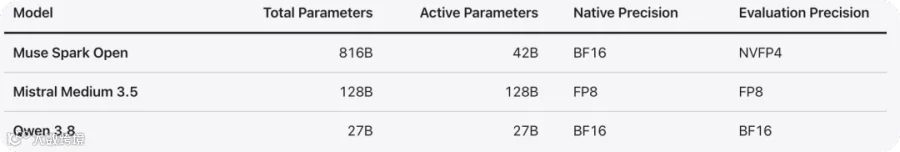
将庞大模型搬上桌面需解决存储与速度两大难题。Muse Spark Open 采用混合专家(MoE)架构,总参数量 8160 亿,每次推理仅激活约 420 亿参数。这种机制虽降低了计算负担,但全量参数仍需存储在内存中。
据苹果技术博客数据,原生 BF16 精度下该模型需超 1.6TB 内存。通过 NVFP4 四位量化技术,内存占用压缩至约 493GB。即便如此,单台 512GB 内存的 Mac Studio 仍难以独立承载模型权重及推理所需的临时数据。因此,多机协同成为必然选择。

并行策略与高速互联

苹果展示了两种主要并行方式:
  • 流水线并行:模型不同部分分布在不同机器上,依次处理。优点是实现简单,但存在前后依赖,设备利用率受限。
  • 张量并行:同一层计算分配给多台机器共同完成,再汇总结果。这种方式能提升并发效率,但对设备间数据传输速度要求极高。
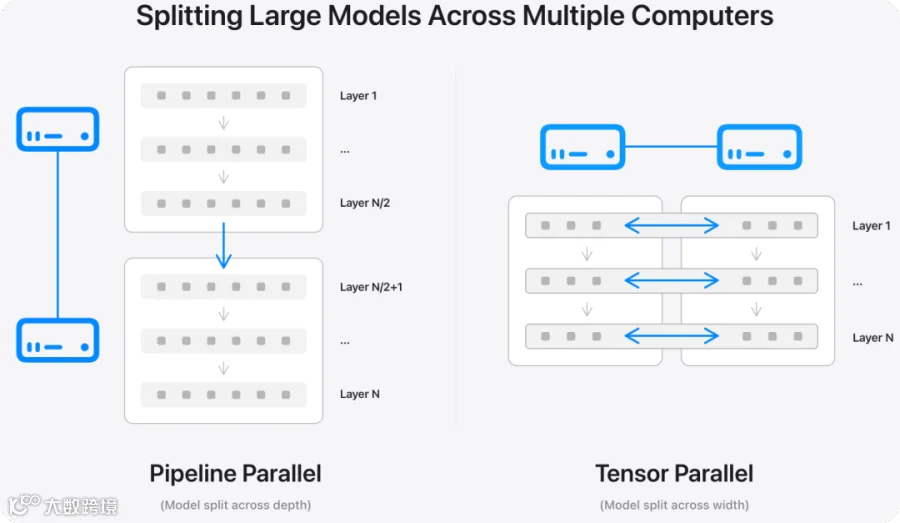
为解决延迟问题,苹果利用雷雳 5 接口的 RDMA 通信技术降低多机数据交换延迟,并通过双雷雳线连接增加带宽,由 MLX 框架协调计算。
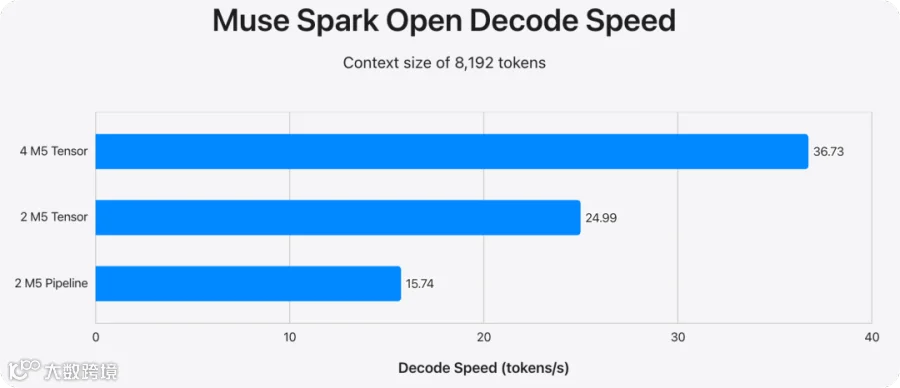
测试数据显示,在输入 8192 tokens、生成 128 tokens 的场景下:
  • 双机流水线并行速度约为 15.74 tokens/s;
  • 双机张量并行速度提升至 24.99 tokens/s,增幅近六成;
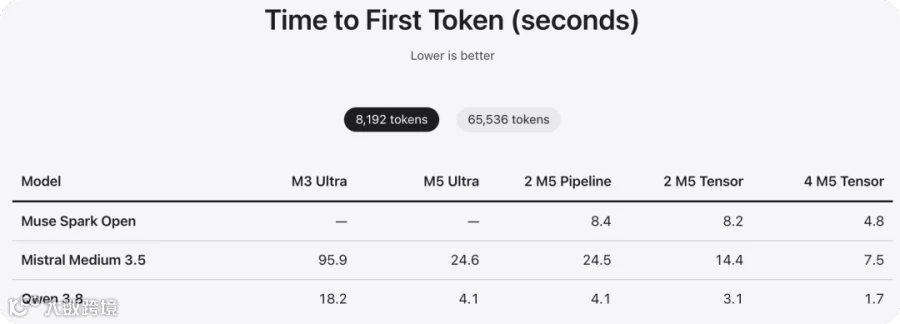
  • 四机张量并行速度达 36.73 tokens/s,首 Token 等待时间从 8.2 秒缩短至 4.8 秒。
M5 Ultra 芯片的硬件加持

这一成果得益于苹果软硬件的深度整合。统一内存架构实现 CPU/GPU 资源共享,M5 Ultra 将内存带宽从 M3 Ultra 的 819GB/s 提升至 1.2TB/s,新增的 Neural Accelerators 加速矩阵运算,显著改善了长上下文处理效率。
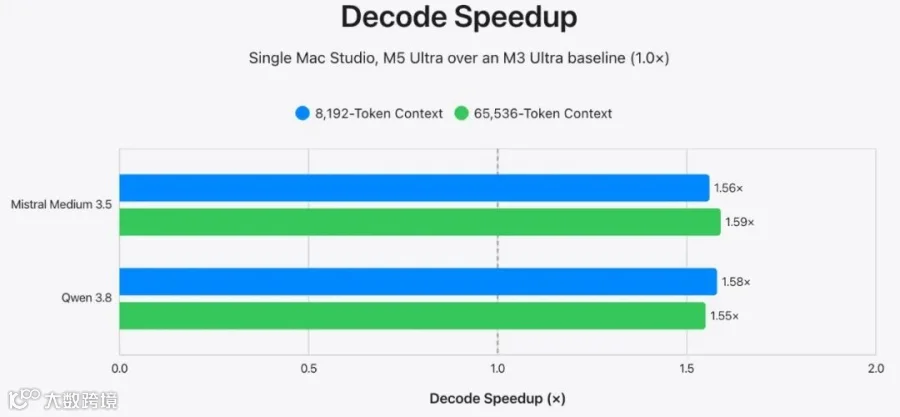
对比测试显示,在单机运行 Qwen 3.8 和 Mistral Medium 3.5 时,M5 Ultra 相比 M3 Ultra 的首 Token 等待速度提升最高达 4.6 倍,生成速度提升约 1.6 倍。
向左滑动查看更多内容
目前,该方案主要面向专业开发者。搭载 M5 Ultra 的 Mac Studio 起售价为 46999 元,且运行超大模型需配置多台设备,门槛较高。但苹果已清晰展示出桌面端自主构建 AI 环境的可行路径。

Minions 系统:激活闲置 Mac 的分布式算力

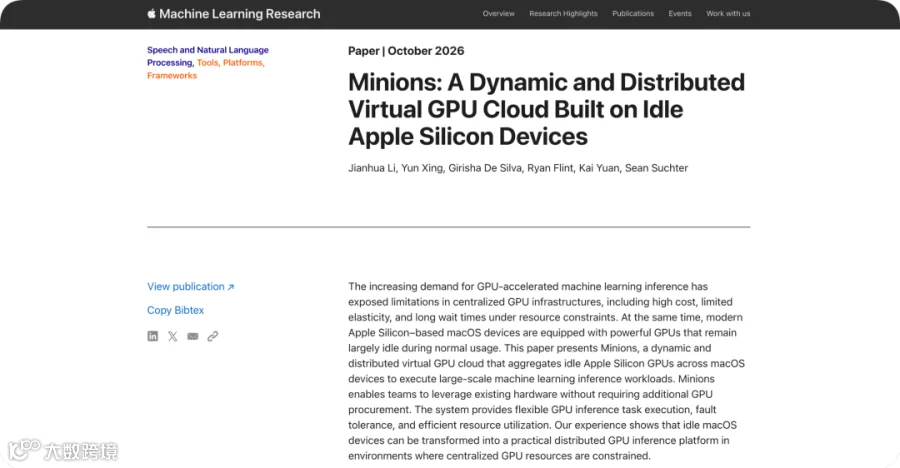
除高端集群外,苹果研究人员还发布了名为 Minions 的系统,旨在利用办公室内大量闲置 Mac 设备的 GPU 资源,构建共享推理资源池,缓解集中式 GPU 排队压力。
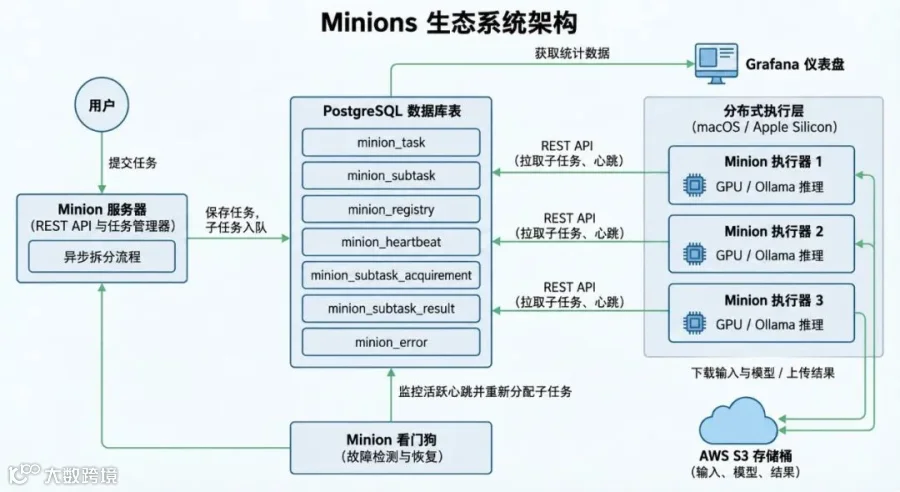
Minions 系统将任务拆分为子任务,由空闲 Mac 主动领取并利用本机 GPU 计算,完成后上传结果。该系统支持文本向量生成及通过 Ollama 调用本地大模型,适用于检索增强生成(RAG)及批量独立请求处理。
向左滑动查看更多内容
针对设备状态不稳定的问题,Minions 设有任务回收机制,一旦设备离线或繁忙,未完成任务将自动重新分配。用户可设置优先参与的项目,甚至通过即时通讯工具临时组建算力协作网络。
实际应用中,原本需排队十数小时的任务,通过 Minions 可在几分钟内启动。系统支持在特定团队或组织内部独立部署,确保算力共享符合数据管理规范。未来,研究人员还计划探索分布式模型训练。
从 Muse Spark Open 到 Minions,苹果正挖掘 PC 在 AI 时代的两种价值:一是凭借高性能硬件承载超大模型,二是利用闲置算力补充基础设施。随着用户对隐私和自主控制需求的提升,本地部署将成为重要趋势。苹果与 Meta 的合作,标志着芯片、内存生态与开放模型的深度融合,让越来越大的模型真正运行在用户的桌面上。
技术博客参考地址:
https://machinelearning.apple.com/research/mlx-distributed-inference
【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容 15835
粉丝 0
APPSO AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读513.5k
粉丝0
内容15.8k