


10月15日,前OpenAI研究员、现任Goodfire研究员Nick Cammarata在社交平台分享了一项引发AI研究界关注的发现:大型神经网络的内部结构可能远比过去认为的更易于理解。
与此同时,他发表了题为《Neural Networks Are Already Clean》(神经网络原本就很清晰)的长文,详细阐述了这一观点转变的原因。鉴于Cammarata曾深度参与OpenAI早期机制可解释性研究,并是推动大模型自动解释神经元核心成员之一,其从“特征纠缠难解”到“结构清晰可辨”的判断反转,迅速在技术社区引发热烈讨论。

(来源:X)
机制可解释性:从“混乱叠加”到“清晰功能”
机制可解释性(Mechanistic Interpretability)旨在厘清AI模型内部负责不同任务的神经元及其连接回路,解析模型从输入到输出的推导过程。作为识别模型错误、偏见及欺骗性行为的关键手段,该领域已被《麻省理工科技评论》评为2026年“十大突破性技术”之一。
然而,过去几年该领域面临巨大挑战。随着模型规模扩大,大量神经元似乎同时响应多个无关概念,导致内部结构显得极度复杂且难以拆解。学界因此普遍借助稀疏自编码器(SAE)等特征分解工具,试图从混杂的激活状态中还原独立特征。
Cammarata在长文中提出新见解:过往被视为“混乱”的证据,可能源于观察工具的局限及对模型学习规律的误判。借助新的分析方法和AI Agent,他发现主流大语言模型中的大多数神经元实际上具备相对清晰的功能解释,真正理解AI内部运作或许并非遥不可及。
90%神经元功能被破解:重新审视“叠加”假说
2023年,OpenAI利用GPT-4分析GPT-2神经元的研究显示,即使采用宽松标准,仅有约1.7%的神经元能被可靠解释。基于此,“叠加”(Superposition)假说盛行,即认为模型为节省空间,将互不相关的概念编码在重叠方向上,导致单个神经元响应多种特征。
Cammarata团队在对Qwen3-32B模型的初步审查中得出了不同结论:约90%的神经元响应方向对应明确的主导功能,约7表现为两个高度相关功能,仅2%-4%暂时无法找到清晰规律。在Kimi K3等万亿参数级模型中也观察到了类似现象。
尽管两项研究在模型架构、工具和评估标准上存在差异,但这一发现提示我们:过去大量神经元看似难以解释,可能与观察和理解方式有关。
认知纠偏:猫脸与汽车前脸的几何共性
机制可解释性领域有一个经典案例:InceptionV1视觉模型中的某个神经元同时对“猫脸”和“汽车前脸”产生强烈反应,常被引证为神经网络混淆无关概念的典型。
Cammarata重新检查该神经元激活样本及上下游连接后发现,其真正敏感的是“尖锐且向外展开的V形几何结构”。狐狸面部、升腾的火焰或水柱等具有相似几何特征的图像均能触发该神经元,而圆润形状则抑制其激活。

图|InceptionV1中的神经元对具有尖锐V形结构的图像产生响应(来源:Nick Cammarata)
此外,早期可视化方法引入的纹理伪影也曾误导研究人员。在调整方法并追踪连接后,许多看似混乱的响应均可通过共享的姿态和几何结构得到解释。
架构设计也影响神经元功能的清晰度。Cammarata对比发现,在相同数据和参数规模下,采用残差连接等现代设计的ConvNeXt视觉网络,其末层约99%的神经元具有清晰功能;而结构较老的InceptionV1末层神经元则普遍难以解释。

图|ConvNeXt视觉模型神经元对特定视觉概念的响应(来源:Nick Cammarata)
通过极端压缩实验,Cammarata提出了“递归泛化”(Recursive Generalization)理论:当模型容量有限时,神经元负责更广范围的特征概括;随着容量增加,神经元进一步分化处理细致概念。这一过程在语言模型中同样存在,如从字母组合到词汇再到语义概念的延伸。
AI研究AI:自动化可解释性的新范式
Cammarata研究的另一大突破是引入具备自主分析能力的AI Agent,将研究过程自动化。如今的AI Agent不仅能归纳激活样本,还能连续执行观察数据、提出假说、检查连接、设计验证实验等复杂任务,并主动寻找反例以修正判断。
研究中采用了一套严格的“盲测”机制:
- Agent A根据激活规律生成神经元功能解释;
- Agent B在不接触参数和激活数据的情况下,仅凭文字描述构造可能激活该神经元的新文本。
结果显示,AI生成的测试文本激活强度甚至超过了从上百亿Token语料库中筛选的真实样本。在涉及200个随机神经元的测试中,76%的新生成正向样本引发强烈激活,反例误激活率仅为11%。这为神经元解释的预测能力提供了定量证据。
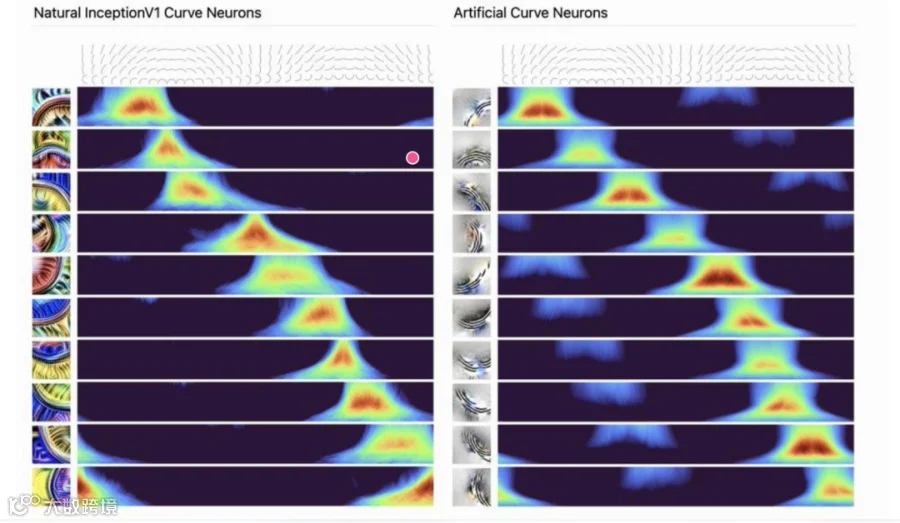
图|神经网络内部功能结构可视化(来源:Nick Cammarata)
Cammarata认为,随着越来越多神经元功能被解释,研究人员可利用已有连接关系推断未知部分,逐步构建完整的神经网络功能地图。若该方向得到验证,未来研究者或许可直接从原始神经元入手,借助AI Agent进行系统分析,无需每次都依赖额外的特征分解工具。
展望:AI安全与黑箱探索的新机遇
这一进展对AI安全与对齐研究具有重要价值。清晰追踪模型判断背后的神经元及计算回路,有助于识别推理错误、异常目标或欺骗性行为,并在开发过程中定位故障、分析训练机制改变。
当然,目前成果仍需进一步验证。该长文尚未经过正式同行评议,对Qwen和Kimi等大模型的统计结果也有待完整技术论文支持。理解单个神经元功能距离还原整个模型计算机制仍有距离,复杂行为背后的因果关系及组件协同工作仍是未解难题。“叠加”假说亦有其理论和实验依据,并未被完全推翻。
尽管如此,Cammarata的研究提供了一个值得重视的新视角:神经网络中的不少规律可能一直存在,只是此前未被正确识别。随着AI Agent介入神经元分析、假说提出及实验验证,研究人员有望以更快速度探索复杂的内部结构,重新思考“神经网络究竟有多难理解”这一基础问题。
参考链接:
1. https://already-clean.goodfire.com/
2. https://openai.com/index/language-models-can-explain-neurons-in-language-models/
3. https://www.technologyreview.com/2026/01/12/1130003/mechanistic-interpretability-ai-research-models-2026-breakthrough-technologies/
4. https://www.anthropic.com/news/tracing-thoughts-language-model
5. https://deepmind.google/blog/gemma-scope-2-helping-the-ai-safety-community-deepen-understanding-of-complex-language-model-behavior/
运营/排版:何晨龙
注:封面/首图由 AI 辅助生成