

阅读技术报告时,结论、条件、数据与限制往往分散在不同章节。若每次追问都需重新检索,研究成果便难以积累;若评测仅关注最终答案,则难以洞察系统的认知盲区。
近期,微软亚洲研究院推出 DocAtlas 与 XL-DocBench,分别从研究过程交互与能力评测两个维度探索长文档理解。相关论文已被 NeurIPS 2026 接收。
- DocAtlas:让智能体在搜索、阅读、记录和回顾中持续推进研究,使阅读成果可积累、可追溯。
- XL-DocBench:通过超长专业文档、人工证据标注及细粒度任务,系统检验模型的信息定位与推理可靠性。

DocAtlas:让每一次阅读,都为后续研究留下线索
PDF 的章节、页码和摘要可构建为可导航的“文档树”。DocAtlas 将长文档理解建模为智能体与可积累研究状态的持续交互,而非一次性检索生成。
核心机制:Search、Read、Note 与 Review
- Search(找方向)与 Read(查原文):主模型首先定位相关区域,按需打开文本、图像或图表。若材料不足,智能体会沿新线索继续探索,避免机械消耗固定检索片段。
- Note(保存发现)与 Review(召回记录):笔记不仅记录结论,还保留信息来源、已知条件及未决问题。页级发现可补充至文档树节点,既利用新线索,又保持原始 PDF 结构不变。

图 1:DocAtlas 概念图。四种工具按需使用,研究记录不等同于已验证证据。
例如,用户可先了解论文贡献,再核对实验设置并保存限制条件。后续追问时,Review 功能可召回相关记录,无需重载全部历史,但在关键判断时仍需回溯原文核验。
DocAtlas 积累的是带有来源的研究发现,而非无出处的压缩文本。其关键在于将“下一步读哪里”交给能感知研究状态的过程,确保新发现改变探索方向时,已有线索仍接受原文核验。

从理论方法走向实际操作的研究工具
DocAtlas 提供开源 TUI(终端用户界面)及 Web 版本预览。
在 TUI 中,用户选择 PDF 后即可提问,工作台实时展示寻找章节、读取材料及组织答案的过程。Web 界面则将模型回答与原文核验整合在同一工作流中,支持点击引用跳转原文、选中段落追问及保存来源清晰的笔记。

图 2:真实 TUI 演示
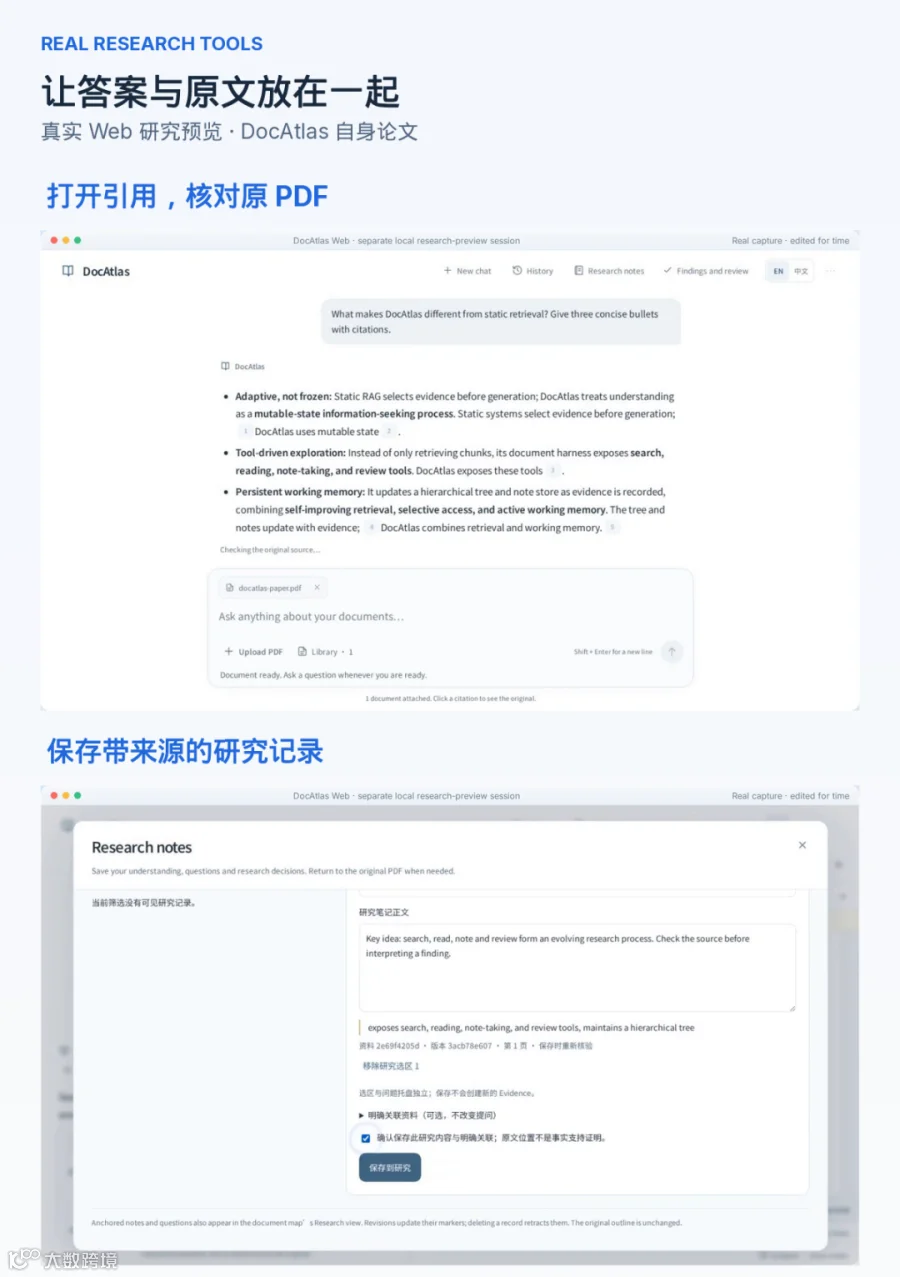
图 3:上图为原文核对;下图为保存研究记录。TUI 与 Web 为独立会话。
文档地图的修订属于研究层,不改写原始目录。这种界面可见性帮助用户区分模型生成内容与 PDF 原文,确保证据支持当前判断,使阅读、核对与记录成为连续的研究环节。

XL-DocBench:超越题目数量的综合评测体系
现有基准多侧重单页视觉或多页查找,难以全面覆盖超长专业材料、跨文档证据及多模态内容。XL-DocBench 旨在解决这一综合覆盖问题,包含 1,519 道题、331 份文档,涵盖金融、法律、医疗、技术等 6 个领域及 12 类推理任务。
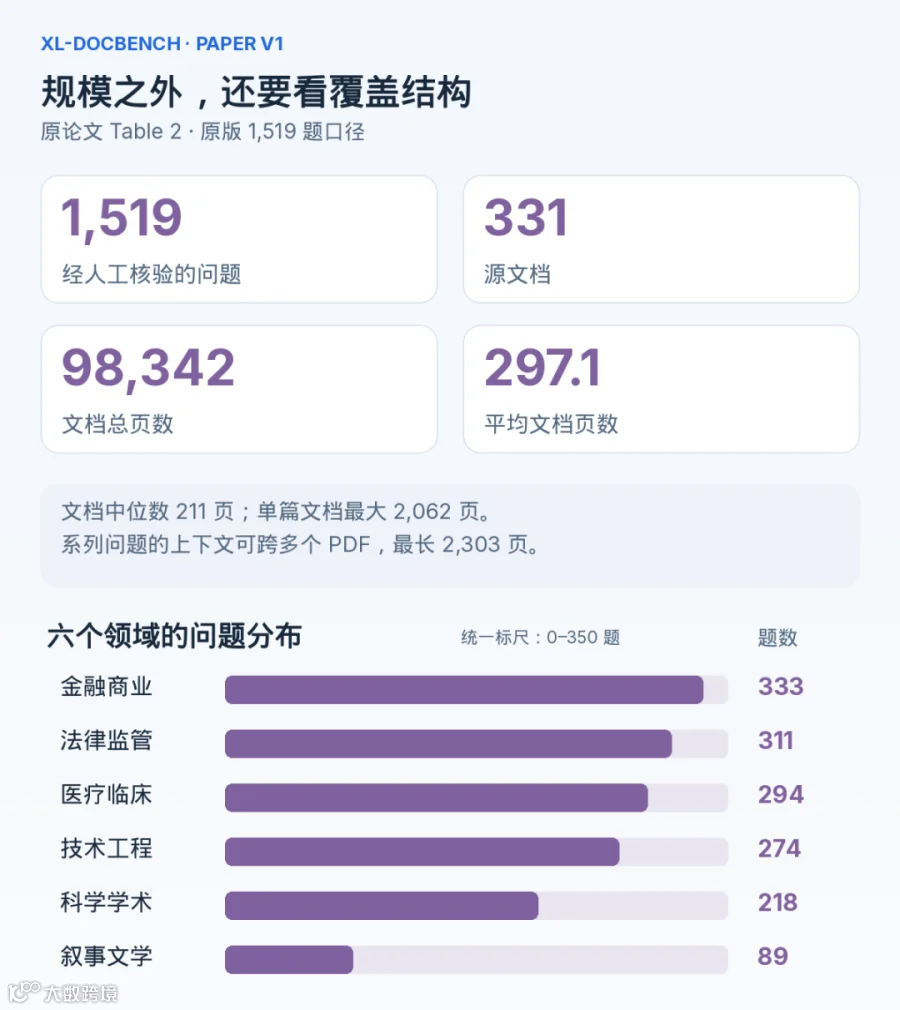
图 4:XL-DocBench 在六个领域的问题分布
长的不只是文档,证据之间也有距离
原始文档合计 98,342 页,平均每份 297.1 页,最长单份达 2,062 页。跨文档任务的上下文最长可达 2,303 页。
人工标注显示,证据页数平均为 2.30 页,但证据跨度中位数为 7 页,P95 达 255 页。这意味着虽然最终引用页数不多,但定位这些分散页面的难度极大。“最终引用页数”不能替代“定位难度”。
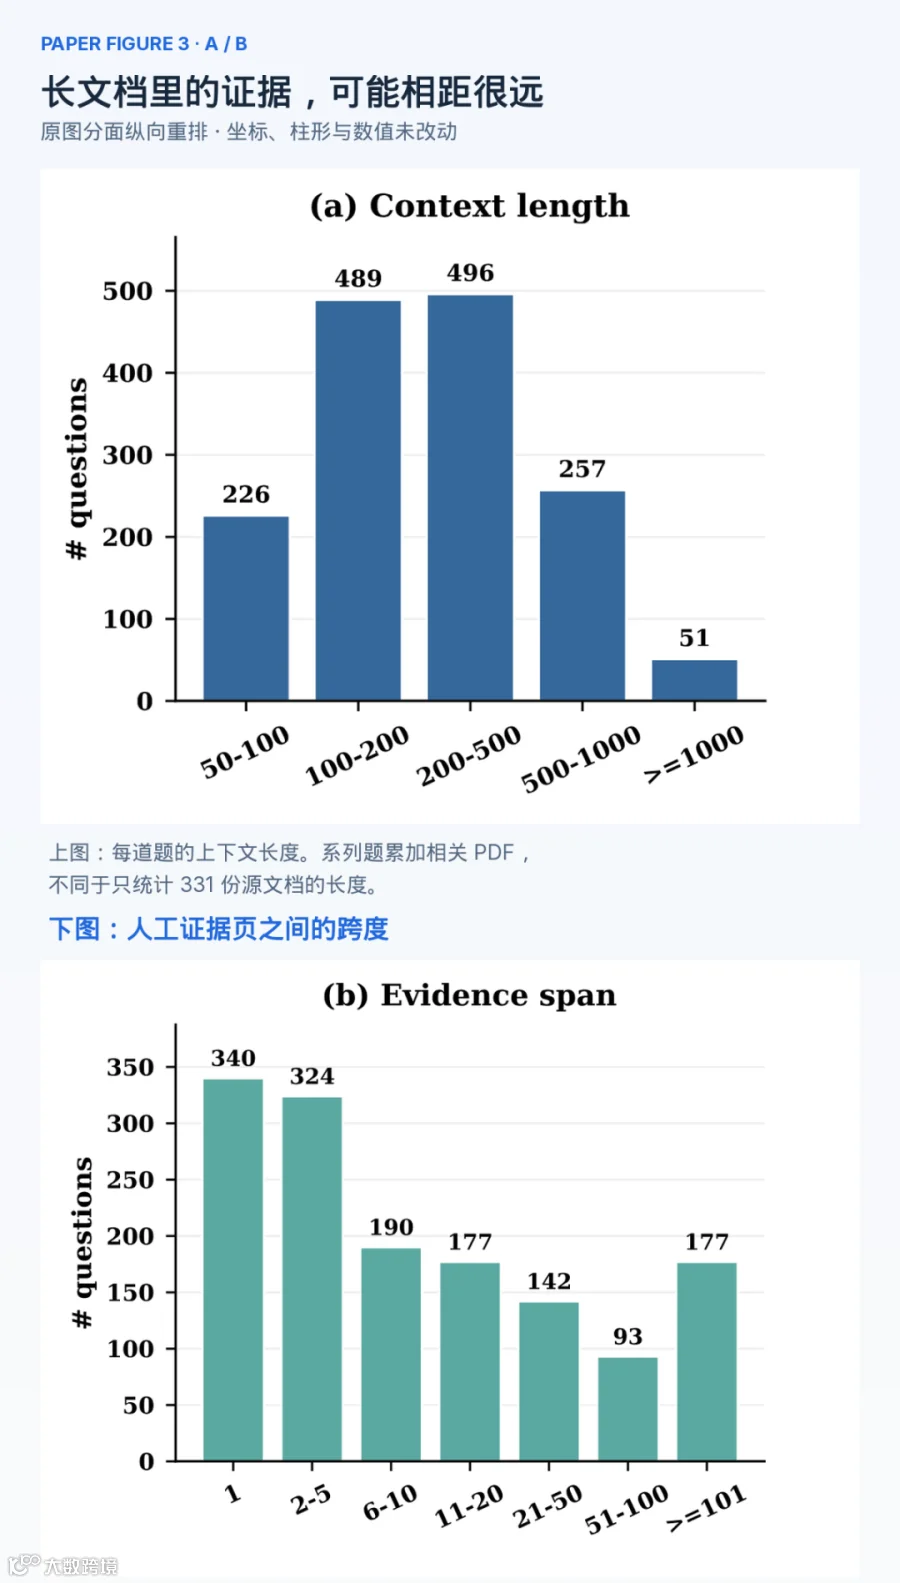
图 5:XL-DocBench 的上下文长度与证据跨度分布
跨页、多模态和跨文档的挑战
在 XL-DocBench 中:
- 72.6%(1,103 道)需要多页证据;
- 36.6%(556 道)涉及表格、图表或图像;
- 10.9%(165 道)属于跨文档任务;
- 部分题目采用 None 答案格式,检验系统在证据不足时避免猜测的能力。

图 6:XL-DocBench 的证据页数、跨文档证据与答案形式分布
十二类推理任务,精准定位失败原因
推理任务分为三个层次:
- 基础层:比较、引用链;
- 结构层:排序、覆盖、信息对齐;
- 高层:集合差、不可回答、时间关系、合规、反事实、聚合、一致性。
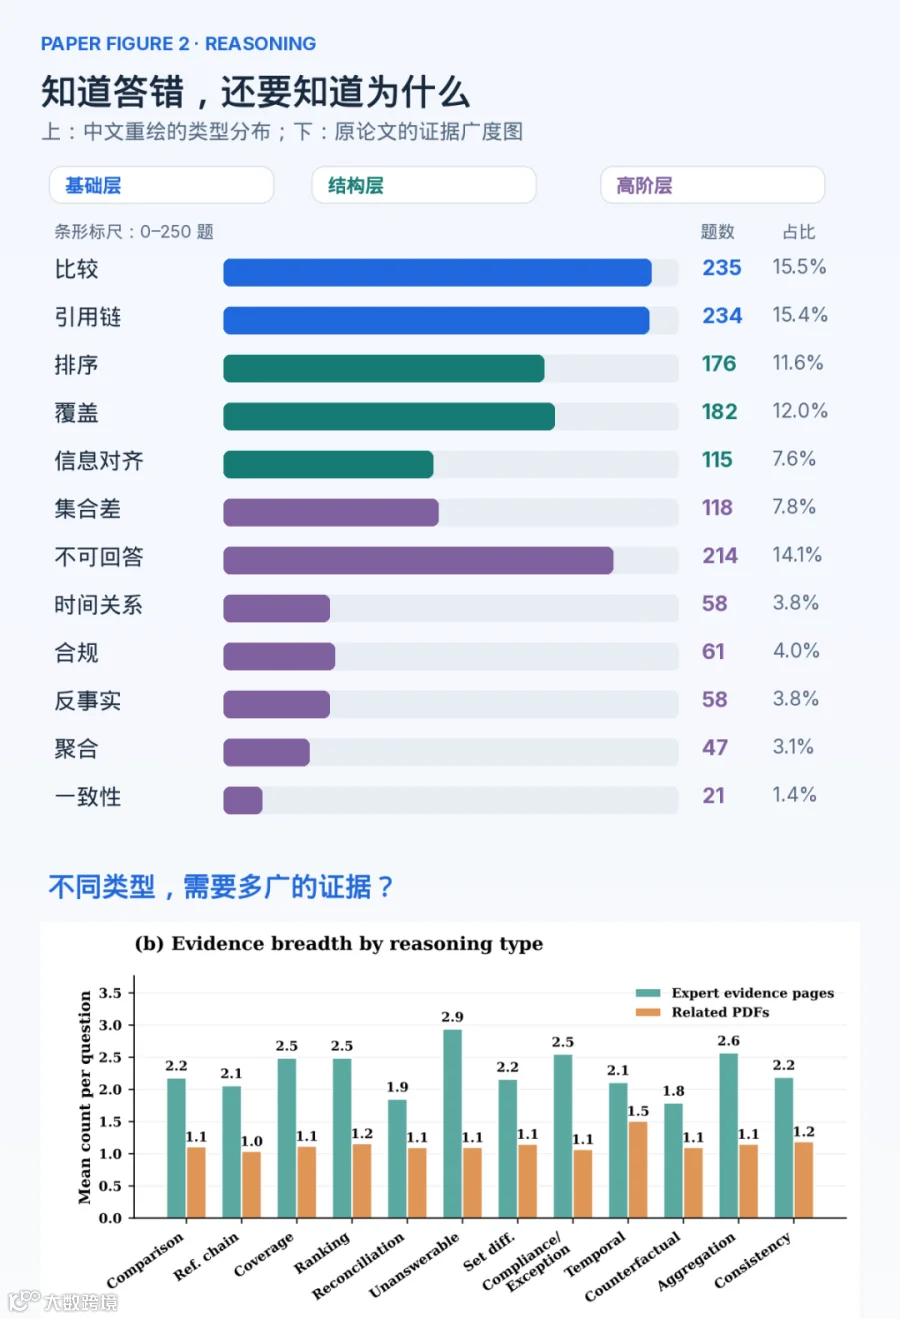
图 7:XL-DocBench 的推理任务类型及证据覆盖情况
这种分类有助于区分“未找到相关页”、“未找全集合”或“规则应用错误”等不同失败类型,即便总分相近,系统的能力短板也可能截然不同。

模型提出候选,专家建立最终依据
XL-DocBench 采用“人工引导、模型辅助”的树引导构造流程:
- 候选生成:基于章节摘要提出问题,按领域和推理类型采样。
- 依赖检查:隐藏特定分支,若模型仍能作答,则该问题不依赖此分支,予以筛选。
- 细化与草稿:展开至具体页面,细化作答条件,模型生成草稿答案。
- 专家核验:194 位专家访问源文档,重新回答问题,标注支持页和原句,检查歧义与规则。

图 8:XL-DocBench 的树引导式数据构建与人工核验流程
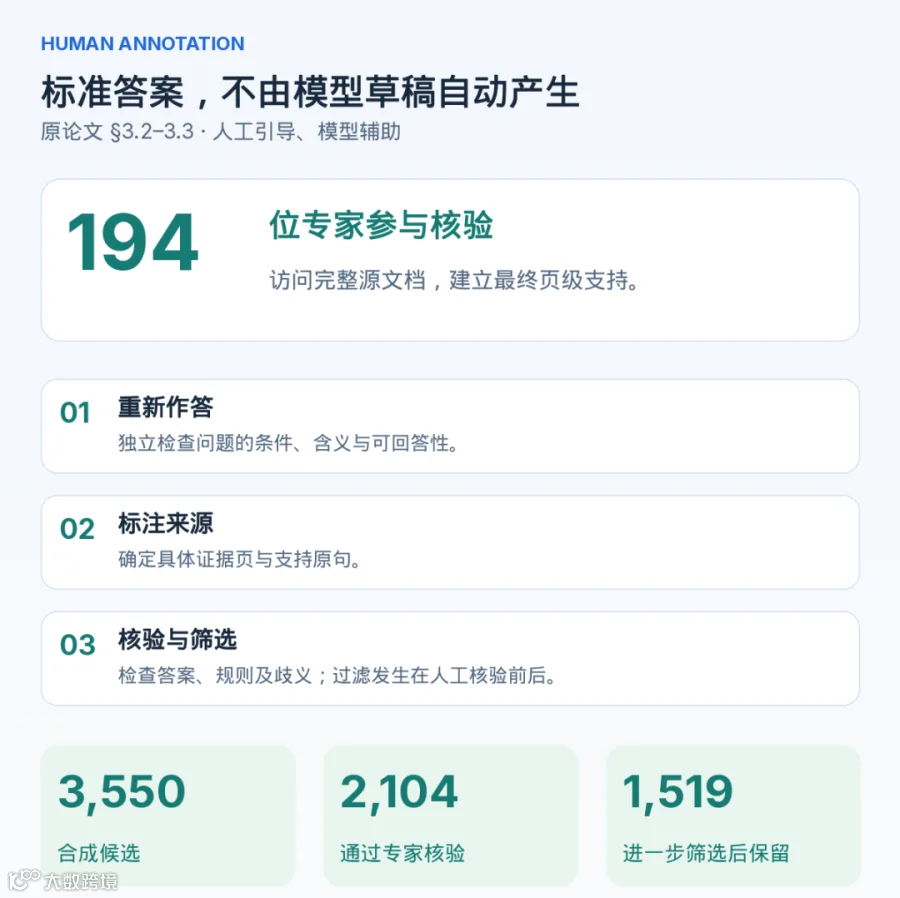
图 9:XL-DocBench 的候选问题筛选与专家核验结果
需注意,文档树在 XL-DocBench 中用于构题,在 DocAtlas 中用于导航研究,两者独立。基准的标准答案和人工标签不会提供给被评测智能体。

基准验证:DocAtlas + GPT-5.4 达到 53.7%
在 XL-DocBench 测试中,DocAtlas + GPT-5.4 取得 53.7% 的精确度,比对照系统 SimpleDoc + GPT-5.4(44.0%)高出 9.7 个百分点。

图 10:DocAtlas 与 SimpleDoc 在 XL-DocBench 测试集上的准确率对比
诊断分析显示:
- 找到证据但回答错误:多为规则应用或答案形式问题;
- 未找到所需页面:多为检索和上下文组织问题。
仅增加上下文窗口或工具调用轮数无法自动解决上述问题。拆解上下文长度、证据页数与证据跨度等指标,有助于判断改进方向是检索、证据组合还是推理规则。
此外,在 MMLongBench-Doc 基准上,DocAtlas 协助 GPT-5.4 从 62.4% 提升至 71.4%;4B 策略经训练达到 63.7%。

总结:让研究过程可积累,理解能力可检验
DocAtlas 提供了寻找、读取、记录和回顾文档的工作方式;XL-DocBench 提供了面向超长材料的任务、人工证据和评价工具。二者共同推动长文档理解从“生成流畅答案”向“基于证据的可核验研究”转变,为长文档智能体的可靠应用奠定基础。
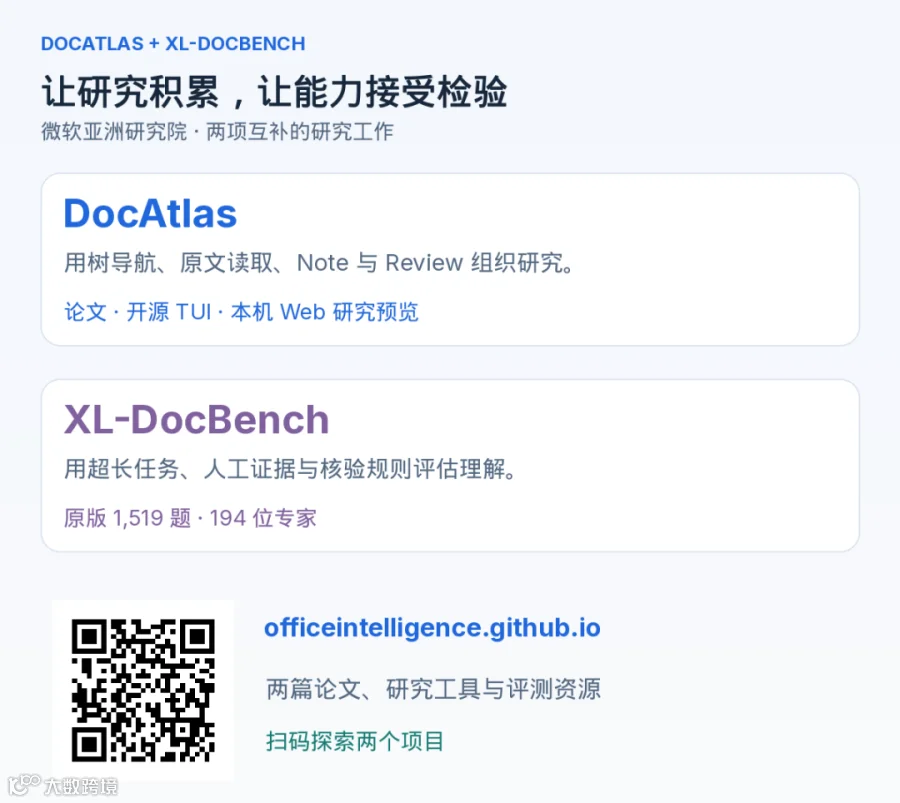
图 11:DocAtlas 与 XL-DocBench 的项目资源入口
项目资源:
项目页面:
https://officeintelligence.github.io/
DocAtlas 论文:
https://arxiv.org/abs/2608.07527
DocAtlas 开源工具:
https://github.com/microsoft/DocAtlas-Harness
XL-DocBench 论文:
https://arxiv.org/abs/2608.00036
XL-DocBench 当前公开数据:
https://huggingface.co/datasets/microsoft/XL-DocBench
#AI #Agent #人工智能 #长文档理解 #智能体 #AI研究 #微软亚洲研究院 #DocAtlas #XLDocBench #大模型评测 #文档智能 #生成式AI