输入持续的音视频流和一个问题,输出的是一次能被打断、能主动开口、还能顺手把任务交给后台工具的实时对话。蚂蚁集团联合清华大学推出Realtime-Venus,用两个独立训练的9B模型把"全双工交互"和"异步委托"放进同一套因果时间线,在Full-Duplex-Bench v1.5上三项续接指标全部超过Gemini 3.1 Live与GPT-4o。
实时交互模型这两年解决的主要是"能不能边听边说",Moshi、Freeze-Omni、Qwen3-Omni都交出了各自的答案。但真把这类模型放进一个需要持续看画面、持续听声音、还要查天气订餐厅的场景,问题马上变多:模型说话时还在不在感知?用户随口"嗯"一声它会不会闭嘴?让它查个航班,对话是不是得停下来等?
蚂蚁集团inclusionAI联合清华大学推出的Realtime-Venus,把这三件事放在同一个系统里处理,将全双工对话模型与异步执行框架结合起来:你可以让助手处理任务,同时继续和它交流;任务完成后,结果回到同一段对话中,由模型用语音告诉你。9B的体量加BF16约18GB显存,单张4090装得下。
核心能力
-
持续的视听交互。 Omni 持续接收摄像头和麦克风输入,能够根据场景中的新变化主动发起回应。 -
全双工对话。 模型在说话时继续处理用户输入,学习区分附和、背景人声与需要调整回复的打断。 -
异步任务委托。 遇到需要进一步推理或调用工具的请求,模型将自然语言任务交给 Harness 执行,实时对话继续进行。 -
在原对话中交付结果。 Harness 准备回复内容,前端模型决定发言时机并生成语音;任务执行完成与结果实际播放分别跟踪
整个项目由三个部分组成:
-
Realtime-Venus-Omni-9B: 面向流式音视频的对话模型,支持持续感知、主动交互与原生语音生成。 -
Realtime-Venus-Audio-9B: 单独训练的语音对话模型,支持音频理解、全双工交互与原生语音生成。 -
Realtime-Venus-Harness: 两类模型共用的异步执行框架,负责接收委托、推进后台任务,并将结果送回原会话。
相关链接
-
论文:https://arxiv.org/abs/2609.13814 -
代码:https://github.com/inclusionAI/Realtime-Venus -
主页:https://realtime-venus.github.io/ -
模型权重:https://huggingface.co/inclusionAI/Realtime-Venus -
国内镜像:https://www.modelscope.cn/models/inclusionAI/Realtime-Venus
内容介绍
Realtime-Venus是一套实时全双工交互系统,输入是持续的视频流和音频流,输出是文本与语音,外加一类不直接面向用户的"委托请求"。它包含两个独立训练的9B模型:Realtime-Venus-Omni处理音视频输入,Realtime-Venus-Audio只处理语音,两者共享同一套委托接口和运行时结构。
与常规"语音进、语音出"的对话模型不同,它的核心卖点是三件事:
-
主动交互:不等用户提问,持续对齐处理视频与音频,事件值得回应时自己开口 -
全双工对话:说话时继续感知,能区分附和、打断、纠错和话题转移,被打断后决定停、修还是转向 -
异步委托:对话中发出 <delegate>请求,后台Harness执行外部工具,结果回流进正在进行的对话,不阻塞交互
适用场景:需要持续看画面的语音助手、带工具调用的实时数字人、长时段陪伴与监控类交互。
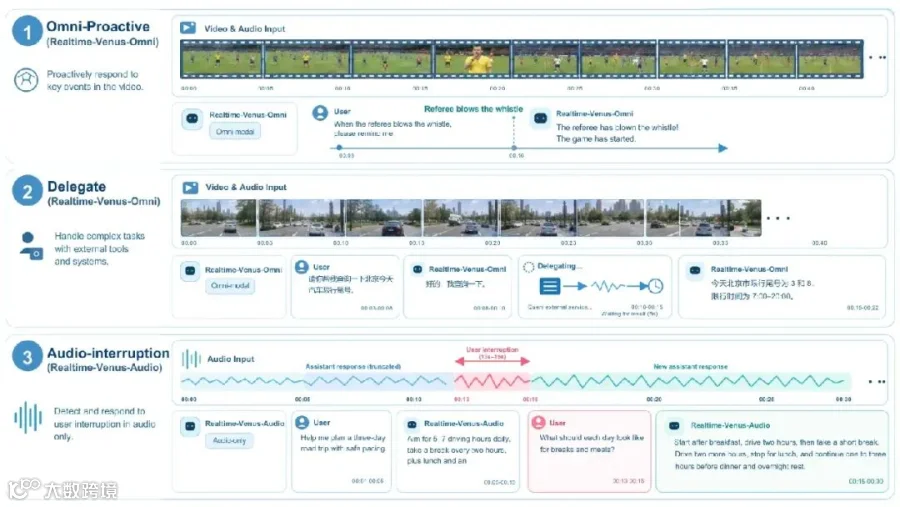 上:Omni-Proactive,裁判鸣哨时模型主动报"裁判鸣哨了,比赛开始了";中:Delegate,用户请模型查今天汽车限行尾号,模型边回应"好的,我查一下"边委托后台查询,数秒后播报限行尾号与时段;下:Audio-interruption,用户在第13秒打断,模型停下原回答转向新问题。
方法概述
一套机制管"什么时候说",一套机制管"说什么",还有一套机制管"不该自己算的交给谁"。
1. 双环运行时与统一流序列化
系统分两个环:交互环持续处理输入媒体、更新会话状态、决定听/说/让,延迟敏感;能力环由前端发出的私有自然语言委托请求激活,由Harness选择后端能力执行、把结果整理成可口语播送的回复,再经私有后台通道送回原会话。
两个环的接口被形式化成一个统一的运行时迁移。会话按1秒为一块(chunk)组织,每块对齐三条逻辑流——用户流、助手流、后台流,共享同一个会话时钟。每块输出四元组(c_k, Y_k, D_k, S_k):交互控制token、面向用户的文本、委托文本、语音token,其中只有文本和语音对用户可见。委托请求在发出那一刻就把当时的证据固化成快照,之后对话怎么变都不影响后台任务的输入边界;而它准备好的回复在什么时机说出口,由前端根据当前交互状态决定。
这个设计的意图很明确:后台执行可能要几十秒,但对话不会停,结果回来时语境可能已经变了。把"证据固化"放在请求边界、把"何时播报"留给前端,两件事就解耦了。
2. 全双工对话控制
模型架构继承MiniCPM-o 4.5的Omni-Flow。视觉与音频特征投影后交给Qwen3-8B骨干,骨干生成的文本与hidden state一起条件化离散S3 speech token预测,再由一个流式flow-matching解码器把token转成波形块,参考音频来自系统提示。
每个1秒单元里,语言模型预测<|listen|>或<|speak|>。说话单元里先生成响应文本,再条件化对齐的S3语音token;<|chunk_eos|>关闭一个语音块,<|turn_eos|>结束一轮。这个分块调度的价值在于:感知始终与说话并发,而尚未说出口的续接部分是可修订的——这正是它能在用户纠正时"改口"的结构基础。
训练数据按行为分:视频侧936k通用音视频理解、454k视觉主动双工、201k全模主动双工、315k语音切入双工、95k委托;音频侧470k通用音频理解、205k口语问答、100k纯语音双工、90k委托。整条管线产出约72200个会话语料、约1600小时对齐音频,中英会话各约36100条。
 全双工与委托数据管线:场景与交互规划、副语言与声学实现、时间对齐三条主链,输出模型专属数据。 Duplex behavior 一栏给出CONTINUE/HOLD/YIELD/STOP/RECOVER五类控制token。
3. 免训练长视频记忆
滚动上下文窗口终有上限,会话拉长到几十分钟后早期内容就掉出窗口。Realtime-Venus-Omni外挂一个长期记忆模块,不需要额外训练,与微调后的对话策略解耦。
构建时用运动补偿预测代价做视觉门控:每个采样帧与前一帧做轻量块级运动匹配,用预测残差和运动代价估计视觉变化量,变化小的帧不入库;另设局部变化保护和最大连续丢弃约束,避免把短促的视觉事件弄丢。检索时受MaxSim启发,对每个查询token取它在一帧所有视觉token上的最大余弦相似度作为token级匹配分,再用分数的MAD(中位绝对偏差)加权聚合出帧级相关度;候选帧之间再比视觉新颖度,按MMR的相关性-多样性原则合成最终检索分。召回后把时间相邻的音频段合并、按时间顺序与近期短窗和当前查询拼成上下文。模型卡给出的用法是use_memory(memory_minutes=40)。
4. 异步委托Harness
Realtime-Venus-Harness是共享的异步能力执行框架。前端发出的委托请求被宿主从用户可见输出中隐藏,请求边界的上下文被固化为任务包,路由给注册的后端能力异步执行,产出经打磨后作为私有上下文回流;新鲜度检查决定结果是否仍然适用,播放感知投递决定它何时重新进入对话。工作项有明确生命周期:Queued→Running→Completed→Delivering→Delivered。
作者在论文里称,据其所知Realtime-Venus-Omni是第一个在维持视频交互的同时支持异步后端调用(推理与工具执行)的全双工全模模型。
 Realtime-Venus-Omni架构:左侧为流式感知到流式输出的主干,右侧为音频视觉记忆的构建、检索(Relevance+Novelty)与重组。
实验结果
流式视频理解
对比在线模型(可边看边响应),Realtime-Venus-Omni在8项中拿下6项最高:
|
|
|
|
|
Realtime-Venus-Omni (9B) |
|---|---|---|---|---|
|
|
|
|
|
70.2 |
|
|
|
|
|
64.7 |
|
|
47.5 |
|
|
|
|
|
|
|
|
29.0 |
|
|
54.2 |
|
|
|
|
|
|
|
|
81.3 |
|
|
|
|
|
39.2 |
|
|
|
|
|
38.9 |
两处必须写清楚的非全胜:Proactive VideoQA上46.2低于MiniCPM-o 4.5的47.5,WorldSense上54.0低于54.2——基座本身在这两项并不落下风。另外,表中Gemini-3.5-Flash八项全部更高(77.3/71.6/56.5/52.4/67.2/82.3/64.6/58.2),只是它属离线闭源模型,不在"在线模型"之列。
长视频记忆带来的增益主要落在长区间:LVOmniBench的[60,90)秒段从41.18升到47.06,LongVideoBench的[60,65)秒段从49.53升到50.47;短区间上记忆几乎无增益,[40,60)秒段LongVideoBench从52.89微升到53.29。
音频理解与口语问答
|
|
|
|
|
Realtime-Venus-Audio (9B) |
|---|---|---|---|---|
|
|
|
|
|
78.0 |
|
|
|
|
|
63.2 |
|
|
66.4 |
|
|
|
|
|
69.0 |
|
|
|
|
|
|
|
|
4.81 |
|
|
|
|
|
83.8 |
|
|
75.9 |
|
|
|
|
|
|
|
|
67.8 |
MMAU和MMAU-Pro赢了30B级的Qwen3-Omni,但MMAR(66.4 vs 65.6)、MMSU(69.0 vs 66.8)、TriviaQA(75.9 vs 75.7)三项仍是Qwen3-Omni更高——9B对30B-A3B,赢在MMAU系,输在细粒度音频推理与知识问答,这个交叉值得如实写。
全双工交互
Full-Duplex-Bench v1.5上的四类场景,C_RESPOND指是否做出该做的响应,C_RESUME指被打断/被附和后是否恢复了不该恢复的输出:
|
|
|
|
|
|
Realtime-Venus-Audio |
|---|---|---|---|---|---|
|
|
0.88 |
|
|
|
|
|
|
0.07 |
|
|
|
|
|
|
|
|
|
0.00 | 0.00 |
|
|
|
|
|
|
0.97 |
|
|
0.17 |
|
|
|
|
|
|
|
|
|
|
0.88 |
|
|
0.10 |
|
|
|
|
|
|
|
|
|
|
0.86 |
三项续接指标(97%/88%/86%)确实是全表最高,摘要里"超过Gemini 3.1 Live与GPT-4o"的表述也明确限定在continuation上。但用户打断这一项它并不占优:C_RESPOND 0.75低于Joy-Duplex的0.88、GPT-4o的0.78、Gemini 3.1 Live的0.77;被打断后错误恢复的C_RESUME 0.23,也比GPT-4o的0.10和Joy-Duplex的0.07高。它在附和、他人对话、背景语音这类"不该被打断"的场景里几乎不误触发(C_RESPOND低至0.00–0.11),代价是对真打断的响应略保守。
异步委托
委托基准区分"会不会选工具"和"任务有没有办成":
|
|
|
|
|
|---|---|---|---|
|
|
87.6% | 68.0% | 60.0% |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
工具选择F1上它仅次于GPT-Realtime,但任务最终办成的Pass@1只有43.0%(Omni)/48.0%(Audio),明显低于GPT-Realtime的60.0%。内部委托评测同样暴露失衡:Realtime-Venus-Audio的外部能力项92.22、日常交互项只有39.44,整体68.89;Omni整体75.93。会选工具不等于能交付,这是全文最实在的一处短板。
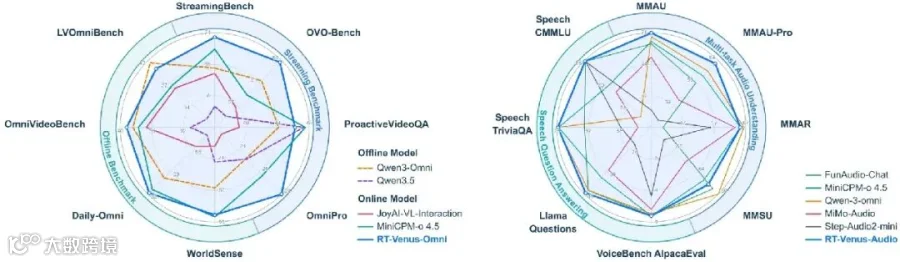 左:8项视频benchmark,RT-Venus-Omni与离线模型(Qwen3-Omni、Qwen3.5)及在线模型(JoyAI-VL-Interaction、MiniCPM-o 4.5)对比;右:8项音频benchmark,RT-Venus-Audio对比Fun-Audio-Chat、MiniCPM-o 4.5、Qwen3-Omni等。
 用户打断、附和、对他人说话、背景语音四场景下的C_RESPOND与C_RESUME明细,蓝色为Realtime-Venus两个模型。
局限与未来方向
首先,用户打断响应并不领先。0.75的C_RESPOND低于Joy-Duplex、GPT-4o与Gemini 3.1 Live,C_RESUME 0.23也高于这三家,强项集中在"不该打断时别乱动",而非"该打断时立刻停"。
其次,委托任务的交付率明显偏低。Pass@1最高48.0%对GPT-Realtime的60.0%,内部评测里Realtime-Venus-Audio的日常交互项只有39.44——外部能力项92.22与它差距超过50分,说明委托能力与基础对话能力在同一个模型里还没对齐。
此外,评测口径也有边界。在线模型对比不含Gemini-3.5-Flash这类闭源离线模型;委托基准的工具集与真实生产环境的工具分布未必一致;长视频记忆的增益集中在60秒以上区间,短区间几乎无收益。权重的实际推理帧率、首响延迟,论文与模型卡均未披露。
结论
Realtime-Venus验证了一件事:全双工对话控制和异步工具执行可以放进同一个因果时间线里,由一个9B模型同时承担,而不必拆成"对话模型+外部编排层"。
对于做实时语音助手和数字人的工程团队,它是目前少有的可本地部署、可细看实现的全双工全模参考实现,Omni-Flow加控制token的调度思路值得读代码验证;对于做智能体编排的开发者,Harness的"请求边界固化证据、前端决定播报时机"是一套可以单独借鉴的接口设计。风险提示有三条:权重Apache-2.0但论文页面标注CC BY-NC-SA 4.0,商用前需再确认;9B BF16约18GB显存,无官方量化版本,4090以下显存需自行处理;权重新上架,下载量还低,社区尚无复现与踩坑记录,真上生产前要自己测首响延迟与打断表现。
把"什么时候说"和"让谁去做"放进同一个模型的决定,可能比模型本身的具体分数更能说明实时交互的下一步方向。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~