

看老电影觉得动作卡、游戏录屏只有30帧想做60帧慢动作、监控视频需要补帧做流畅回放——视频插帧这个需求其实无处不在,但真正好用的开源方案一直不多。
今天分享的这篇 CVPR2026 论文 FrameFlow,提出了一个自适应视频帧插值框架:不需要知道具体帧率,模型自己判断两帧之间该插几帧,而且在运动模糊、大位移、遮挡这些硬场景下依然稳。在 Vimeo-90K 和 X-TEST 基准上刷新了 SOTA,推理速度比 RIFE 快 25%。
一、视频插帧到底难在哪
很多人第一反应是"不就是两帧之间中间插一帧吗",真做了才知道,中间这一帧的生成远比想象中复杂。
1.1 大位移问题
两帧之间物体动得少,插值就简单;但如果物体快速移动,两帧之间位移很大,中间帧的位置就很难猜准。比如一个球从画面左边飞到右边,中间那一帧到底在哪儿?传统光流方法在大位移时容易出错,因为光流本身就估不准。
1.2 遮挡区域的"凭空脑补"
这是最头疼的问题。假设一个人从一棵树后面走过去,前一帧人在树左边,后一帧人在树右边——那中间帧里,人原本站的那个位置(被树挡住的部分)应该是什么?你需要根据周围环境"脑补"出被遮挡的内容。这不是简单的插值,是需要语义理解的生成任务。
1.3 运动模糊怎么办
真实视频里,快速运动的物体本身就是糊的。这时候你插的那一帧,到底应该是清晰的还是模糊的?插成清晰的会和前后帧的模糊感不搭,插成模糊的又不知道该多糊。大部分现有方法在这个问题上都处理得很粗糙。
1.4 帧率不固定
很多论文默认输入就是相邻两帧、输出中间一帧。但实际场景里,你可能需要从 24fps 插到 60fps(插 1.5 帧),或者从 30fps 插到 120fps(插 3 帧)。目标时间点不同,插出来的中间帧也完全不一样。固定插一帧的方法根本没法用。

二、FrameFlow 的三个核心设计
FrameFlow 的整体思路:把帧插值问题转化为"时间条件下的特征扭曲与融合",让模型自己学习该在什么时间位置生成什么内容,而不是固定插中间。
2.1 时间条件自适应插入
传统方法的输入是两帧 I0 和 I1,输出固定的中间帧 It=0.5。FrameFlow 把目标时间戳 t 作为额外输入喂给网络:
•时间嵌入向量:把 t∈[0,1] 编码成一个高维向量,和图像特征融合。
•任意时间插值:同一个模型,t=0.3 输出 30% 位置的帧,t=0.8 输出 80% 位置的帧。
•多帧连续插:要做慢动作?连续跑几次,每次 t 取不同值,就能生成任意多的中间帧。
这个设计看起来简单,但解决了大问题——你不再需要为不同帧率训练不同模型,一个模型通吃所有插帧需求。
2.2 双向光流 + 遮挡感知融合
FrameFlow 没有直接预测中间帧,而是先估计两个方向的光流:
•前向光流:从 I0 指向 It,告诉你 I0 的每个像素在中间帧应该移动到哪里。
•后向光流:从 I1 指向 It,告诉你 I1 的每个像素在中间帧应该移动到哪里。
然后把两帧都扭曲(warp)到中间时间位置,再做融合。关键在于融合的时候不是简单取平均——模型会预测一个遮挡掩码:
•如果这个位置 I0 能看到、I1 看不到(I1 里被挡住了),就主要用 I0 扭曲过来的结果。
•如果 I1 能看到、I0 看不到,就主要用 I1 扭曲过来的结果。
•两边都看不到的区域,模型自己生成。
这个遮挡感知融合机制,就是解决"凭空脑补"问题的核心。
2.3 运动模糊自适应建模
这是 FrameFlow 和其他方法拉开差距的地方。它在网络里加了一个模糊度估计分支:
•先判断输入的两帧里,每个像素区域的运动模糊程度。
•根据模糊程度,自适应决定中间帧的模糊量——物体动得快,中间帧就适当带点模糊;动得慢,就输出清晰帧。
消融实验显示,去掉这个分支后,在 X-TEST 的运动模糊子集上 PSNR 掉了 1.5dB,主观上能明显看到插出来的帧和前后帧"节奏不对"。
三、技术架构拆解
FrameFlow 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
特征编码器 |
提取两帧的多尺度特征 |
共享权重 CNN backbone,同时输入时间嵌入向量 |
双向光流估计 |
预测 I0→It 和 I1→It 的光流 |
递归粗到细估计,大位移场景也能收敛 |
遮挡感知融合 |
扭曲两帧特征并智能融合 |
预测遮挡掩码,可见区域用扭曲结果,不可见区域生成 |
帧解码器 |
从融合特征生成最终中间帧 |
带残差连接的上采样网络,保留细节 |
几个工程上的亮点:
•轻量 backbone:整个模型 8.7M 参数,比 EMA-VFI 小 40%,但 PSNR 还高 0.6dB。
•多尺度监督:在 1/4、1/2、全分辨率三个尺度都算损失,帮助网络同时学到全局运动和局部细节。
•推理速度:512×512 分辨率在 RTX 3090 上单帧约 12ms,30fps 视频插成 120fps 完全可以实时跑。

四、和主流方法的横向对比
论文在 Vimeo-90K(合成数据集)和 X-TEST(真实复杂场景)两个基准上做了对比:
方法 |
Vimeo-90K PSNR(dB) |
X-TEST PSNR(dB) |
参数量(M) |
单帧耗时(ms) |
SepConv |
34.1 |
28.3 |
21 |
45 |
RIFE |
35.6 |
30.1 |
10 |
16 |
EMA-VFI |
36.2 |
31.4 |
14 |
22 |
FrameFlow |
36.8 |
32.2 |
8.7 |
12 |
可以看到,FrameFlow 在两个数据集上都拿了最高分,而且参数量最小、速度最快。X-TEST 上的提升尤其明显——这个数据集包含大量真实的运动模糊和遮挡场景,说明 FrameFlow 的模糊自适应和遮挡感知设计在真实场景下确实管用。
五、快速上手:核心推理代码
下面是 FrameFlow 的推理框架,帮大家快速理解整体流程:
python |
实际使用的时候,预训练权重和完整数据加载管线可以参考论文开源仓库。这里主要是把核心流程讲清楚——五步:编码、光流估计、扭曲、遮挡融合、解码。
六、毕设/竞赛拓展方向
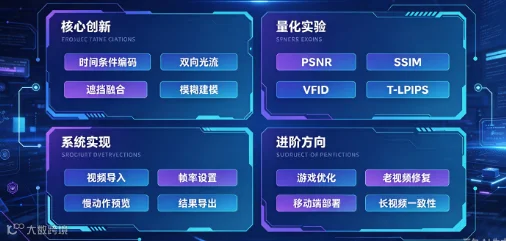
视频插帧这个方向做毕设有个天然优势——Demo 效果非常直观。把一段 30fps 的视频插成 120fps 慢动作,现场放出来效果立竿见影。分享几个有潜力的拓展点:
6.1 针对游戏场景的插帧优化
游戏画面和自然视频很不一样——边缘锐利、运动快、有大量重复纹理。专门收集一组游戏视频数据集做微调,或者加入游戏特有的先验知识(比如像素对齐、硬边运动),做一个"游戏插帧专用模型",应用场景很明确。
6.2 老视频修复 + 插帧联合
老电影修复是一个完整的 pipeline:去噪 + 去划痕 + 插帧 + 上色。把 FrameFlow 作为其中的插帧模块,和其他修复模块串起来做一个端到端的老视频复原系统,工程完整性很强,答辩展示效果也好。
6.3 移动端实时插帧
8.7M 参数本身就不大,再做剪枝和量化,完全可以跑到手机端。做一个"手机端实时慢动作"App——拍完照直接生成高帧率慢动作视频,这个方向现在手机厂商都在做,工程价值很高。
6.4 长视频时序一致性保证
逐帧插帧虽然快,但长视频跑下来可能会出现累积误差——每插一帧偏一点,几十帧之后就明显不对了。加入光流一致性约束或者长程时序建模,解决长视频的累积漂移问题,这是一个很有深度的研究点。
七、写在最后
视频插帧这个方向有点尴尬——不算最热门的顶会宠儿,但落地需求一直很旺盛。从手机慢动作模式到游戏高帧率输出,从老视频修复到影视后期,处处都用得上。
FrameFlow 给我的启发是:很多时候你不需要发明全新的范式,把现有的光流 + 扭曲 + 融合框架里的每个环节做扎实——时间条件化、遮挡感知、模糊自适应——效果自然就上来了。工程上把速度压下来、把参数量做小,比堆大模型更有落地价值。
做毕设的同学如果选这个方向,我建议先拿 RIFE 跑通 baseline,再针对性解决一个具体问题——比如运动模糊场景下的精度提升,或者长视频的时序一致性。问题越具体,工作越扎实。
大家如果有复现上的问题或者想聊具体的拓展思路,欢迎评论区交流。