

视频理解模型有个尴尬:看视频不慢,回答一个问题却很慢。原因在于大多数模型用自回归方式逐字生成答案,哪怕答案是“A”还是“B”,也要把整个token序列走一遍。
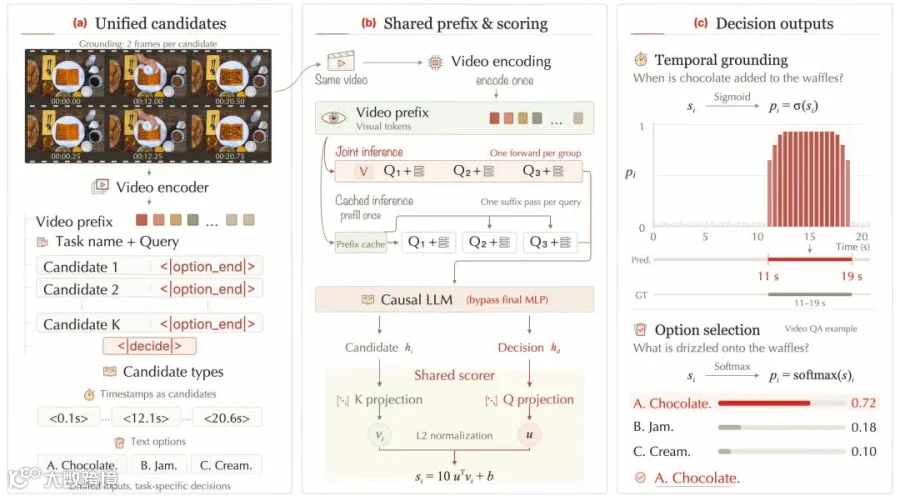
VideoJev换了个思路:不生成,直接打分。它把时间定位和选择题统一成一个候选打分接口。给定视频和若干候选(时间区间或选项),模型直接输出匹配分数。结果是QA速度比Thinking模式快100-129倍,精度也没掉。
视频里,VideoJev-4B(左)和Qwen3.5-4B(右)在同样的多标签页面任务上响应,前者明显更快。
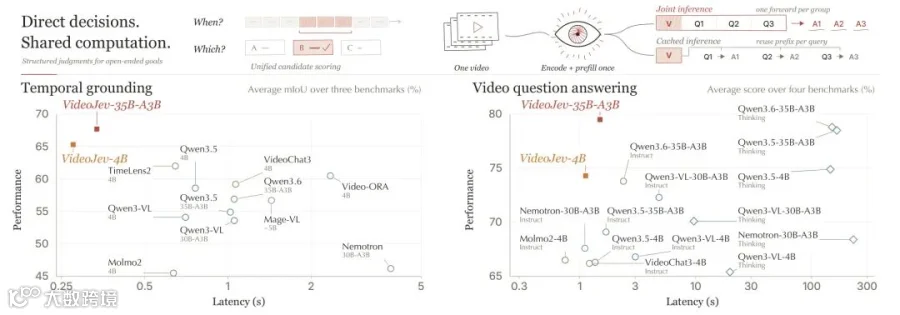
具体数据来自项目页:
-
在Charades、ActivityNet、QVHighlights三个时间定位基准上,VideoJev-4B和VideoJev-35B-A3B的平均mIoU比各自基座模型提升6.7和10.8个百分点。 -
在四个视频QA基准上,性能与Thinking模式的基座模型相当,但推理速度快100-129倍。 -
在H200上实测延迟:4B模型Joint模式下每问0.276秒,基座Qwen3.5-4B Instruct要0.763秒;35B-A3B Joint模式0.336秒,基座1.054秒。
方法不复杂:视频编码一次,多个候选并行打分。支持Joint(一组问题一次前向传播)和Cached(视频缓存复用,新问题一次前向)两种推理模式。多查询场景下收益明显:10个时间定位查询,VideoJev只要0.39秒,生成式基线要5.98秒。
模型已经开源:4B和35B-A3B权重在HuggingFace,代码在GitHub,10秒demo就能跑通。
当然也有隐患。论文承认置信度校准仍有问题,平均校准误差8-9个点,模型过于自信。有网友指出,当查询内容根本不在视频里时,解码器仍会强行选一个区间,比如你想找狗,视频里全是猫,它也会给个答案。对素材搜索场景,这是个缺失的“逃逸口”。
把“决策”从“生成”变成“打分”,这个方向不是孤例。一位做Remotion视频QA工具的开发者在评论里分享,他用类似思路的多模态决策模型替代LLM逐帧审查,把单条视频的QA成本从127美元降到16美分,时间减少四分之三。
VideoJev项目:
-
HuggingFace模型集合 (https://huggingface.co/collections/MCG-NJU/videojev) -
GitHub代码库 (https://github.com/MCG-NJU/VideoJev) -
论文 (https://arxiv.org/abs/2610.18615)