


目录 📑
-
0. 写给深度学习工程师的硬件入门
0.1 什么是 TPU 风格的加速器
0.2 什么是切片
0.3 全局架构图
0.4 执行流程图
0.5 运行状态机 -
1. 项目定位与目录结构 -
2. 数据流与存储层次 -
3. 切片内部
3.1 序列器 otpu_seq
3.2 TMEM
3.3 ACT RAM
3.4 MXU
3.5 VPU
3.6 Quantizer
3.7 DMA
3.8 集合通信 -
4. 互连与板级
4.1 otpu_native_dram
4.2 otpu_mem_ch
4.3 控制寄存器与 trace
4.4 板级 -
5. 技术单元与综合目标 -
6. 验证、模型与实验
6.1 仿真 testbench
6.2 实验性架构 -
7. 设计取舍总结
openTPU 是一套完整的 TPU 风格 加速器 RTL 与验证工程。它既包含可综合的切片、MXU、VPU、TMEM、DMA、量化器和集合通信单元,也包含板级 PCIe/DDR 适配、AXI-Lite 控制寄存器、技术无关存储单元,以及大量用于一致性验证的 testbench。本文按“架构—数据流—模块—板级—实验”的顺序,整理这份代码库的主要设计。
0. 写给深度学习工程师的硬件入门 🧑🏫
这一节先解释 TPU 风格加速器 和 切片,再给出 全局架构、执行流程 和 运行状态机。如果你有深度学习背景,但没有写过 RTL,这一节就是为你准备的。
0.1 什么是 TPU 风格的加速器 🧠
如果你训练过神经网络,你大概率用过 GPU。GPU 的特点是“通用并行”:它有几千个线程,每个线程可以做任意浮点运算,靠大量线程隐藏内存延迟。TPU(Tensor Processing Unit)是 Google 为神经网络专门设计的加速器,它的思路和 GPU 很不一样。
TPU 风格加速器的核心思路是:把神经网络的主要计算——矩阵乘——做成一个巨大的、固定的硬件数据通路,让数据像流水一样穿过它。
这个“巨大的固定数据通路”就是 systolic 阵列(脉动阵列)。你可以把它想象成一条流水线:权重和激活从两端进入,经过一连串的乘加单元,最后从另一端流出结果。因为数据通路是固定的,所以它不需要像 GPU 那样为每条指令取指、译码、调度,能效高得多。

-
• 权重流从左侧进入,激活流从上方进入,每个乘加单元只做一次乘加。 -
• 部分和沿阵列向右传递,形成“脉动”效果。 -
• 结果从右侧流出,进入下一个阶段。 -
• 权重和激活的复用次数决定了它们在片上的驻留时间。
理解 TPU 风格加速器的关键,是把“计算”和“搬运”分开看:计算单元负责算,DMA 负责搬,存储单元负责存。一个好的设计,就是让计算单元不饿着、搬运单元不闲着。
0.2 什么是切片 🧩
在 openTPU 中,切片(Slice,otpu_slice.sv)是独立执行一个程序的最小计算单元。它不是一个单纯的算术单元,而是一个完整的小型处理器。
一个切片 = 一个序列器 + 一个 DMA + 一个 MXU + 一个量化器 + 一个 VPU + 一个 TMEM + 一个 ACT RAM。
你可以把切片类比成一个“小 CPU”:
每个切片具备以下特征:
-
• 独立的指令流:切片内部有 otpu_seq,从 IMEM 取指、译码、分发,不需要外部每个周期干预。 -
• 独立的本地存储:TMEM 是 fp32 scratchpad,ACT RAM 存放 MXU 的 stationary operand,IMEM 存放程序。 -
• 独立的 DRAM 端口:切片通过 otpu_native_dram访问两个 DDR 通道,地址空间由切片自己管理。 -
• 独立的运行状态: halted、error、wait_to、icount都是每切片一份,多切片时由顶层合并。 -
• 可与其他切片协作:通过 otpu_coll参与 BAR 和 GATHER,实现跨切片同步与数据广播。
在
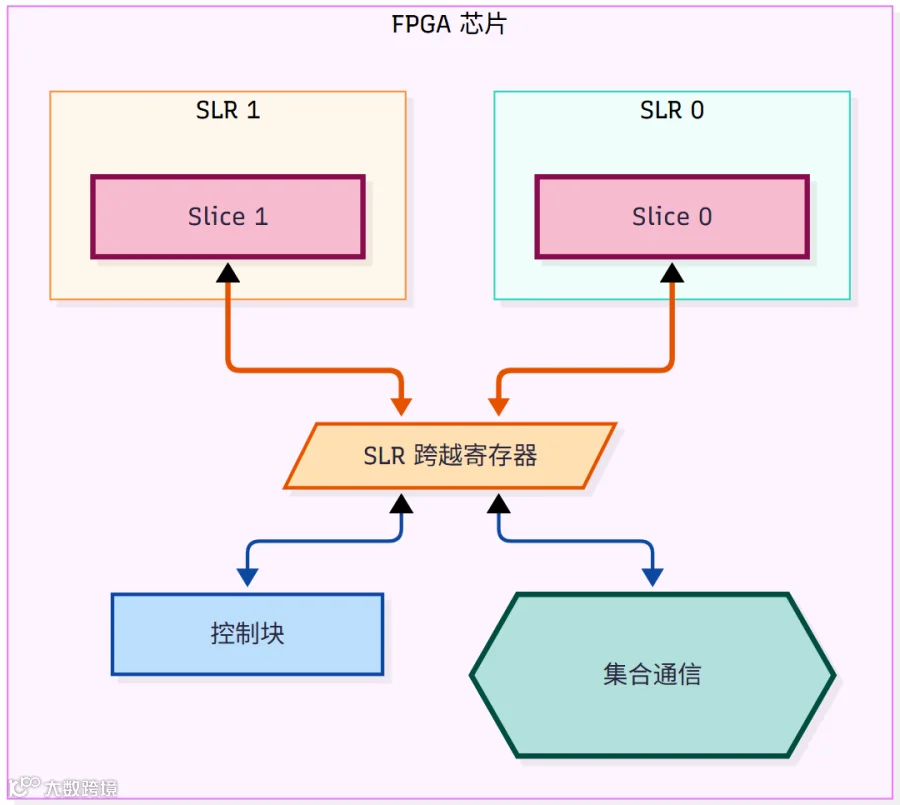
otpu_board中,S 个切片各自占据一个 SLR(UltraScale+ 的 Super Logic Region,可以理解成 FPGA 内部的一块物理区域),通过 SLR 跨越寄存器与其他切片、控制块和集合通信单元相连。S = 1 时,切片直接与控制块和集合通信单元相连。
-
• 每个切片占据一个 SLR,切片之间通过 SLR 跨越寄存器通信。 -
• 控制块和集合通信单元也是跨 SLR 的资源。 -
• SLR 跨越寄存器把长路径切成多段短路径,保证时序收敛。 -
• S = 1 时只有一个切片,不需要跨 SLR。
切片与“单元”(Unit)的关系:
所以“切片”是并行粒度,“单元”是执行粒度。一个切片内有多个单元并发运行,多个切片通过集合通信单元协同。理解了切片,才能理解 openTPU 如何把多个小处理器拼成一个可扩展的平台。
0.3 全局架构图 🗺️
-
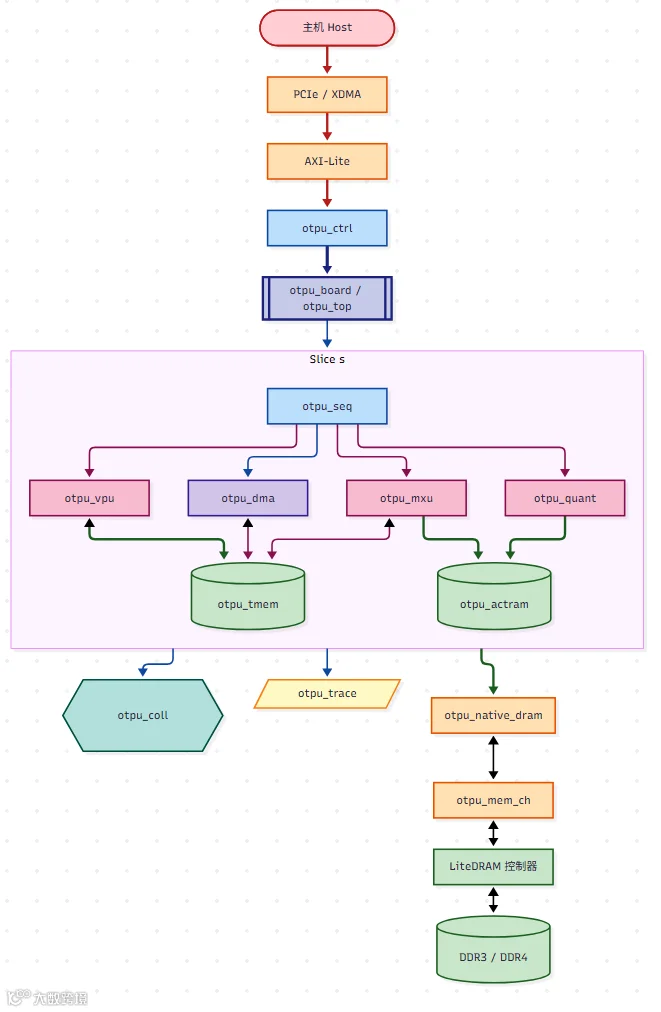
• 主机通过 PCIe 与 AXI-Lite 访问控制寄存器。 -
• 控制寄存器负责 RUN、LOAD、ARG0..7、STATUS、TRACE 寄存器。 -
• 顶层封装内部可以有一个或多个切片。 -
• 每个切片包含序列器、DMA、MXU、VPU、量化器、TMEM、ACT RAM。 -
• 集合通信单元负责多切片之间的 BAR 与 GATHER。 -
• trace 模块收集性能事件,供主机读取。 -
• 切片通过 native DRAM 适配器、通道桥、LiteDRAM 控制器访问 DDR。
这张图是全局视角:主机、控制寄存器、切片、集合通信、trace、DRAM 五个部分。切片是图中最大的子图,也是本文后续章节的重点。读这张图时,可以想象数据从主机流入,经过控制寄存器启动切片,切片内部计算,结果回到主机。
0.4 执行流程图 🚀

-
• 主机先写 PROG_ADDR 和 PROG_N,再写 CTRL.LOAD。 -
• 序列器从 DRAM 读取程序块并写入 IMEM(指令内存)。 -
• 主机写 CTRL.RUN,切片离开复位,开始取指。 -
• 序列器每周期取指、译码、分发;不同单元可以并发执行。 -
• DMA 负责 DRAM 与 TMEM 之间的搬运。 -
• MXU 从 DRAM 读权重,从 ACT RAM 读激活,结果写回 TMEM。 -
• VPU 从 TMEM 读写,执行向量和复合函数。 -
• 量化器从 TMEM 读,写 ACT RAM 或 DRAM。 -
• 程序执行 HALT 后,序列器报告 halted。 -
• 主机读取 STATUS、ICOUNT、TRACE 等寄存器。
这张图是时间视角:从主机写寄存器,到程序加载、执行、halt,再到主机读状态,完整走了一遍。alt 分支对应切片内部的五种单元路径。读这张图时,可以想象自己在主机上运行一个推理脚本:先加载程序,再启动,然后等结果。
0.5 运行状态机 🧭
-
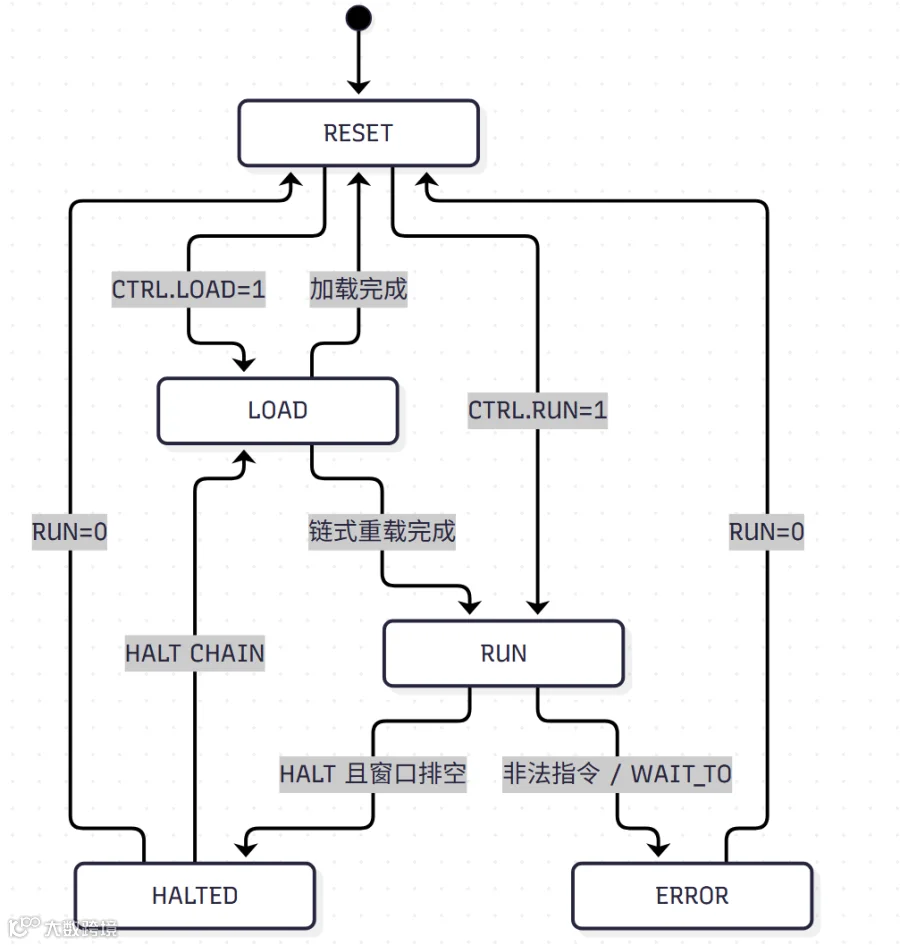
• RESET 是初始状态,切片不执行任何指令,所有单元处于复位。 -
• LOAD 由 CTRL.LOAD 触发,把程序从 DRAM 加载到 IMEM;加载完成后回到 RESET。 -
• RUN 由 CTRL.RUN 触发,序列器开始取指和执行;这是切片的正常工作状态。 -
• HALTED 表示程序执行完毕,序列器窗口已排空,所有指令已提交。 -
• ERROR 表示非法指令或 WAITW 超时;切片停止,直到 RUN=0。 -
• HALT CHAIN 允许在 HALTED 后重新加载并继续运行,TMEM 和 DRAM 保持原状。 -
• RUN=0 可以从 HALTED 或 ERROR 回到 RESET,准备下一次运行。
这五个状态覆盖了切片从复位到运行的完整生命周期。HALT CHAIN 是 openTPU 的一个特色:它让一次运行可以分多段加载程序,而不必清空 TMEM 和 DRAM。这对于长程序、多阶段推理非常有用。
1. 项目定位与目录结构 📦
代码库可以分成五层:
-
1. ISA 与包定义: rtl/top/otpu_pkg.sv定义操作码、VOP 功能、cmd_t、内存 footprint、性能事件结构。 -
2. 切片内部: otpu_slice.sv把序列器、DMA、MXU、量化器、VPU、TMEM、ACT RAM 组织成可并发执行的单元。 -
3. 顶层与板级: otpu_top.sv是仿真顶层;otpu_board.sv是板级封装;otpu_mem_ch.sv、otpu_native_dram.sv负责 native DRAM 协议与 AXI/PCIe 的桥接。 -
4. 技术单元: rtl/tech/generic、xilinx7、xilinxus、asic提供 RAM 与 DSP 的多种实现。 -
5. 验证与实验: sim/verilator、rtl/exp、boards/*/sim包含随机 traffic、对照模型、形式化检查 stub 和实验性架构。

-
• otpu_pkg 是全局定义,被所有模块引用。 -
• otpu_top 和 otpu_board 是两种顶层,前者用于仿真,后者用于板级。 -
• otpu_slice 是核心计算单元,内部包含多个子模块。 -
• rtl/tech 提供多目标技术映射。 -
• sim/verilator 和 rtl/exp 分别用于验证和探索。 -
• 六边形节点代表实验性模块。
目录结构按“定义—切片—顶层—技术—验证”五层组织。读代码时,建议先看 otpu_pkg 和 otpu_slice,再看 otpu_board 和 otpu_mem_ch。这样能先理解数据结构和执行模型,再看具体的硬件实现。
2. 数据流与存储层次 📊
openTPU 的核心是 权重流 + 激活驻留 的 TPU 风格数据流。
权重流 + 激活驻留:这是 openTPU 最根本的数据流策略,也是 TPU 风格加速器与 GPU 风格加速器最大的区别。权重(weight)是神经网络中每个矩阵乘的固定操作数,激活(activation)是随输入变化的操作数。在传统 GPU 上,两者都从显存流式读取,带宽压力巨大;在 TPU 风格的设计里,权重从 DRAM 流式进入计算阵列,用完即弃;激活则驻留在片上存储中,被多个权重块反复复用。之所以这样选,是因为矩阵乘中每个权重元素只参与一次乘加,而每个激活元素会被同一行的多个权重复用。把复用次数高的操作数放在片上,把复用次数低的操作用流式读入,就能大幅降低 DRAM 带宽需求。

-
• 权重从 DRAM 流式进入 MXU,每个元素只参与一次乘加。 -
• 激活一次性写入 ACT RAM,然后被多个权重 chunk 反复复用。 -
• MXU 的输出写回 TMEM,供 VPU 或下一层使用。 -
• 复用次数的差异决定了谁流式、谁驻留。
矩阵乘的整数部分:
其中 group 是 个元素,一个链的末端就是一个 group 的和。块缩放:
最后:
-
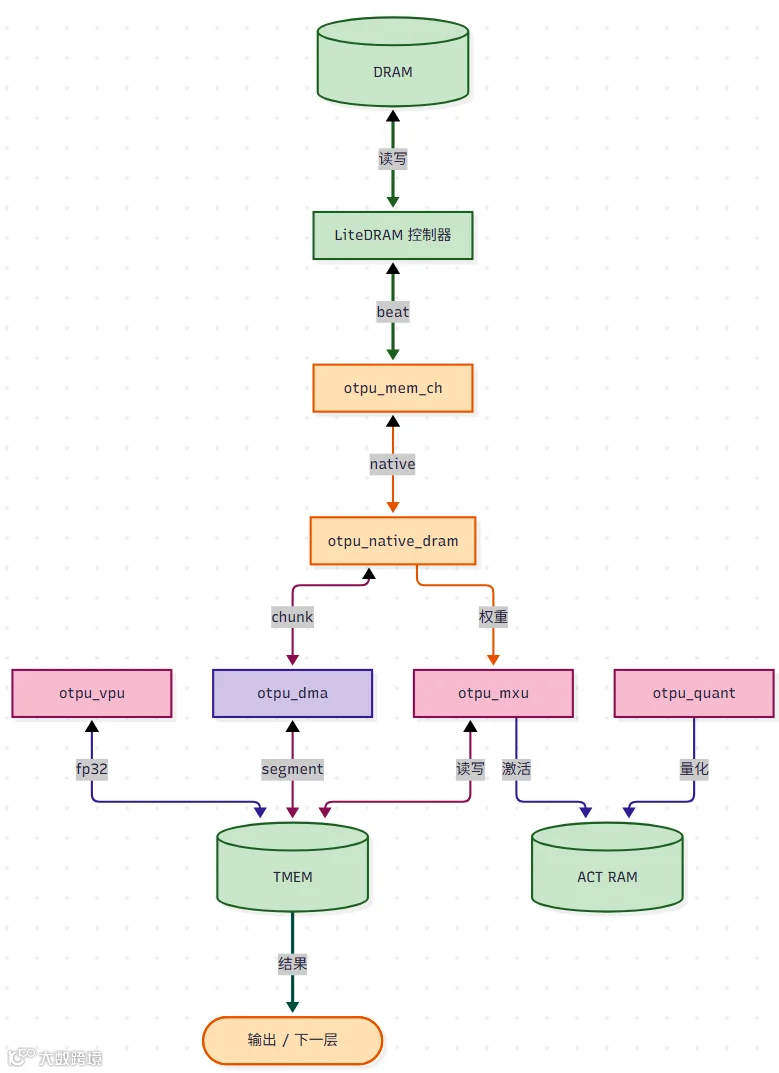
• DRAM 通过 LiteDRAM 控制器和通道桥连接到切片。 -
• native DRAM 适配器是切片侧的 native 适配器。 -
• DMA 负责在 DRAM 和 TMEM 之间搬运数据。 -
• MXU 从 DRAM 流式读取权重,从 ACT RAM 读取激活。 -
• 量化器把 TMEM 数据量化后写入 ACT RAM 或 DRAM。 -
• VPU 从 TMEM 读写,执行向量和复合函数。
数据流的核心是权重流 + 激活驻留:权重每个 chunk 只用一次,所以从 DRAM 流式进入;激活被多个权重 chunk 复用,所以驻留在 ACT RAM。这个策略的直接收益是 DRAM 带宽需求大幅下降,因为权重只读一次,激活只写回一次。
3. 切片内部 🔧
3.1 序列器 otpu_seq 🧠
序列器是切片的“大脑”。你可以把它类比成 CPU 的前端:取指、译码、分发。
序列器(Sequencer,
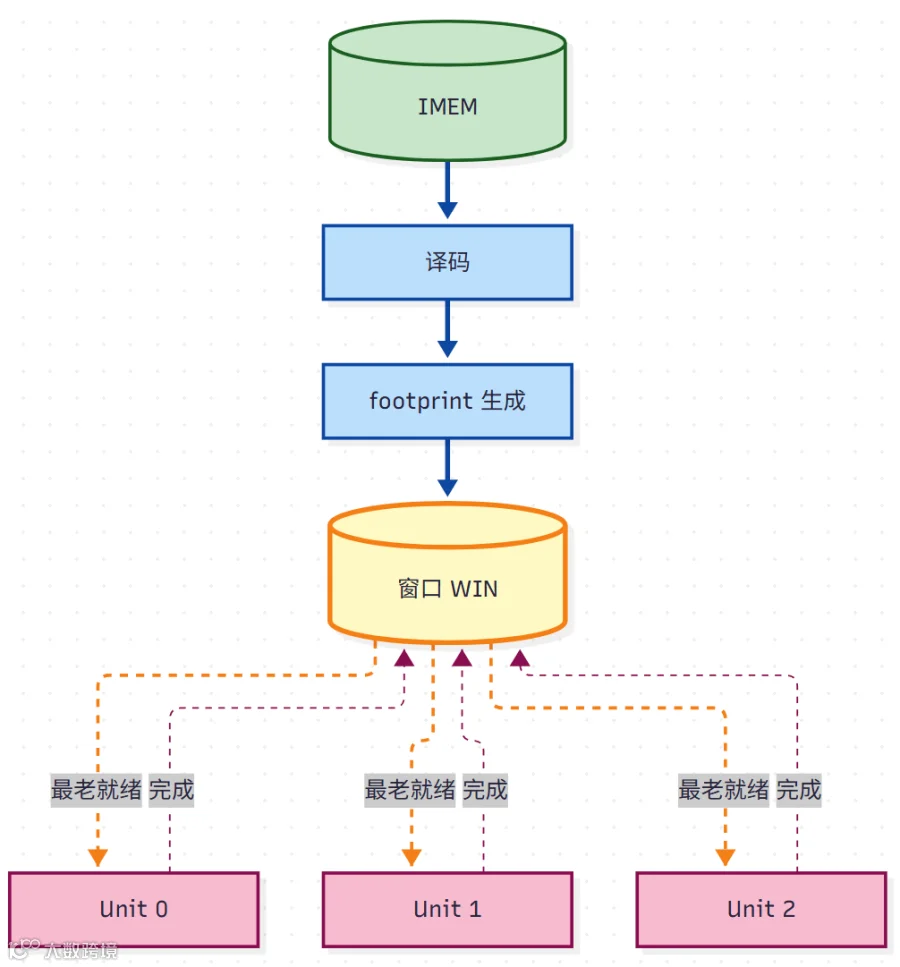
otpu_seq):切片的指挥中心。它每周期从 IMEM 取一条指令,译码后把指令和它的内存访问范围(footprint)一起放进一个窗口(window)。窗口中的指令按程序顺序排列,每个单元每周期从窗口中挑选最老的、依赖已满足的指令启动。序列器本身不做算术,它只负责“哪些指令可以并发、哪些必须串行”。这种设计让不同单元可以自由重叠,同时保证结果与顺序执行完全一致。
-
• 指令从 IMEM 取出,经过译码和 footprint 生成,进入窗口。 -
• 窗口按程序顺序保存指令,并记录指令之间的依赖关系。 -
• 每个单元从窗口中挑选最老的、依赖已满足的指令启动。 -
• 指令完成后,窗口释放对应槽位,供新指令使用。 -
• 窗口大小决定了最多有多少条指令可以同时在飞。
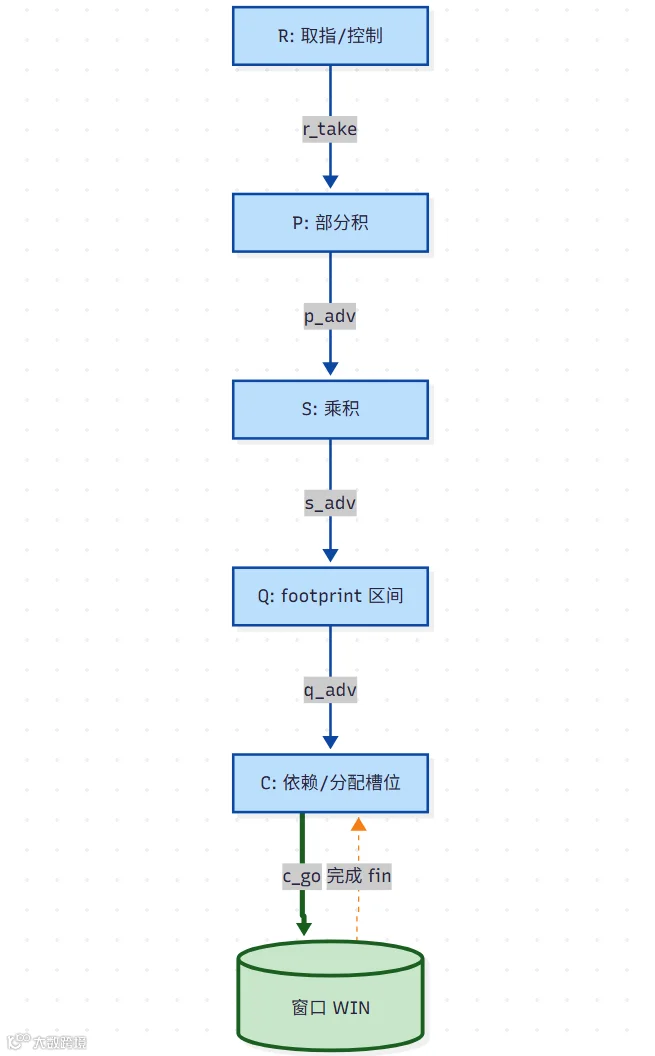
序列器每周期取指、译码、分发。NOP、LI、ADDI、LOOP 在本级执行;其余指令解析寄存器相对字段后进入窗口 WIN。每个槽位保存指令、footprint 和依赖关系。每个单元每周期启动其“最老的、依赖已满足”的指令,保证顺序语义,同时允许不同单元重叠。
footprint 被拆成:
-
• DRAM 两个区间; -
• TMEM 五个区间,其中 t0可写,t1..t4只读; -
• ACT 一个区间; -
• all表示 BAR 等全局冲突。
冲突检测:
-
• 取指级 R 解析控制指令,并把其他指令送入 P。 -
• P 计算部分积,S 计算乘积,Q 生成 footprint 区间。 -
• C 级检查依赖并分配槽位。 -
• 窗口中的指令完成后,释放依赖。 -
• 每个单元从窗口中选择最老的就绪指令启动。
序列器是切片的“大脑”:它不直接执行计算,而是把指令和依赖关系组织好,让各单元并发执行,同时保证顺序语义。WIN 窗口的大小决定了最多有多少条指令可以同时在飞,WIN=16 意味着最多 16 条指令处于“已分发、未完成”状态。你可以把它类比成 CPU 的乱序执行窗口。
时序图:序列器分发与启动

-
• 取指和译码每周期进行。 -
• P、S、Q、C 四级流水,每级可停顿。 -
• 窗口记录指令的依赖关系。 -
• 执行单元从窗口中选择最老的就绪指令。 -
• 完成后释放槽位,供新指令使用。
这条流水线的关键是 C 级依赖检查:它决定了哪些指令可以并发,哪些必须串行。footprint 越精确,并发度越高;footprint 越保守,正确性越稳。WIN=16 是面积和并发度的折中。
3.2 TMEM 💾
TMEM 是切片的 fp32 scratchpad。
TMEM(Tensor Memory,
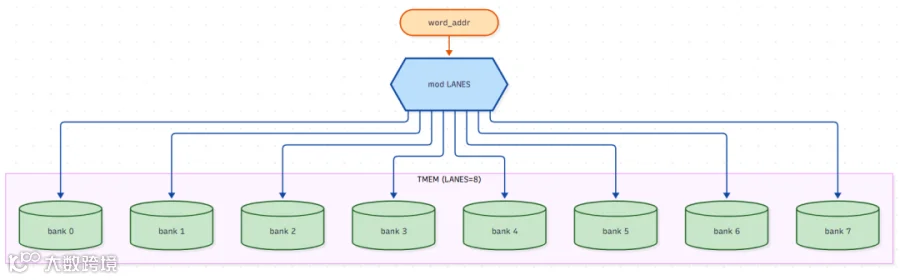
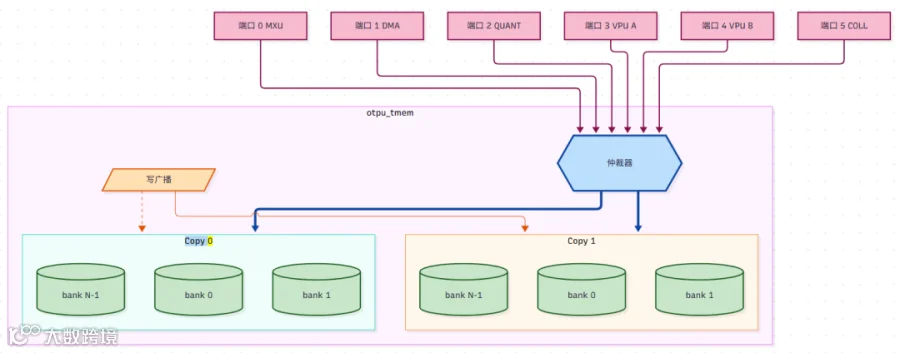
otpu_tmem):切片的 fp32 scratchpad,按LANES个 bank 组织。bank 是存储体的概念,把一块内存分成多个 bank,每个 bank 可以独立访问,就能在同一周期内并行读写多个 bank。TMEM 的每个读端口有自己的一份副本,因此读端口之间不竞争;写广播到所有副本。你可以把它类比成 GPU 里的 shared memory,但它的读端口更多、更宽。
-
• 一个 word 地址通过 mod LANES 映射到某个 bank。 -
• 每个 bank 是一个独立的存储体,可以独立读写。 -
• 同一个周期内,不同 bank 可以并行访问。 -
• 同一 bank 内的访问需要串行或仲裁。 -
• LANES 越大,并行度越高,但面积也越大。
地址到 bank:
仲裁按组进行:DMA、COLL、VPU、MXU、QUANT 全部或全不授予。配置包括:
-
• TMEM_IMPL=0:每读端口一份副本; -
• TMEM_IMPL=1:banked,多副本,适合 ASIC; -
• TMEM_IMPL=3:单副本,每 bank 多个子 bank RAM,支持RPL重放、TDP真双口、PMP2x 泵、GST访客。
-
• TMEM 有多个读端口和一个写广播。 -
• 每个读端口可以有自己的副本,读不冲突。 -
• 写操作广播到所有副本。 -
• 仲裁器决定每个周期哪些端口可以访问。 -
• 读先于写,同周期读返回旧值。
TMEM 的设计核心是读端口并行、写端口广播。FPGA 上每个读端口一份副本,ASIC 上则用 banked 或单副本 + 子 bank + 重放来降低面积。TMEM 是 VPU 和 MXU 之间的数据中转站,也是量化器和 DMA 的数据来源。
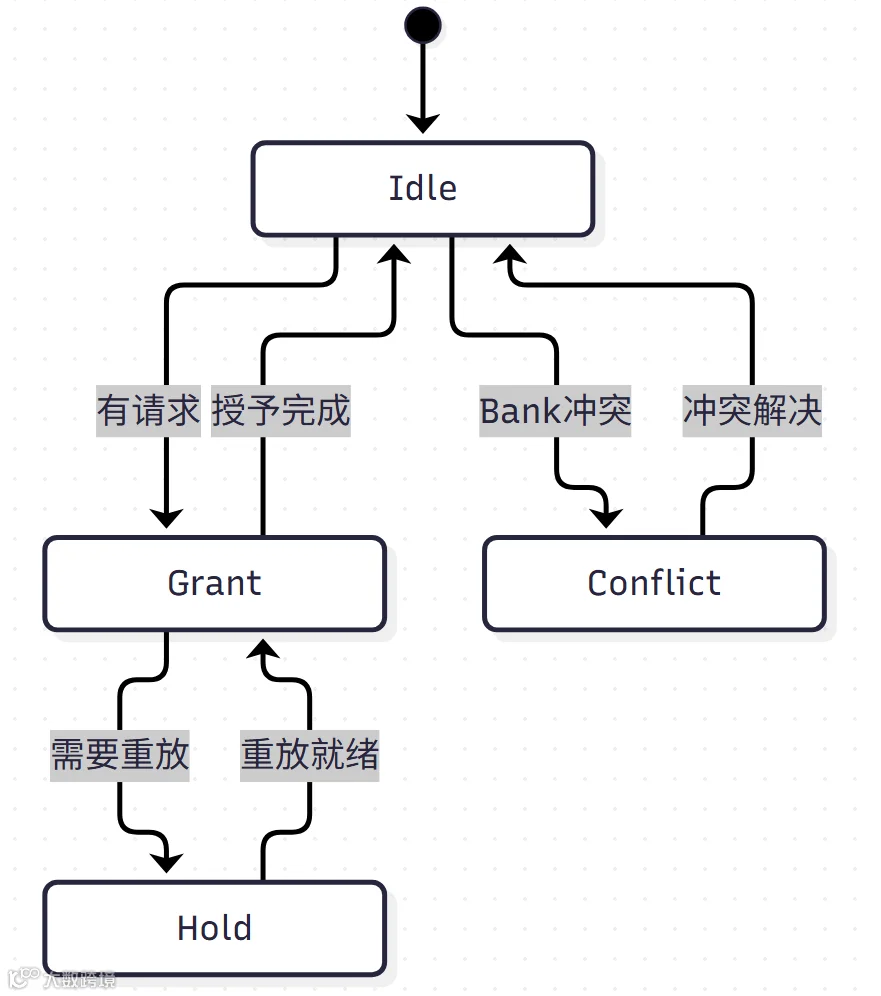
状态机图:TMEM 仲裁状态
-
• Idle 是空闲状态,等待请求。 -
• 有请求时进入 Grant,授予访问。 -
• 如果读丢失,进入 Hold,等待重放。 -
• 银行冲突时进入 Conflict,解决后返回空闲。 -
• 授予完成后回到 Idle。
这个状态机只在 TMEM_IMPL=3 且 RPL=1 时完整生效;其他配置下 Hold 和 Conflict 不会进入。重放机制的意义是:即使某个读因为子 bank 冲突丢失,也会在后续周期自动重试,而不是让单元永久停住。你可以把它类比成 CPU 的 cache miss 重试。
3.3 ACT RAM 🧱
ACT RAM 是 MXU 的 stationary operand 存储。
ACT RAM(Activation RAM,
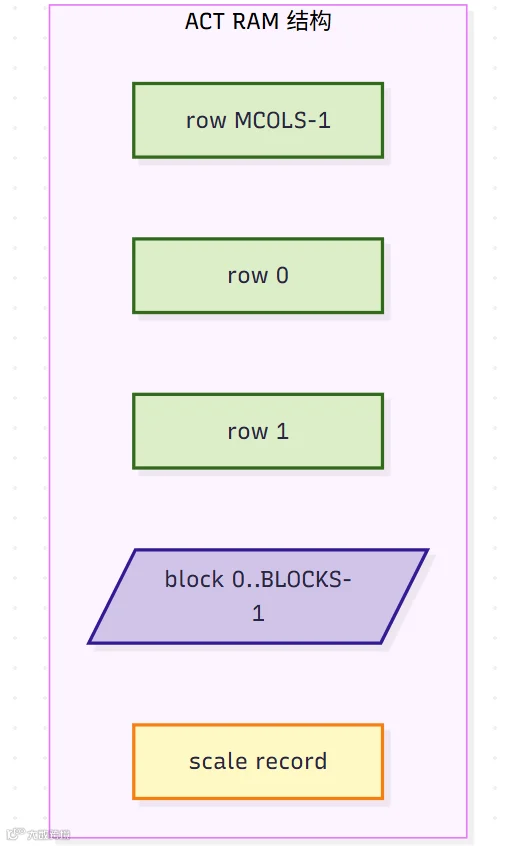
otpu_actram):存放 MXU 的 stationary operand,也就是驻留的激活。你可以把它类比成 GPU 里的寄存器文件或 weight buffer。它的布局是ROWS × BLOCKS × D的 int8,外加每个(row, block)的 64 位 scale 记录。量化器每周期写最多LANES个连续字节和一个 scale;MXU 每周期读一个 block 的MCOLS行。ROWS > MCOLS时,MXU 可以对同一个权重 chunk 做 replay,按 group 消费多个MCOLS行组。

-
• 量化器写入字节和 scale 记录。 -
• MXU 读取块数据,按列输出。 -
• 每个块对应一行数据,多个块组成一个 row。 -
• scale 记录包含四个子块偏移和行 scale。 -
• 支持 DUP 模式,同时写入两行。
ACT RAM 保存 MXU 的 stationary operand:ROWS × BLOCKS × D 的 int8,以及每个 (row, block) 的 64 位 scale 记录:

-
• 每个 row 包含多个 block,每个 block 有 D 个 int8。 -
• 每个 (row, block)对应一个 64 位 scale 记录。 -
• scale 记录包含四个子块偏移和行 scale。 -
• 行 scale 用于 MXU 的 epilogue,子块偏移用于块内缩放。
ACT RAM 是激活的驻留地:它不参与流式传输,而是被 MXU 反复读取。ROWS > MCOLS 时的 replay 机制让一个权重 chunk 可以服务多组激活行,这是降低权重 DRAM 读取次数的关键。量化器写入的 scale 记录让 MXU 可以在整数域做块缩放,避免浮点误差。
3.4 MXU ⚡
MXU 是切片里的矩阵乘单元,也是算力的主要来源。
MXU(Matrix Multiply Unit,
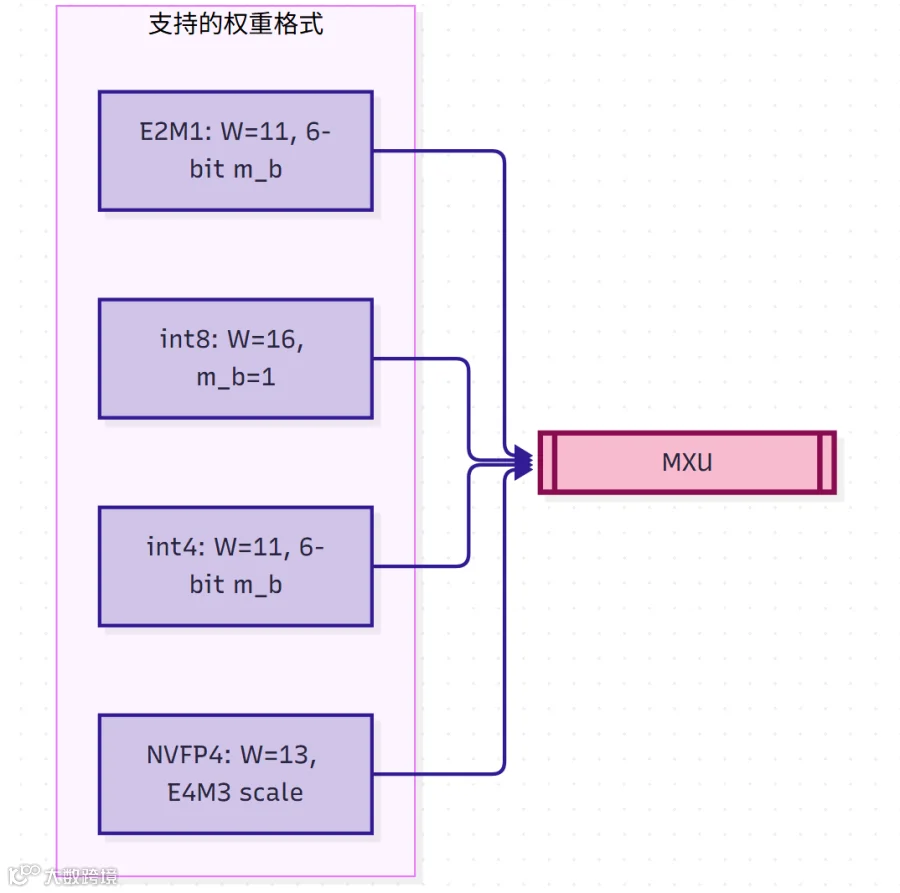
otpu_mxu):切片里的矩阵乘单元。你可以把它类比成 GPU 里的 Tensor Core。它从 DRAM 流式读取权重块,从 ACT RAM 读取激活行,在 systolic 阵列里做整数乘加,列末端把每组的和乘以块缩放因子,再累加到 48 位整数 accumulator,最后由 epilogue 转成 fp32 写回 TMEM。它支持 int8、int4、E2M1、NVFP4 等多种权重格式。
-
• int8 用 16 位窗口和 1 位 m_b,精度最高。 -
• int4 和 E2M1 用 11 位窗口和 6 位 m_b。 -
• NVFP4 用 13 位窗口和 E4M3 scale。 -
• 不同格式通过 flags 选择,硬件数据通路共用。
MXU 是 systolic 阵列。每个 chain 有 CLS = min(CL, D/8) 个 product,每个 product 一个 DSP(数字信号处理单元,可以理解成 FPGA 里专门做乘加的硬核)。每个 group 由 CPG 个 chain 组成,最多 2 个。列末端 otpu_mxce 把 8 个 group 的和乘以 B = m << sh,沿 cascade 求和,再由第 9 个 DSP 累加到 48 位 accumulator。
支持模式:
-
• PAIR:一个 chunk 低半给前 M列,高半给后M列; -
• RSC:scale row 只有 S_w; -
• UNIT: S_w=1, dw=0, m=1。
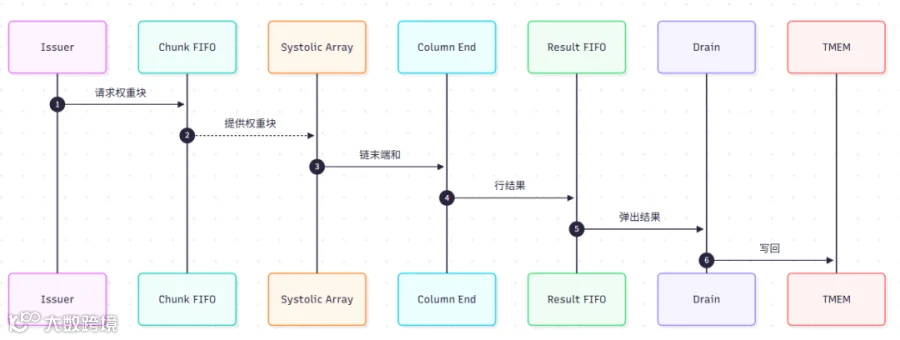
-
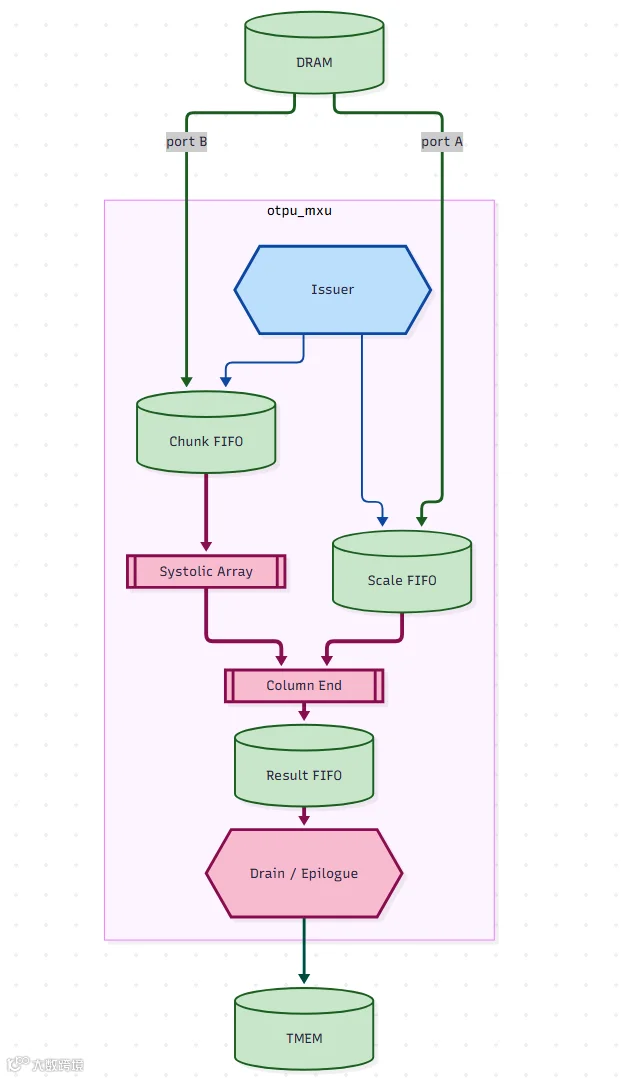
• Issuer 从 DRAM 请求权重块和 scale。 -
• Chunk FIFO 缓存权重块,Scale FIFO 缓存 scale。 -
• Systolic Array 计算点积,Column End 进行块缩放和累加。 -
• Result FIFO 缓存结果行,Drain 进行 epilogue 并写回 TMEM。 -
• 支持 PAIR、RSC、UNIT 等模式。
MXU 的数值路径是 整数链 → 块缩放 → 48 位累加 → fp32 epilogue。整数链保证精确,块缩放和 epilogue 提供灵活的量化格式。PAIR 模式让一个 chunk 同时服务两组列,RSC 模式省去权重块数据只留 scale,UNIT 模式用于调试。DEPTH 决定一个权重行能缓冲多少 chunk。
时序图:MXU 流水
-
• Issuer 提前请求权重和 scale。 -
• 权重块进入 systolic 阵列,逐周期计算。 -
• 列末端完成块缩放和累加。 -
• 结果行进入 FIFO,由 Drain 按顺序处理。 -
• Drain 执行 i2f、乘 scale、写回 TMEM。
这条流水线的关键是预取:Issuer 提前把权重和 scale 放进 FIFO,使 systolic 阵列不会因为 DRAM 延迟而停顿。ROWS > MCOLS 的 replay 要求一行能装进 FIFO,所以 DEPTH 通常要大于等于一个权重行的 chunk 数。
3.5 VPU 🎛️
VPU 是切片里的向量单元。
VPU(Vector Processing Unit,
otpu_vpu):切片里的向量单元,每周期处理LANES个 fp32 元素。fp32 是 32 位浮点数,就是深度学习里常用的 float32。你可以把它类比成 GPU 里的 CUDA Core 阵列。它负责 elementwise(加减乘、最大最小)、reduction(行和、行最大、行平方和、点积、argmax)、OUTER(外积衰减)和复合函数(EXP2、RECIP、RSQRT、LOG2)。复合函数是位精确的固定 fp_add/fp_mul 序列,与opentpu/fp32.py逐位一致。

-
• Elementwise 处理逐元素运算,如加减乘、最大最小。 -
• Reduction 处理归约,如行和、行最大、行平方和、点积、argmax。 -
• OUTER 处理外积衰减,用于注意力机制。 -
• Composite 处理复合函数,如 exp、recip、rsqrt、log。 -
• 每类操作有不同的流水线和延迟。
fp32 加法四阶段:
-
1. unpack + compare; -
2. align + add; -
3. normalize; -
4. round。
乘法两阶段:
-
1. 乘积与特殊值判断; -
2. 规格化与舍入。
复合函数由固定序列组成,例如:
recip 使用两次 Newton 迭代:
rsqrt 使用:
log2 先做范围缩减:
再对 做 Horner。
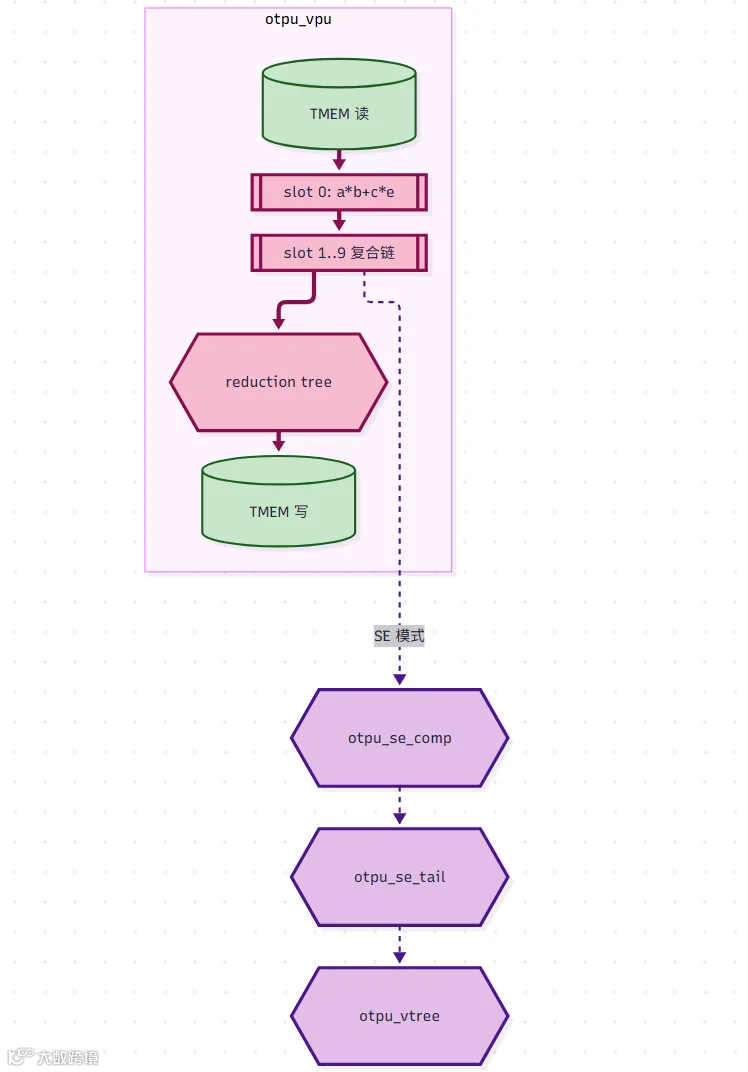
-
• VPU 从 TMEM 读取操作数。 -
• slot 0 执行乘加,slot 1..9 执行复合函数链。 -
• reduction tree 处理行和、行最大值等。 -
• 结果写回 TMEM。 -
• SE 模式下,复合函数由 otpu_se_comp 微码执行。
VPU 的复合函数是位精确的:每个函数都由固定的 fp_add/fp_mul 序列组成,与 opentpu/fp32.py 逐位一致。这意味着硬件和软件模型可以互相验证,不会出现“看起来差不多”的误差。归约会跑在专门的折叠树上,且同一时间只能有一个归约在飞。
状态机图:VPU 指令状态

-
• Idle 是空闲状态,等待指令。 -
• 启动后进入 Issue,根据函数类型分支。 -
• Elementwise 处理简单函数,Composite 处理复合函数,Reduction 处理归约。 -
• 完成后返回 Idle。
VPU 的状态机比较浅:它不区分具体函数,只区分执行路径。复合函数和归约的细节由各自的微码和流水线处理。这种分层让 VPU 的控制逻辑保持简单,而把复杂性放在数据通路上。
3.6 Quantizer 📏
量化器负责把 fp32 转成低精度格式。
量化器(Quantizer,
otpu_quant):把 fp32 数据转成 int8/int4 等低精度格式的单元。你可以把它类比成 PyTorch 的quantize_per_tensor,但它是硬件流水线化的。它每行处理两遍:第一遍求最大值和 scale,第二遍按 scale 量化。输出可以写回 ACT RAM(给 MXU 用)或 DRAM(给下一层用)。
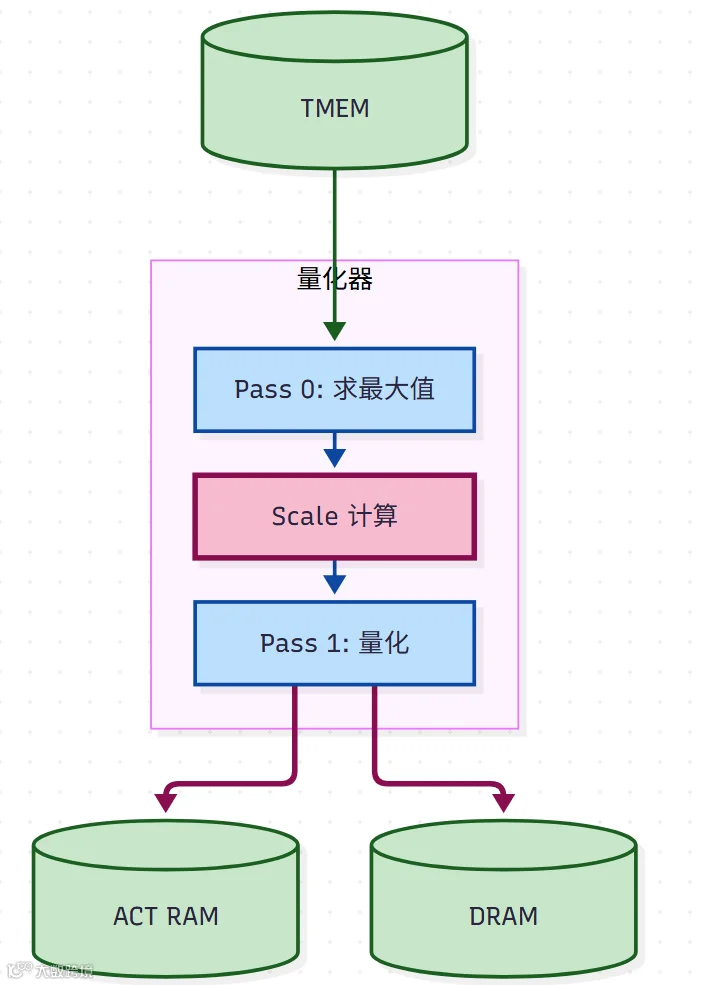
-
• 第一遍从 TMEM 读取数据,求最大值和 group 最大值。 -
• Scale 计算单元计算行 scale 和逆。 -
• 第二遍按 scale 量化,输出到 ACT RAM 或 DRAM。 -
• QACT 模式写 ACT RAM,QST 模式写 DRAM。 -
• 两遍结构保证量化精度。
量化器支持:
-
• QACT:TMEM 行 -> ACT RAM; -
• QST:TMEM 行 -> DRAM 字节。
每行两遍。第一遍求 amax、行 scale 和 group max;第二遍按 group offset 量化。
QACT 可选 XD row buffer,把第一遍的 prescale 结果缓存,使第二遍不必重读 TMEM。

-
• 第一遍读取 TMEM,进行预缩放和求最大值。 -
• Scale Unit 计算行 scale 和逆。 -
• 第二遍读取 group 最大值,量化并写入 ACT RAM 或 DRAM。 -
• XD row buffer 缓存第一遍结果,减少 TMEM 读。 -
• 支持 QACT 和 QST 两种模式。
量化器的两遍结构是为了精确:第一遍确定 scale,第二遍用量化后的 scale 量化。XD buffer 让第二遍不必重读 TMEM,提升吞吐。QST 的标量写走 DRAM 的 SW 端口,与 MXU 的 scale 读分开,互不阻塞。
3.7 DMA 🚚
DMA 负责在 DRAM 和 TMEM 之间搬运数据。
DMA(Direct Memory Access,
otpu_dma):直接内存访问单元。它负责在 DRAM 和 TMEM 之间搬运数据,让计算单元不用直接面对 DRAM 的高延迟。你可以把它类比成 CPU 里的 DMA 控制器。openTPU 的 DMA 支持三种模式:LD/ST(块传输)、WAITW(条件等待)、DSTEP/STREAM(流式处理)。

-
• LD 把 DRAM 数据搬到 TMEM,用于加载权重或激活。 -
• ST 把 TMEM 数据搬到 DRAM,用于写回结果。 -
• WAITW 等待主机写入某个字,用于同步。 -
• DSTEP/STREAM 把整个 fp32 矩阵按行流过 SE,用于 DeltaNet 等流式算子。
DMA 负责 LD/ST、DSTEP/STREAM、WAITW。LD 把 DRAM chunk 预取到 buffer,再按 segment 写 TMEM;ST 从 TMEM 读 segment,聚合成 chunk 后写 DRAM。DSTEP/STREAM 把整个 fp32 矩阵按行流过 SE。
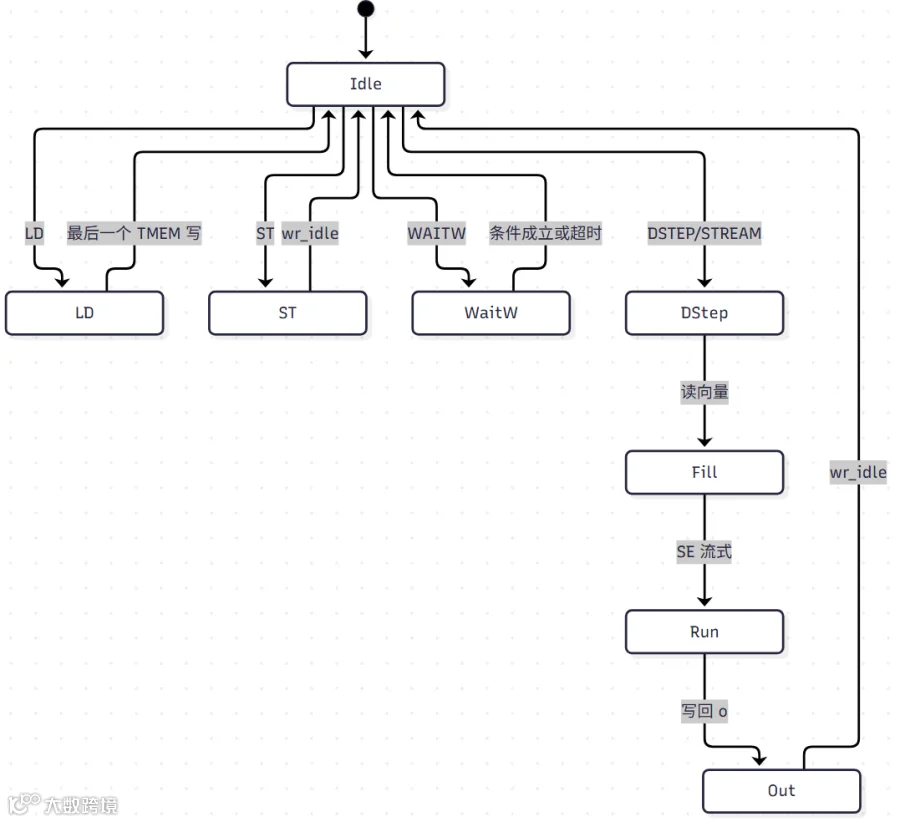
-
• Idle 是空闲状态,等待指令。 -
• LD 预取 DRAM 块,写 TMEM。 -
• ST 读 TMEM,聚合成块,写 DRAM。 -
• WaitW 等待条件成立或超时。 -
• DSTEP/STREAM 先填充向量,再流式运行,最后写回。
DMA 的状态机比 VPU 复杂,因为它要处理三种不同的传输模式:LD/ST 的块传输、WAITW 的条件等待、DSTEP/STREAM 的流式处理。WAITW 是主机与加速器之间的同步点,a_inval 会让 native DRAM 适配器丢弃 port A 的旧 beat。
时序图:DMA LD 传输

-
• DMA 向 DRAM 请求 chunk。 -
• DRAM 返回数据,存入 chunk buffer。 -
• DMA 按 segment 写入 TMEM。 -
• 重复直到所有 chunk 传输完成。
LD 的关键是预取:DMA 提前请求多个 chunk,使 TMEM 写不会因为 DRAM 延迟而停顿。DEPTH 决定能预取多少 chunk,W 决定每个 segment 有多少 word。这种预取策略和 CPU 的硬件预取器类似。
3.8 集合通信 🤝
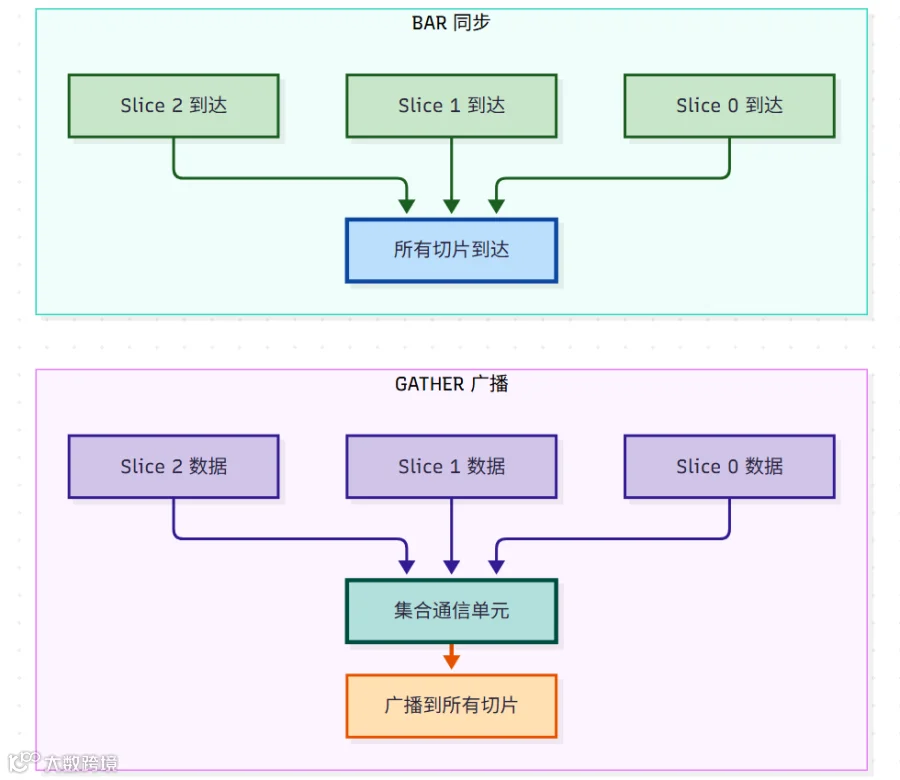
otpu_coll 支持 BAR 与 GATHER。当所有切片请求同一集合操作时,GATHER 逐切片流式读取 segment,广播到每个切片的 TMEM。gnt 是所有切片 TMEM grant 的 AND。S > 1 时使用 otpu_coll_hub 与 otpu_coll_port 跨 SLR。
BAR(Barrier):一种同步操作,所有切片都到达 BAR 后才继续执行。GATHER:一种集合通信操作,把每个切片的数据收集起来,广播到所有切片。你可以把 BAR 类比成 MPI 的
Barrier,把 GATHER 类比成AllGather,只不过它是在硬件里实现的。
-
• BAR 同步:所有切片都到达后,才一起继续。 -
• GATHER 广播:每个切片的数据收集到集合通信单元,再广播到所有切片。 -
• BAR 用于同步,GATHER 用于数据交换。 -
• 跨 SLR 时使用 hub 和 port 进行寄存器隔离。

-
• 每个切片有一个集合通信端口。 -
• 多个切片通过 hub 连接到集合通信单元。 -
• GATHER 逐切片读取数据,广播到所有切片。 -
• BAR 仅同步,不传输数据。 -
• 跨 SLR 时使用 hub 和 port 进行寄存器隔离。
集合通信是多切片协同的关键:BAR 同步,GATHER 广播。gnt 是所有切片 grant 的 AND,保证所有切片同时准备好。COLL_GATHER=0 时,只保留 BAR,GATHER 会设置 error。
4. 互连与板级 🌐
4.1 otpu_native_dram 🔌
这是切片 DRAM 端口到两个 DDR 通道 native 端口的适配器。一个命令对应一个 64 字节 beat。地址映射把逻辑 beat 交织到两个通道:
CHASH 会按 chunk index 奇偶交换 chunk 两半,使跨步访问均匀落到两个通道。

-
• 一个 128 字节 chunk 被分成两个 64 字节半块。 -
• 低半块通常去 channel 0,高半块去 channel 1。 -
• CHASH 会按 chunk index 奇偶交换两半,平衡两个通道的负载。 -
• 每个通道以 64 字节 beat 为单位传输。
它包含:
-
• A 队列:MXU scale 读; -
• SW 队列:QST 标量写,按 beat 合并; -
• B 队列:DMA/MXU 的 chunk 读写; -
• APF 预取:A 读一次取多个连续 beat; -
• partial write:按 byte mask 写,必要时先读后写; -
• wr_idle/rd_idle:写全部进入控制器、读全部返回。

-
• 切片请求分为 A、SW、B 三个队列。 -
• 仲裁器按优先级选择命令。 -
• 命令按 beat 的 bank parity 分发到两个通道。 -
• 支持预取和 partial write。
otpu_native_dram是切片与 DRAM 之间的适配层:它把切片的 32 位字地址映射到两个通道的 64 字节 beat,并处理 partial write 和预取。SW 队列独立于 A 和 B,让 QST 的标量写不会阻塞 MXU 的 scale 读。
4.2 otpu_mem_ch 🌉
每个 DDR 通道的桥。它把 accelerator native master 与 XDMA AXI master 汇合到该通道的两个 native 端口。
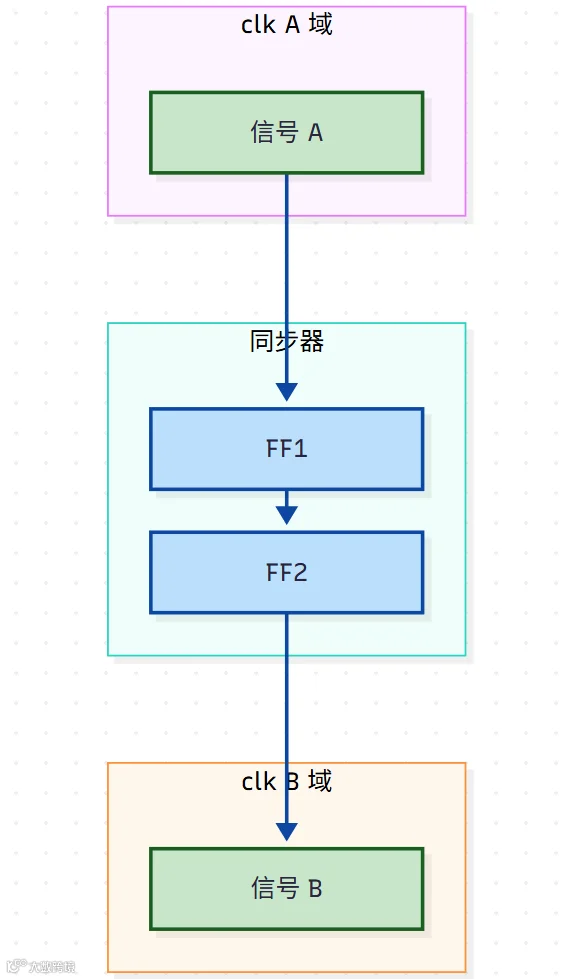
CDC(Clock Domain Crossing):跨时钟域。芯片里不同模块可能跑在不同时钟下,信号从一个时钟域传到另一个时钟域需要特殊处理(同步器、异步 FIFO),否则会出亚稳态。AXI 是 ARM 定义的总线协议,AXI-Lite 用于寄存器读写,AXI 用于高性能数据传输。PCIe 是主机和加速器之间的高速串行总线,XDMA 是 Xilinx 的 PCIe DMA IP。
-
• 信号从 clk A 域进入 clk B 域需要同步器。 -
• 两级触发器可以避免亚稳态传播。 -
• 多位信号需要 gray 码或握手协议。 -
• 大批量数据需要异步 FIFO。
otpu_mem_ch 包含:
-
• 异步 FIFO 跨时钟; -
• 仲裁器,每 master 最多连续 RUN 个命令; -
• 两个端口按 bank parity 分流; -
• 读 tag FIFO,保证每 master 读数据按命令顺序; -
• partial beat 的 read-modify-write; -
• n_wdone跨时钟 gray 码同步; -
• n_err检查控制器是否破坏端口契约。

-
• accelerator 和 XDMA 的命令通过异步 FIFO 跨时钟。 -
• 仲裁器轮流服务两个 master。 -
• 命令按 bank parity 分发到两个端口。 -
• 读 tag FIFO 保证读数据顺序。 -
• partial write 在桥内做 RMW。
otpu_mem_ch是两个 master 共享一个 DDR 通道的桥:它负责仲裁、跨时钟、partial write 和读数据顺序。XT 和 XB 参数让 XDMA 的写突发成批进入,减少对 accelerator 的干扰。n_err 是端口契约的检查位,任何一方破坏契约都会置位,主机通过 STATUS 读到。
时序图:AXI-Lite 写控制寄存器

-
• 主机发出写地址和写数据。 -
• 隔离单元转发到控制寄存器。 -
• 控制寄存器返回写响应。 -
• 隔离单元把响应返回主机。
otpu_axil_iso的作用是隔离主机和控制寄存器的复位域:主机复位时,控制寄存器的响应被丢弃;控制寄存器复位时,主机得到 SLVERR。这样两边可以独立复位,不会互相卡死。你可以把它类比成网络协议里的“超时重传”。
4.3 控制寄存器与 trace 📡
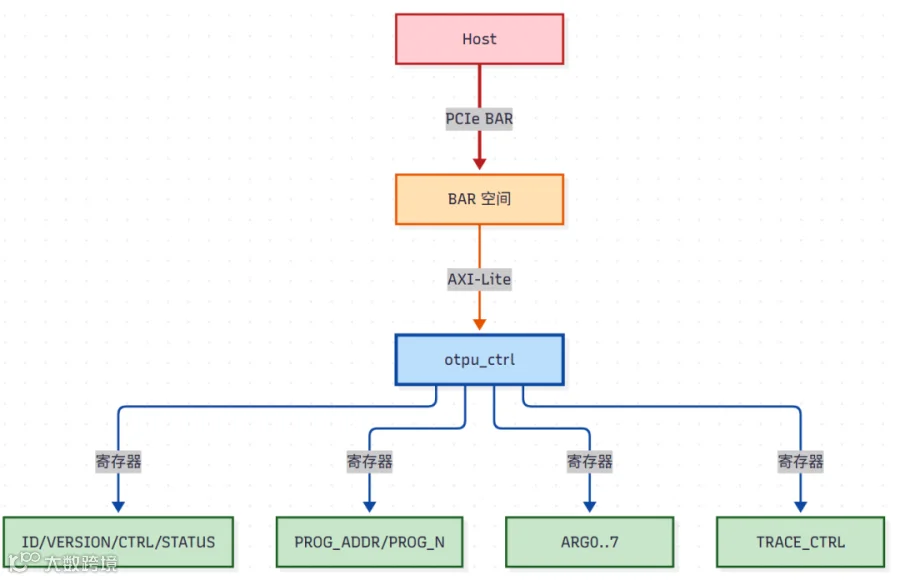
otpu_ctrl 是 AXI-Lite 从端,提供:
-
• ID、VERSION、CTRL、STATUS; -
• PROG_ADDR、PROG_N、CYCLES、ICOUNT; -
• CAPS、CAPS2、CFG_*; -
• ARG0..7; -
• 自由运行计数器; -
• TRACE_CTRL、TRACE_ADDR、TRACE_LO/HI; -
• I2C_CTRL、I2C_IN。
BAR(Base Address Register):PCIe 设备的基地址寄存器。主机通过 BAR 访问加速器的寄存器空间。AXI-Lite 是 ARM 定义的轻量级总线协议,用于寄存器读写。你可以把 BAR + AXI-Lite 类比成“主机的 MMIO 窗口”。
-
• 主机通过 PCIe BAR 访问加速器的寄存器空间。 -
• BAR 空间内部通过 AXI-Lite 连接到控制寄存器。 -
• 控制寄存器提供 ID、VERSION、CTRL、STATUS 等。 -
• PROG_ADDR 和 PROG_N 用于程序加载。 -
• ARG0..7 用于传递运行参数。 -
• TRACE_CTRL 用于控制硬件 trace。
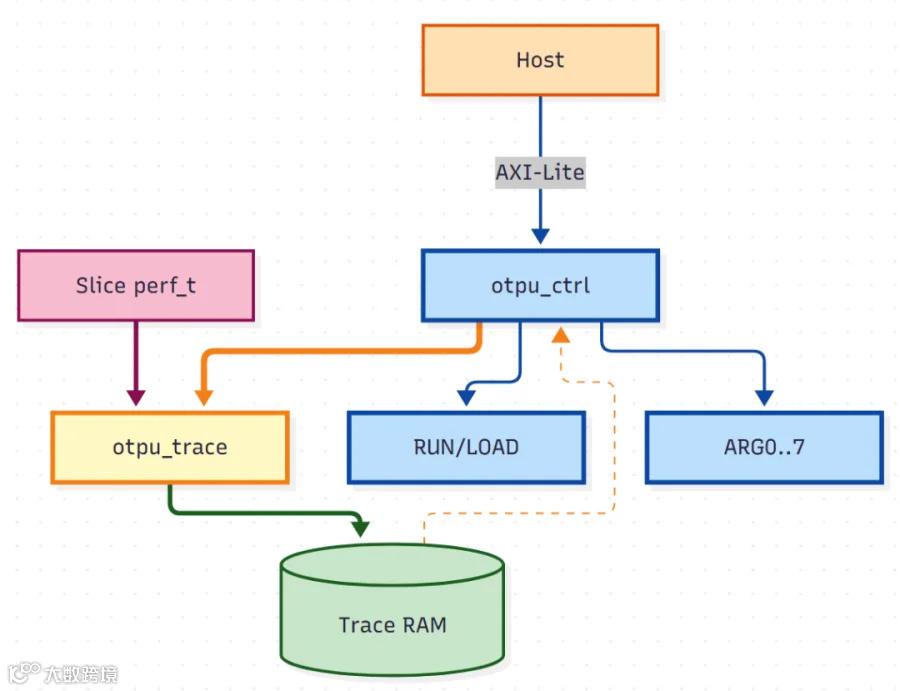
otpu_trace 把 perf_t 事件打包成 64 位记录,存入 block RAM ring,主机可通过寄存器读出。记录类型包括 G、E、S、D、O、U、V、H、P、Q、R。
-
• 主机通过 AXI-Lite 访问控制寄存器。 -
• 控制寄存器驱动 RUN、LOAD 和参数。 -
• trace 模块收集切片性能事件。 -
• 事件写入 trace RAM,主机可读。 -
• 自由运行计数器用于统计。
控制寄存器是主机与加速器之间的契约:寄存器映射版本、CAPS、CFG_* 都定义在 otpu_ctrl.sv 的注释里,主机驱动按这个契约实现。CAPS 和 CAPS2 让主机知道当前 bitstream 支持哪些功能。trace 则让主机能看到切片内部的性能事件,而不只是最终结果。
4.4 板级 🖥️
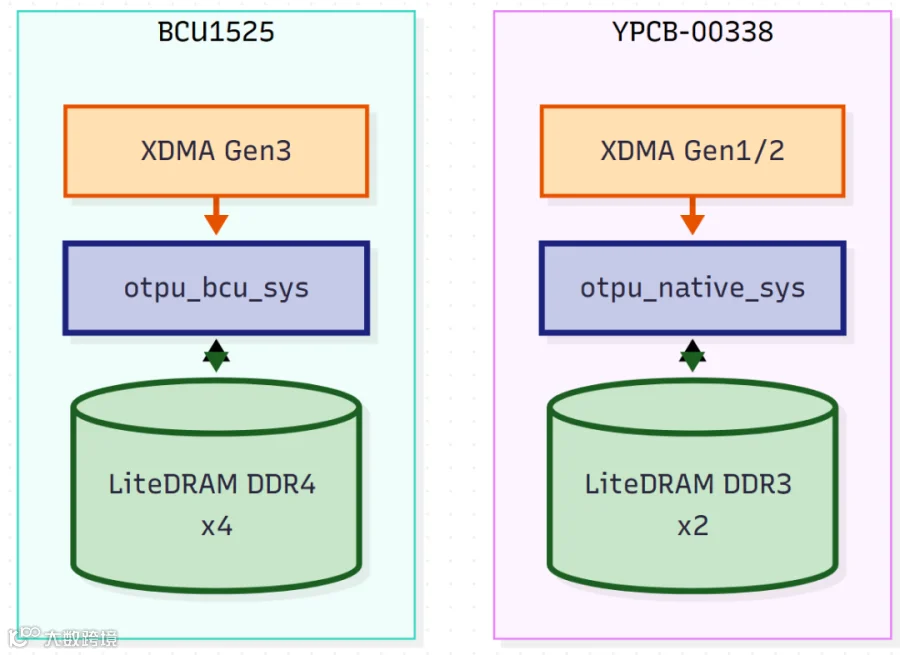
YPCB-00338 使用 LiteDRAM + DDR3,XDMA PCIe Gen1/Gen2。BCU1525 使用四个 DDR4 RDIMM,每 DIMM 一个 LiteDRAM DDR4 核,XDMA Gen3。otpu_native_sys 与 otpu_bcu_sys 把 otpu_board 和 XDMA 的 DMA master 接到各通道的 otpu_mem_ch。
DDR(Double Data Rate):双倍数据速率内存,DDR3、DDR4 是不同代的内存标准。LiteDRAM 是一个开源的 DRAM 控制器,openTPU 用它连接 DDR 内存。RDIMM 是带寄存器的 DIMM,通常用于服务器。
-
• YPCB 使用两个 DDR3 通道,PCIe Gen1/2。 -
• BCU1525 使用四个 DDR4 通道,PCIe Gen3。 -
• otpu_native_sys 和 otpu_bcu_sys 是板级适配层。 -
• 每个通道有独立的 otpu_mem_ch 桥。
两张板子的差异主要在 DDR 代数和通道数:YPCB 两个 DDR3 通道,BCU1525 四个 DDR4 RDIMM。otpu_board 的 S 参数决定切片数,每个切片占两个通道。BCU1525 的 S = 2,每个切片一个通道在本 SLR,另一个跨 SLR,所以需要 otpu_native_reg 做寄存器切片。
5. 技术单元与综合目标 🏗️
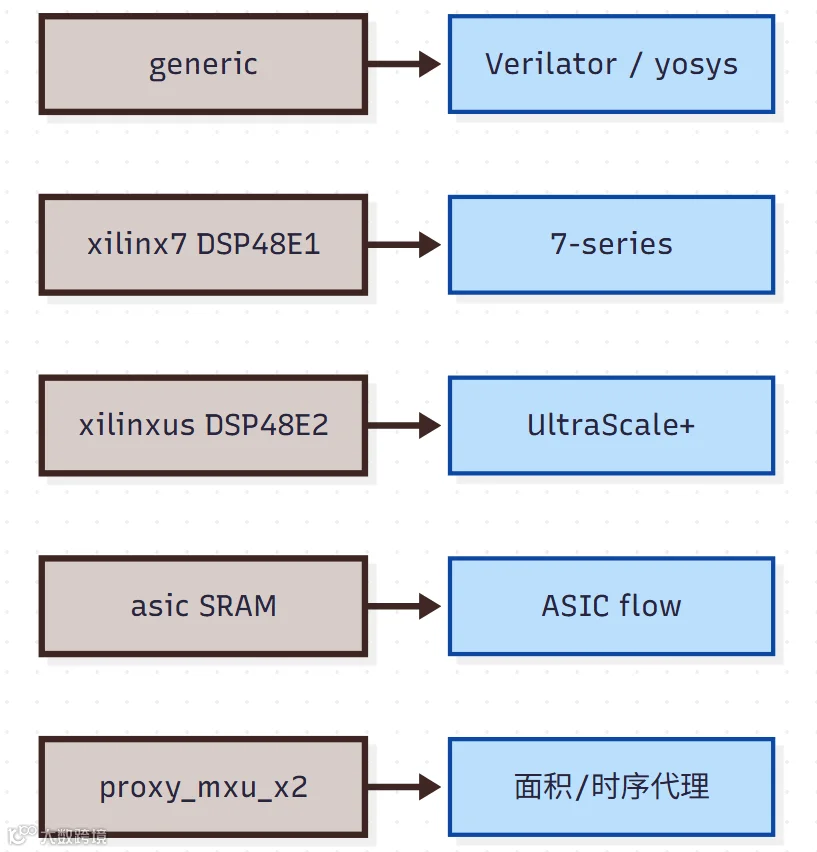
rtl/tech 提供多目标:
-
• generic:行为级 RAM 与 DSP 模型,供 Verilator、yosys、FPGA 推断; -
• xilinx7:DSP48E1; -
• xilinxus:DSP48E2; -
• asic:SRAM macro 平铺,otpu_ram_tiled、otpu_ram_tiled_dp; -
• tools/synth/proxy_mxu_x2.sv:4-bit MXU 双倍数据通路的成本代理。
技术 RAM 语义统一:同步读、带 enable、读先于写。ASIC 1R1W 宏的同地址读写未定义,因此用户不能依赖;1RW1R 双口宏在两个端口都读先于写,TMEM IMPL 3 TDP 的重放依赖这一点。
-
• generic 用于仿真和 FPGA 推断。 -
• xilinx7 和 xilinxus 分别对应 7 系列和 UltraScale+。 -
• ASIC 使用 SRAM 宏平铺。 -
• proxy_mxu_x2 用于面积和时序评估。 -
• 所有技术单元用六边形表示。
技术单元的核心是同一套接口,多种实现:上层 RTL 不关心底层是 block RAM、DSP 还是 SRAM macro,只通过 rtl/tech 的模块名调用。tools/asic/fakeram.py 为 NanGate45 生成 SRAM 宏模型,tests/test_tech_ram.py 对比 generic 和 asic 的轨迹。你可以把它类比成软件里的“抽象接口 + 多实现”。
6. 验证、模型与实验 🧪
6.1 仿真 testbench 🧬
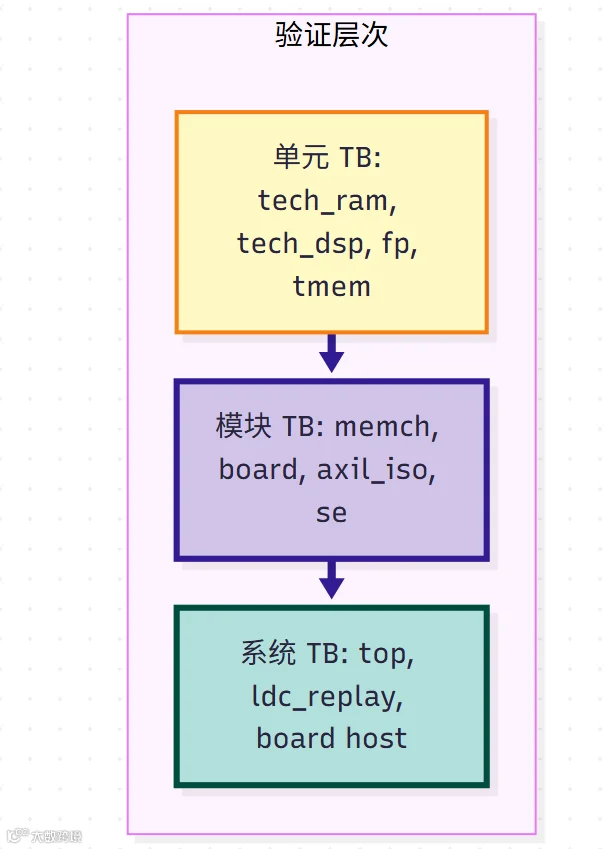
-
• tb_tech_ram.sv:随机 traffic 对比 generic 与 asic 的 RAM 轨迹。 -
• tb_tech_dsp.sv:随机激励对比 generic 与 vendor DSP。 -
• tb_board.sv:板级仿真,AXI-Lite host 脚本,DRAM 镜像 dump。 -
• tb_axil_iso.sv:AXI-Lite 隔离单元随机复位测试。 -
• tb_memch.sv:otpu_mem_ch、otpu_dma_split、otpu_afifo的多时钟随机测试。 -
• tb_se_comp.sv、tb_se_vpu.sv:SE 复合函数与 VPU 流引擎。 -
• tb_fp.sv:otpu_fp与opentpu/fp32.py向量对比。 -
• tb_tmem.sv:TMEM 随机 traffic 与参考模型。 -
• tb_ldc_replay.sv、tb_ldc_replay2.sv:LiteDRAM 控制器回放。 -
• tb_top.sv:整机运行、halt、dump。
-
• 单元级 testbench 验证基础模块。 -
• 模块级 testbench 验证复杂模块。 -
• 系统级 testbench 验证整机行为。 -
• 层次化验证覆盖从单元到系统。
验证策略是层次化 + 对照:单元级对比行为模型,模块级随机 traffic,系统级跑完整程序并对比 dump。tb_board.sv 还支持 host 脚本和 I2C 引脚模拟,能覆盖板级交互。这种策略和软件测试里的“单元测试 + 集成测试 + 端到端测试”是一个道理。
6.2 实验性架构 🔬
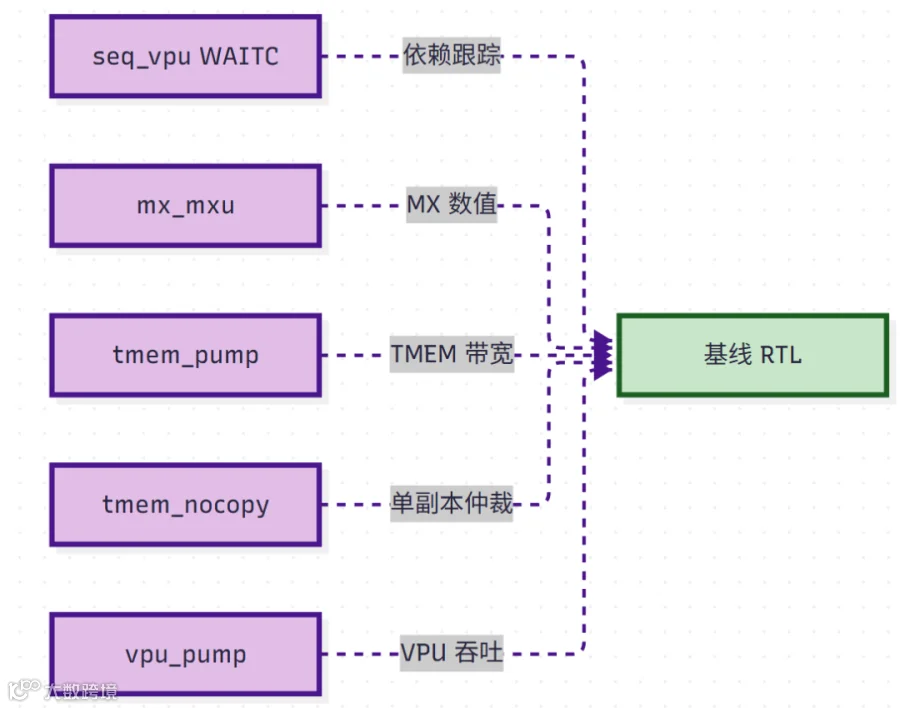
rtl/exp 下有多条探索线:
-
• seq_vpu/abl/otpu_seq.sv:WAITC 等待计数、窗口/队列消融、危险检查统计。 -
• mx_mxu:MX MXU,7-series 泵 DSP48E1 或 UltraScale+ 打包 DSP48E2,支持 W4X/W8X、PAIR、共享 epilogue lane。 -
• tmem_pump:TMEM 的 block RAM 2x/3x/4x 泵,otpu_tmem_pump、otpu_pumpk_bank。 -
• tmem_nocopy:单副本 TMEM 的仲裁模型,otpu_tmem_model、tmem_nc_top。 -
• vpu_pump:VPU 乘加单元 2x 泵,vp_pair_pump、vp_fmma_split。
-
• seq_vpu 探索等待计数和依赖跟踪。 -
• mx_mxu 探索 MX 数值格式和 DSP 打包。 -
• tmem_pump 探索 TMEM 带宽提升。 -
• tmem_nocopy 探索单副本仲裁。 -
• vpu_pump 探索 VPU 吞吐提升。 -
• 所有实验模块与基线对比。
实验线的共同目标是在不改变 ISA 的前提下提升性能或降低成本。每条线都对应一个具体的瓶颈:依赖跟踪、MX 数值、TMEM 带宽、单副本仲裁、VPU 吞吐。docs/seq_vpu.md、docs/mx_mxu.md、docs/tmem_pump.md、docs/tmem_nocopy.md、docs/vpu_pump.md 记录了每条线的动机、实验结果和取舍。
7. 设计取舍总结 🎯
openTPU 的代码体现出几条清晰取舍:
-
1. 精确整数累加 + fp32 epilogue:MXU 内部用整数链和 48 位 accumulator,避免浮点累加误差;输出再做 i2f、乘 scale,保证可复现。 -
2. TMEM 多副本 vs 单副本:FPGA 用多副本避免读端口竞争;ASIC 用 banked 或单副本 + 子 bank + 重放,降低面积。 -
3. native DRAM 协议:一个命令一个 64 字节 beat,省去 AXI 事务开销;partial write 由 otpu_mem_ch 做 RMW。 -
4. CDC 与 SLR 跨越:otpu_afifo、otpu_native_reg、otpu_xr 把跨时钟、跨 SLR 的信号都做成 flip-flop 到 flip-flop。 -
5. 可观测性:perf_t、otpu_trace、AXI-Lite 计数器、host 脚本,使仿真与板级行为可对照。 -
6. 多目标:generic/xilinx7/xilinxus/asic 四套技术单元,配合 targets/*.toml,让同一套 RTL 覆盖仿真、FPGA、ASIC。
整体上,这份代码库不是单一加速器,而是一个“可配置、可验证、可移植”的 TPU 风格平台:从 ISA 和 scoreboard,到 MXU/VPU/TMEM 的微架构,再到 PCIe/DDR 板级与实验性 NoCopy/Pump 方案,形成了完整的闭环。理解它的最好方式,是先抓住切片这个核心概念,再沿序列器 → 单元 → 存储 → 板级的顺序逐层展开。对于有深度学习背景的读者,可以把切片想象成一个“专门为矩阵乘优化的小 CPU”,把 MXU 想象成 Tensor Core,把 TMEM 想象成 shared memory,把 ACT RAM 想象成寄存器文件。这样,硬件设计的很多决策就会变得直观起来。🚀