

PINN与强化学习的交叉,正成为破解传统RL样本效率低、策略违背物理规律痛点的前沿方向,在流体控制、动力学优化、智能电网调度等场景接连跑出SOTA结果。
本文从近年顶会顶刊中整理了10篇两者结合的最新前沿论文,正在做相关课题的伙伴可以直接下方领取论文及代码(部分包含),搭基线、找改进点、扩实验方向都能直接用上。
长按识别下方二维码,回复【物理强化】
无偿领全部论文合集及项目代码

PINN-DT: Optimizing Energy Consumption in Smart Buildings Using Hybrid Physics-Informed Neural Networks and Digital Twin Framework with Blockchain Security
融合物理信息神经网络、数字孪生与区块链安全的智慧建筑能耗优化框架
文章内容
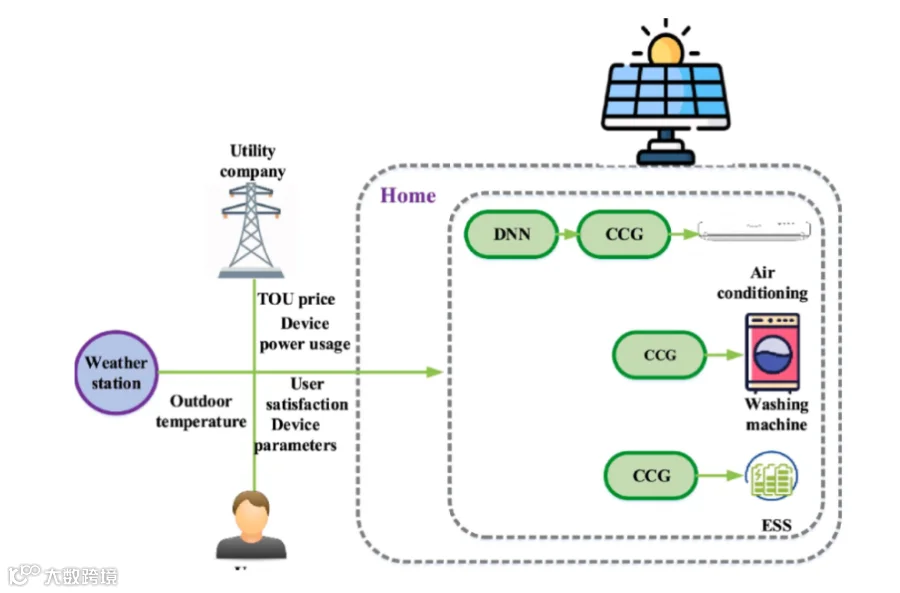
针对智慧电网与建筑能耗优化中传统模型精度不足、数据传输安全存在隐患的问题,该文融合三类技术搭建一体化方案:用数字孪生采集IoT侧的能耗、新能源出力、动态电价、用户偏好数据,训练深度强化学习代理实现实时能耗调度;将物理定律嵌入PINN保障模型精度与可解释性;引入区块链技术实现电网全链路的安全透明通信。实验验证该框架预测R²达0.978,能耗成本降低35%,用户舒适度维持96%,新能源利用率提升至40%,全面优于LSTM、XGBoost等传统基线模型。
Optimizing Energy Management of Smart Grid using Reinforcement Learning aided by Surrogate models built using Physics-informed Neural Networks
基于物理信息神经网络代理模型辅助强化学习的智慧电网能量管理优化
文章内容
针对强化学习求解电网最优潮流问题时,需反复调用高成本物理仿真器、样本效率极低的痛点,该文提出用PINN构建的代理模型替代原仿真环境,支撑RL策略训练。不同于纯数据驱动代理模型易出现分布外泛化差的问题,PINN将电网物理方程直接嵌入损失函数,可在不依赖真实仿真采样的前提下学习到可靠的环境状态转移规律。对比实验显示,该方法可将RL训练速度提升50%,仅用原环境一半的训练时长就能达到与原始仿真器相当的策略性能,为大规模智能电网的RL落地提供了高效训练路径。

Continuous-Time Value Iteration for Multi-Agent Reinforcement Learning
面向多智能体强化学习的连续时间值迭代方法
文章内容
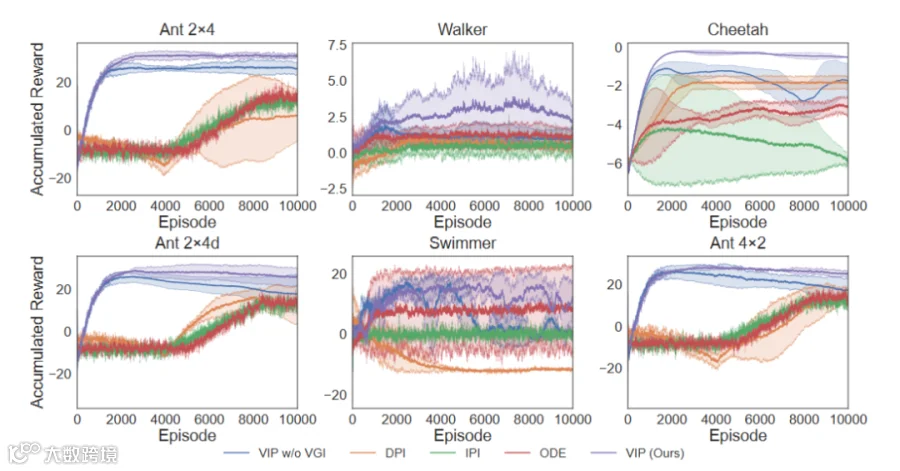
针对传统离散时间RL难以适配高频决策、非均匀时间间隔场景,且现有连续时间RL方法受维度灾难、多智能体集中值函数估计不准等问题限制的痛点,该文提出CT-MARL框架:利用PINN近似高维哈密顿-雅可比-贝尔曼(HJB)方程的解,规避传统求解方法的维度灾难;配套设计值梯度迭代模块,沿智能体轨迹动态精炼值函数的梯度估计,提升梯度保真度。在连续版本的MPE、多智能体MuJoCo基准上验证,该方法性能稳定超过现有连续时间RL基线,可顺畅扩展至复杂多智能体连续动力学场景。
↓↓听说在下方一键三连的都Accept了🌝


