


AI 观察 · 教育现场
AI 进课堂的边界
可以帮老师,不能替学生
CHAPTER 44 · 教育篇
2026 年 3 月,布朗大学的一门经济学课上发生了一件事。教授 Roberto Serrano 在这所学校教了 34 年,这门高等本科数理经济学课通常只有不到 30 人报名,这学期因为改了考核方式,86 个人选了课。
期中是「带回家、闭卷」——常春藤的一种传统,因为给了几乎无限的时间,题目可以出得更难。成绩出来好得反常:平均分 96 分,40 人满分。批卷的人提醒他,有些答案里有「不寻常的段落,与把题目跑过 ChatGPT 后得到的结果吻合」。
教授没有作废期中,只宣布期末改为线下考。结果——平均分掉到 48 分;89 名参加期中的人里只有 59 人参加期末,27 名缺考者中 22 人期中是满分。
「作弊的实证证据是压倒性的。」 —— 布朗大学经济学教授 Roberto Serrano
几乎同一时期,英国斯塔福德郡大学发生了另一件事。41 名学生在读一个政府资助的编程模块,却发现课程材料大部分是 AI 生成的——幻灯片由讲师自己声音的 AI 版本朗读。一名学生在课堂上当面质问讲师,这段话被录了下来:
「如果我们交 AI 生成的东西会被开除,但我们却在被 AI 教。」
一个是 AI 替学生做题,一个是 AI 替老师上课。两种用法,都出事了。
所以这篇文章要回答的只有一个问题:AI 进课堂,到底该帮谁?
CHAPTER 01
两个案例,指向同一个问题
布朗大学那件事,最值得注意的不是「有人作弊」——作弊不是新问题。值得注意的是一组对照数字:期中平均 96 分、40 人满分;期末改线下考,平均分 48 分;27 名缺考者中 22 人期中满分。
这说明的不是「学生变懒了」,而是这道作业本身已经失去了区分度——它测不出学生会不会,只测得出谁用了 AI。教授本人也承认这一点:他决定下学年不再有带回家的考试。
「如果我不再捍卫真相、体面和诚实,我们作为学者还有什么可信度?」
斯塔福德郡那件事,问题出在另一个方向。学生不是不愿意用 AI,而是不愿意被 AI 教。一名学生说:「我不想被 GPT 教。」另一名的评价更准确:
「大概 5% 是有价值的干货,其余大量是重复。这锅底是有点金子的,但这些金子我们自己问 ChatGPT 也能挖出来。」
还有一名学生最后说了一句:「我感觉我的一部分人生被偷走了。」
两个案例方向相反——一个是学生用 AI 逃避学习,一个是老师用 AI 逃避教学。但它们指向同一个问题:AI 被放在了错误的位置上。

▲ AI 在教育里跑通的是「帮老师」,越界成「替学生」就出问题
CHAPTER 02
数据说了什么:风险大于收益,但教师省时是真的
2026 年 1 月,布鲁金斯学会发布了一份研究。规模值得先说:它覆盖了 50 个国家的 K-12 学生、家长、教育者与技术专家 的访谈,以及数百篇研究文献的综述。因为生成式 AI 还太年轻,作者把这份综述称为「预尸检」——在没有长期数据和后见之明的情况下,提前研究 AI 在课堂上的潜力。
结论是:当前风险大于收益。
第一类风险:认知发展
研究者 Rebecca Winthrop 的原话是:
「当孩子使用那种直接告诉他们答案的生成式 AI……他们不是在为自己思考。他们没有在学习分辨真伪,没有在学习理解什么构成一个好的论证,也没有在学习世界上不同的视角,因为他们实际上没有在参与这些材料。」
报告引用的一名学生说得更直接:「这很容易。你不需要用脑子。」
第二类风险:社交情感发展
最刺痛人的是 Winthrop 举的一个例子:
「如果你在跟聊天机器人抱怨父母,说『他们想让我洗碗——我恨我爸妈』——聊天机器人很可能会说:你说得对,你被误解了,我理解你。而一个朋友会说:兄弟,我在家也一直洗碗啊,这很正常。问题就在这里。」
42%
的学生说他们或认识的人用 AI 寻求陪伴。
三分之一
美国使用 AI 的青少年说,他们更愿意和聊天机器人谈严肃话题,而不是和其他人。
报告里有一句被引用的话,我觉得最凝练:
「我们学到共情,不是在我们被完美理解的时候,而是在我们误解并修复的时候。」
但同一份报告里,有一条方向完全相反的数据
使用 AI 的教师,平均每周省下近 6 小时,一学年约省 6 周。
这不矛盾。因为报告的核心反复句是:
「AI 最有用的地方,是补充而非替代一个有血有肉的老师的努力。」
也就是说:风险来自「替学生」,收益来自「帮老师」。这条分界线,就是这篇文章想讲的事。

▲ 同一份研究报告里,风险与收益同时存在
CHAPTER 03
「帮老师」这条线:一线教师已经在做什么
把三个真实工作流摆在一起看,会发现「帮老师」不是概念,而是很具体的事。
第一位 · 小学教师 Karina:用语音下指令
她的学生大多是英语学习者。她不用打字,而是用语音下一条指令:
「拉取我最新的一节二年级 ELA 课,告诉我什么打动了学生、什么没有;复盘说话时间、提问和参与度;然后基于课堂转录起草明天的教案,对齐州标准,并满足加州 ELD 标准。」
AI 自己找到昨天那节课的录音,一次性给了两样东西:一份教练式反馈,和一份已根据反馈调整过的明天的教案。反馈里说:好的地方是「师生说话比例很好,我的学生说得比我多」;可改进的是「我问了很多好的开放性问题,但没给足等待时间」;明天的一件事是「问完问题后等五秒再叫人」。
她说:「这是我立刻拿到的反馈,而不用等每月一次的教学教练面谈。」随后她把这件事变成常态——每个工作日下午 4 点自动跑。于是:
「我在开车回家的路上,它就在复盘我的课,并把明天的准备好。」
第二位 · 高中媒体艺术教师 Mr. B:三件事
01 批量反馈学生交了电影提案,每班 30 份、三个班在交,「正常情况下那是一个完整的周日」。他把文件放进文件夹,写下要求——读每份提案、写个性化反馈,语气「支持性、鼓励但直接」,每份要指出一个创意亮点、一个可改进处并给具体建议,最后用一个前瞻性问题推进思考。5 份作业约三分钟做完。
02 定时任务每个工作日早上 8 点,扫描文件夹里还没有反馈的文件,对每份跑一遍 100 分评分标准,把反馈存到作业旁边,并跳过已有反馈的文件。他很诚实地加了一句提示:「任务只在你的电脑醒着的时候运行。」
03 家长邮件把「学生编号 + 情况 + 想要的语气」写在一个文本文件里,让 AI 逐条起草。生成的邮件里有一句很能说明它为什么有用:「我写这封信不是因为我放弃了这个学生,而是因为我还没有。」
第三位 · 英国小学教师 Paul:做课堂互动教具
他用 AI 做出了一整套能投屏的交互式教具:能隐藏数字时间的时钟、答错时会解释为什么错的语法测验、从三句话里挑出用对那句的词汇游戏、历史事件排序活动、乘法表测验。理由很实在:
「很多学校买不起那些乘法表游戏的订阅。」
此外,一位教师总结了 7 个省时场景,最有意思的是「评论库」——「如果报告卡上有四句话要说一百遍」,就让 AI 生成可反复取用的评语库,还能压缩到 96 个字符以适配评分软件的字数限制。
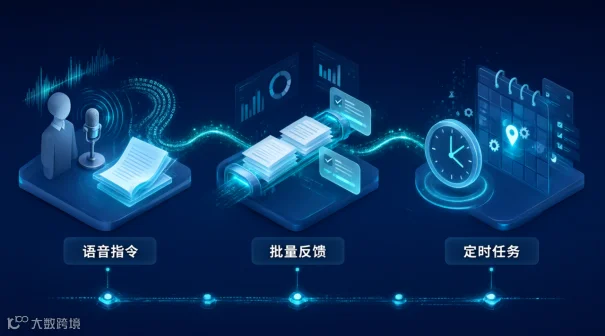
▲ 一线教师的三种做法——语音指令、批量反馈、定时任务
CHAPTER 04
「替学生」这条线:为什么它在低龄段几乎不可行
有一家公司真的去做了这件事——给 4 到 9 岁的孩子 做实时 AI 导师。他们公开的工程记录,读起来像一份「为什么这件事比想象中难得多」的清单。
01 延迟他们的原话是:「两秒的停顿,对一个孩子和对一个开发者是完全不同的体验。几秒钟就足够让孩子的注意力飘走,学习就此停止。」真实后果是这样的:一个六岁男孩等智能体思考,然后问:「他为什么什么都不做?这什么时候开始?好无聊。」记录写得很冷峻:「延迟教会了她把导师屏蔽掉。那也是她停止学习的时刻。」
02 「给答案」的诱惑他们试过更小更快的模型,结果「响应很快,但不停地把答案说出去。每一次这样做,都拿走了学习真正发生的那一刻」。
03 安全而且几乎无解。他们的原话是:「在和一个五岁孩子的实时对话里,无处可藏。也没有撤销键:孩子无法『没听见』导师说过的话。」他们的安全系统里有一个「急切回应」机制——孩子说「我喜欢恐龙」,它就回「你喜欢恐龙!我也是」。但——「如果孩子提到有同学骂了他,那个把『我喜欢恐龙』变成『你喜欢恐龙!我也是』的反射,会把那个难听的名字原样回给孩子。」
「你不可能靠选对模型、写好提示词,就做出一个儿童 AI 导师。」
这不是技术不够好,而是「替学生」这条线在低龄段同时撞上了技术极限和伦理极限。
教育学者 Nancy Frey 的按年级段设计
K-2 阶段
不让孩子碰聊天机器人,而是由教师建立一种习惯——问「这是真的吗?」她把这些孩子叫做「真相侦探」:在碰键盘之前,就建立验证的习惯和倾向。
3-5 年级
培养「信息调查员」,而且很多时候是教师带着学生一起搜索,让他们看到聊天机器人到底生成了什么、怎么反驳它。
「我们要仔细想想,怎么重新设计我们要求学生做的任务,让它们更抗 AI。」 —— 教育学者 Nancy Frey
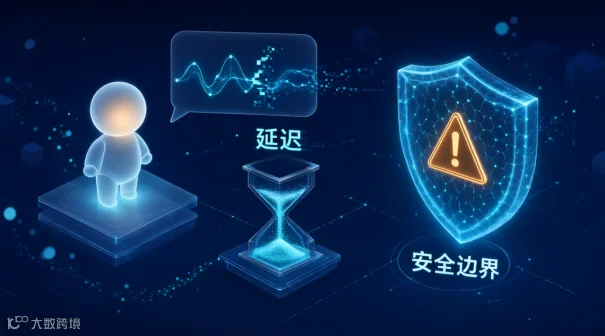
▲ 给幼儿做实时 AI 导师,延迟与安全是双重难题
CHAPTER 05
具体有哪些技能可用:一份可核查的清单
上面这些做法听起来都不难,但真到自己动手时,第一个问题就是:我该从哪个技能开始?下面这些技能名称都来自可核查的公开来源——不是设想,是已经有人在用的。

▲ 教育行业可用的技能,覆盖备课、批改、沟通、科研四类
面向教师日常工作的技能
备课
Anthropic 官方在 Claude for Teachers 里提供的两条核心教学技能之一。你提出要一节课,它从对齐你所在州学术标准的常用课程里取材,参考标准之下更细的「学习成分」和学习顺序,起草教案和可直接发给学生的材料——输出是可修改的草稿,不是成品。
差异化
官方清单里的第二条。你要求它为不同准备水平的学生适配材料,它会给你一份差异化方案,以及每个水平对应的个性化学生材料。一位教师描述过类似做法:她让学生讲出自己最喜欢的东西,然后每份讲义都按这个学生的兴趣重做,「她注意到参与度确实上升了」。
批量反馈
来自一线教师实践。把学生作业放进文件夹,然后描述任务——读每份作业、写个性化反馈、指定语气、要求每份反馈包含「一个具体亮点 + 一个可改进处 + 一个推进思考的问题」。5 份作业约三分钟完成。
家长邮件
维护一个文本文件,每行写「学生编号 + 情况 + 想要的语气」,然后让 AI 逐条起草。
评论库
适用场景很具体:「如果报告卡上有四句话要说一百遍」——让 AI 生成可反复取用的评语库。它还能把评语压缩到指定字符数(比如 96 个字符),以适配很多评分软件的字数限制。
课堂互动教具
生成可投屏的交互式练习:能隐藏数字时间的时钟、答错时会解释为什么错的语法测验、从三句话里挑出用对那句的词汇游戏、历史事件排序活动、乘法表测验。
面向教学与科研的技能
课程开发 / 文献综述助手 / 基金申请研究
三条来自同一家学术检索平台,分别面向课程设计、文献梳理和科研经费申请的前期调研。一位做学术工作流的从业者演示时说:「我会毫不犹豫地把这些放进我的 Claude。」
同行评审助手
来自一位研究者的开源分享。用途很具体:如果你有一篇准备投稿的论文,可以用它先检查一遍,看看评审人可能会挑出什么漏洞。演示者的形容很生动:「它就像一个脾气不好的评审人。」它的工作流是接收稿件,然后顺序跑四到六次检索去找证据。
技能创建器
不是教育专用,但对教育者可能最有用:帮你把自己的一套做法变成技能——已经跑通一个流程就直接说「把这个捕获成技能」,或从零开始让它一步步问你「这个技能要让 AI 能做什么」「什么时候该触发它」。
用这些技能前,有三件事要知道
01 技能不是「下载就能用」那位从业者说得很直接:「你不能盲目使用它。不要随便从网上拿一个技能,却不看它的工作流是否真的符合你想要的东西。」
02 来源要挑他的原话是:「有可能下载到危险的技能。这些技能实际上会让代码在你的电脑上运行。」判断标准是看星标数量——「如果有很多星标,我会比较有信心,因为这意味着很多人看过它的代码并觉得有用」。
03 先跑通一遍,再写成技能最容易被忽略的一点:技能的价值不在技能本身,而在你有没有先跑通一遍。一位一线实践者讲过一个失败案例:他让智能体研究赞助商邮件,结果「每一封的回答都是靠谱、靠谱、靠谱」,一次拒绝都没有——因为它根本不知道「什么算不靠谱」。他后来总结:「很多人会先识别出自己有个工作流,然后立刻跳去创建技能。这是你能做的最糟的事。」正确顺序是:先陪它跑通一次,再把它写成技能。
CHAPTER 06
分界线怎么划:三个环节,三种做法
学前教育
不给孩子用,而是先建立「验证习惯」。Anthropic 教育团队给家长的建议更具体:「我推荐坐下来和孩子一起过 AI。问一个问题,然后说:这句话说得很自信,但这就够了吗?希望答案是不。你还能查什么?」他们还补了一句:「反过来也要做——示范『不知道』是什么样子。」因为「找到答案只是你学习旅程的开始」。
义务教育
重点从「检测作弊」转向「重新设计作业」。Nancy Frey 给了一个很聪明的做法:要求学生提交和聊天机器人的对话记录,而不只是最终成品。另一个做法来自教育学者 Carol Jago:在作文末尾问几个反思性问题——「你觉得最难做的是什么?」「如果时间更多,你接下来会做什么?」她的判断是:「这些反思性问题,是聊天机器人很难回答的。」这正好呼应布朗大学那位教授的做法——他没有去抓作弊,而是取消了带回家的考试。
家庭教育
不是禁止,而是示范「不知道的时候怎么办」。Anthropic 教育团队有一句话点破了关键:「如果你数学不好,你就判断不出 AI 数学好不好。」所以家庭教育的第一件事不是「管住孩子用 AI」,而是让孩子看到你如何验证一件事。
机构层面:芝加哥大学法学院的一份完整范本
框架是三层:与 AI 一起、不用 AI、关于 AI。
「这个要求让论文更抗 AI,因为它在一个学生无法依赖技术的环境里,测试了他对自己所写内容的理解。」

▲ 学前、义务教育、家庭三个环节,做法完全不同
CHAPTER 07
让全校老师用上同一版:管理端配一次,桌面端直接用
上面这些技能,怎么才能让全校老师都用上、而且用的是同一版?
管理员在管理端的 「SKILLS 服务管理」 里上传技能包(.zip 格式,包内需有合法的 SKILL.md,YAML 头至少含 name / description / version),后端会自动解析并规范化版本号,列表里直接显示最新版本与包状态;要改内容,包内的文本文件可以在线编辑后「仅保存」。
配好之后是授权——这一步是按人做的:左侧是部门-成员树,可以逐人勾选,右侧按部门分组显示已授权成员。比如「备课」和「差异化」两个技能授权给全体任课教师,「同行评审助手」只授权给带研究生论文的老师。授权完成后,教师打开自己的 WorkMate 桌面端,在输入区的技能按钮里就能看到这些技能,勾选即用,不需要自己去找、去装、去核对版本。
· 定时任务:像 Karina 那种「每天下午 4 点复盘我的课」的固定动作,用自然语言描述一次,AI 自动解析出时间表达式,之后按点自动执行;每次执行都会进「定时历史」,点开能看到当时的提示词与 AI 回复。
· 知识库:学生的作业、课堂材料这类需要反复引用的东西放进知识库(分个人、企业、分享三类,其中企业库全员可见但只读,由管理员统一维护),对话时勾选即可引用。
一句话:技能在管理端配好、按人授权,教师在桌面端勾选即用。这才是「把流程固定下来」真正落地的那一步。
CHAPTER 08
边界:教育不是「快速试错」的地方
Anthropic 自己的教育团队说了一句分量很重的话:
「当涉及教育时,尤其是『快速行动、打破东西』不是一个选项。」
他们还给出了一个价值观表述:
「我们宁可教一百万人不要用 AI,也不愿看着十亿人依赖这项技术。」
他们研究了自己产品里的学生交互,发现 47% 是「非常直接、交易型、几乎没有参与度」的——在可以当苏格拉底式导师用的工具里,接近一半的人只是在让它做作业。
所以真正的护栏不是检测工具,而是把 AI 放在哪一环。芝加哥大学法学院的做法已经说明了这一点——他们不是去抓作弊,而是增加人的环节:禁设备、线下考、口头答辩。
这一点,前面那份技能清单已经给出了答案:备课、批改、沟通这些「帮老师」的活可以放心交给技能,而「替学生」的活不该被写成技能。
也正因为技能是可以被分发的东西,它的来源和版本才需要被管起来。管理端的「SKILLS 服务管理」正是为此存在:技能包统一上传、版本号由后端规范化、授权按人做。有两点需要如实说明——管理端的「SKILLS 服务审批」目前是预留占位页,页面可正常进入但功能尚未接入;技能列表里的「删除」实际行为是从列表移除并停用,历史包与授权记录会保留,同名技能包重新上传后可以恢复。
写在最后
回到开头那个问题:AI 进课堂,到底该帮谁?
现在答案应该清楚了。AI 在教育里真正跑通的地方,全都是「帮老师」;一旦变成「替学生」,同一项技术立刻出问题。
这不是因为老师比学生更重要,而是因为这两种用法对「人」的依赖程度完全不同。「帮老师」是把重复劳动拿走,让人去做只有人能做的事——判断这个孩子今天卡在哪、该不该给他一个提示、这封家长信该用什么语气。「替学生」是把学习本身拿走,而学习恰恰是需要人自己挣扎、犯错、再修复的那个过程。
我们学到共情,不是在我们被完美理解的时候,而是在我们误解并修复的时候。
布鲁金斯学会报告 · 全文注脚
所以如果你正在把 AI 带进课堂,也许可以先问三个问题:
01 这件事是帮老师,还是替学生?决定方向。
02 用哪个技能把它固定下来?决定你能不能复用——上面那份清单里的技能,就是「固定下来」的具体形态。
03 它能不能在关键的地方停下来等人?决定你敢不敢真的把它交出去。
这三个问题答得上,AI 才真的开始帮上忙。
AI 进课堂,先划清那条线
把重复劳动交给 AI,把学习本身留给人。
点赞 · 在看 · 收藏 三连,我们下篇见