

论文:《SORT: A Systematically Optimized Ranking Transformer for Industrial-scale Recommenders》
作者:Chunqi Wang, Bingchao Wu, Taotian Pang, Jiahao Wang, Jie Yang, Jia Liu, Hao Zhang, Hai Zhu, Lei Shen, Shizhun Wang, Bing Wang, Xiaoyi Zeng
会议:CIKM 2026
链接:https://arxiv.org/pdf/2603.03988
Transformer网络凭借出色的可扩展性(Scalability)成为了大语言模型(LLM)的基石,但在工业级推荐的排序模型中,它的应用仍处于起步阶段。长期以来,排序模型一直由DIN、DeepFM、DCN等专门设计的特征交叉网络主导。这类网络以向量级运算、低维矩阵乘法等低算力操作为主,既难以充分利用现代加速器的大规模并行算力,也难以刻画高动态的数据模式。
然而,把Transformer直接搬到排序模型上并不是最优解。推荐与语言建模之间存在本质差异,核心挑战在于高特征稀疏与低标签密度的叠加:模型需要从十亿级的离散特征空间中学习稳健的表示,而可用的监督信号却极其稀少。
针对这一挑战,我们提出了SORT(Systematically Optimized Ranking Transformer):在数据组织上,采用以请求为中心(Request-centric)的样本组织方式;在计算分配上,通过局部注意力(Local Attention)与查询剪枝(Query Pruning),把Transformer的算力集中到与标签相关的交互上;在训练上,引入生成式预训练提升标签密度;在架构上,对Tokenization、多头注意力(MHA)和前馈网络(FFN)三个模块进行了一系列改进,稳定训练过程并扩大模型容量。在系统层面,我们将训练阶段的模型算力利用率(MFU)最高提升至45%。
实验表明,SORT显著优于多个强基线,并在数据规模、模型规模和序列长度三个维度上展现出良好的可扩展性。在AliExpress四大推荐场景的在线A/B实验中,SORT带来订单+7.47%、买家+6.67%、GMV+8.65%的提升,同时延迟降低62%、吞吐提升近6倍(+589%)。目前SORT已在AliExpress全量上线,服务全部用户。
1. 背景
1.1 传统排序模型的瓶颈
传统的深度学习推荐模型(DLRM)通常依赖专门设计的结构来处理不同类型的特征:例如用DIN建模序列特征,用DeepFM、DCN建模大量人工构造的异构特征交叉。与Transformer相比,这类结构缺乏可扩展性,模型容量有限。因此,模型学到的模式主要依赖稀疏Embedding(如Item Embedding)的"死记硬背",而已有研究表明,庞大的Embedding表往往会损害泛化能力并导致过拟合。
受LLM的启发,业界开始探索可扩展的排序模型架构,大致可以分为两条路线:
-
统一序列路线:HSTU将排序视为Next-Token Prediction任务,仅以一条统一序列作为输入,在一个样本内同时处理多个候选,从而摊薄训练成本。MTGR、GenRank等后续工作也沿用了这一范式。 -
异构特征交互路线:Wukong、RankMixer聚焦于异构特征(除用户序列)之间的交互建模。而OneTrans把用户序列也包含进来,用带独立参数的Transformer分别建模异构特征和用户序列(不同类型的Token固定使用各自的参数),可以视为一种基于规则路由的MoE。
如果把只依赖特征工程的传统DLRM放在光谱的一端,把架构统一、可扩展的LLM放在另一端,那么SORT相比已有工作更明显地向LLM一端靠拢:它不再依赖领域专用的交互模块,而是采用更简洁统一的架构,并以数据驱动路由的MoE替代规则路由。
1.2 推荐与语言建模的本质差异
在推荐排序场景下直接套用Transformer效果欠佳,根源在于推荐与语言建模在两个方面截然不同:
-
高特征稀疏:语言模型借助BPE、WordPiece等子词切分技术,把词表控制在几十万量级;而排序模型需要处理十亿级的商品词表,Embedding表极其庞大,特征稀疏度极高。 -
低标签密度:语言模型在文本序列的每一个位置都有监督信号(预测下一个Token),并且每次预测都要在整个词表中做选择,单个标签携带的信息量大。排序模型则相反:一方面,占据输入主体的用户历史序列没有直接监督,监督信号只存在于目标商品上;另一方面,这些信号是稀疏的二值标签,且绝大多数是负样本(例如未点击)。
这种"巨大的参数空间只被稀疏二值标签约束"的信息不对称,不仅会引起过拟合,还会造成大量计算浪费:长历史序列占用了大部分计算,却几乎没有直接的监督信号。因此,把Transformer用于工业级排序需要回答两个核心问题:
-
如何把Transformer的计算重新分配到与标签相关的交互上,避免在长序列上浪费算力? -
如何在稀疏标签下稳定训练十亿级稀疏参数,避免过拟合?
SORT通过一系列改进回答以上两个问题,既压缩并且摊薄了长序列部分的算力,又避免了大量稀疏参数导致的过拟合。
2. SORT:系统化优化的排序Transformer

图1:SORT整体架构
输入由用户历史序列H、用户画像U和候选集C拼接而成,并插入BOS/SEP特殊Token;每个Block使用QKNorm和带稀疏掩码的门控注意力,随后接稀疏MoE层;查询剪枝使序列随层数逐渐变短;排序头在候选Token上输出多目标预测。
2.1 任务与样本组织
我们将排序问题建模为一个多目标二分类任务,同时预测点击(CTR)、加购(AddCart)和购买转化(CVR)三种主要用户行为的概率,并以AUC衡量模型效果。
传统排序模型通常以曝光为中心(Impression-centric)组织样本,即每个样本只包含一个候选。这样一来,同一请求内的每个候选都要重复处理一遍与候选无关的特征(如用户画像和行为序列),造成不必要的计算开销。
为此,SORT采用以请求为中心(Request-centric)的样本组织方式,把同一请求内的多个候选封装到一个统一的样本中。具体而言,一个请求r包含待排序的候选集C = {c_1, …, c_N},每个候选由商品元信息、统计特征和用户-商品交叉特征刻画;同时,请求r还包含所有候选共享的请求级特征:
-
用户序列H:按时间排序的历史行为序列,每个行为包含商品的静态元信息以及交互上下文(如时间戳、行为类型、场景); -
用户画像U:用户静态元信息与统计特征的组合。
于是,原本的N个曝光样本 {⟨H, U, c_j⟩} 被合并为一个请求样本:
S = ⟨H, U, C⟩
2.2 模型结构
SORT基于Transformer构建,并直接吸收了LLM中沉淀下来的最佳实践:基于RMSNorm的Pre-Normalization、用于相对位置编码的RoPE,以及SwishGLU激活函数。在此基础上,我们对以下几个模块进行了系统化优化。
Tokenization与特殊Token
用户历史序列和候选集中的每个商品各生成一个Token,用户画像则映射为多个Token(我们也尝试过把候选商品切分为多个Token,但效果差异可以忽略)。Tokenization流程为:对多个原始特征做Embedding查表,拼接后经过线性投影和归一化,映射到模型维度。
除特征Token外,我们还引入了两类特殊Token:在用户历史序列前加入一个BOS,在用户历史序列与用户画像之间、用户画像与候选之间各插入一个SEP。最终输入序列为:
S = [BOS; Tokenize(H); SEP; Tokenize(U); SEP; Tokenize(C)]
这些特殊Token有两个作用:一是提供位置信息,帮助模型识别序列边界;二是充当注意力汇聚点(Attention Sink),吸收多余的注意力分数。实验中,加入特殊Token带来了显著的效果提升。
多头注意力(MHA)
-
候选独立处理:对候选部分使用对角掩码,并为所有候选分配相同的位置ID,使每个候选只关注自身以及前面的历史序列和画像Token,候选之间互不干扰。 -
QKNorm:对Query和Key施加RMSNorm,提升训练稳定性和模型效果。 -
注意力门控(Attention Gate):借鉴HSTU与Gated Attention,在缩放点积注意力之后加入门控操作,进一步提升效果。 -
局部注意力(Local Attention):在标准因果掩码的基础上,历史序列中的大部分Token只做窗口为W的局部注意力,而所有候选Token及其附近的少量Token仍保留完整的因果注意力。这使注意力的时间复杂度从O(L²)降为O(W·L),非常适合处理超长用户序列。 -
查询剪枝(Query Pruning):类似OneTrans,在每一层剪掉距离候选较远的Token对应的Query,使序列随层数逐渐变短,最后一层最多保留128个非候选Token。这一改动让计算量几乎减半,而且效果出人意料地优于不剪枝的基线。我们认为这源于推荐系统中天然存在的时间衰减归纳偏置,即越久远的行为对当前决策的影响越小。
前馈网络(FFN):稀疏MoE
FFN采用SwishGLU激活,并进一步替换为稀疏混合专家(Sparse MoE)结构:路由网络为每个Token只激活Top-K个专家,再对专家输出加权聚合。稀疏MoE可以在不增加计算量的前提下大幅扩大参数规模、增强记忆能力,这对延迟约束严格的推荐场景尤为关键。
排序头与损失函数
在候选Token对应的输出上接一个FFN(ReLU隐层 + Sigmoid输出层),为每个目标输出预测值。每个目标使用二元交叉熵损失,总损失为各目标损失的加权和。
2.3 稀疏Embedding策略
海量用户和商品带来的特征稀疏,是推荐模型过拟合的重要来源。SORT对用户和商品采取了不同的处理策略:
-
用户侧:不使用显式的用户ID特征,而是通过用户的历史行为序列和画像(如年龄、地区)来刻画用户。
-
商品侧:采用GPSD提出的生成式预训练范式:先在点击序列上以Next-Item Prediction任务预训练商品Embedding,通过逐位置的监督提升标签密度,缓解稀疏Embedding的过拟合。迁移到排序模型时,我们比较了两种策略: -
Sparse Transfer:用预训练的稀疏Embedding初始化,并在排序训练中继续微调; -
Sparse Transfer + Sparse Freeze:在此基础上,排序训练全程冻结稀疏Embedding。
2.4 训练与推理系统
训练侧:训练系统基于RecIS构建,MoE模块基于Megablocks实现。整个模型可以分为两部分:受I/O和访存限制的稀疏模块,以及受计算限制的稠密模块。
-
稀疏模块:在算子融合、访存合并、动态Embedding等常规优化之外,我们引入了多进程组通信(MPGC),把特征Embedding的通信调度到多个并行进程组上,以隐藏通信延迟。 -
稠密模块:现有的SDPA、FlashAttention等注意力算子难以支持SORT结构复杂的稀疏掩码,因此我们开发了通用稀疏注意力算子,采用分块计算并预加载掩码,跳过完全被掩码的块;同时配合混合精度计算和梯度累积。
这些优化使Base规模模型的MFU从13%提升至22%,Large模型的MFU更是达到45%,说明训练系统能够随模型规模高效扩展。
推理侧:通过torch.export与AOTInductor把动态图转为静态图,并进行三类优化:(1)针对不同掩码定制的高性能稀疏注意力Kernel;(2)合并自注意力中的线性层、融合零碎算子;(3)半精度计算、KV Cache、多Context/多Stream执行等通用LLM优化。相比未做推理优化的SORT,吞吐提升29.4%,延迟降低29.3%(与后文线上A/B中相对传统DLRM的效率提升是不同口径)。
3. 实验
3.1 实验设置
我们从工业推荐系统近几个月的用户日志中采集训练集,并以随后产生的数据作为测试集。训练集包含约6亿次请求、5000万用户和90亿次曝光,测试集包含约2000万次请求、400万用户和3亿次曝光。
基线包括标准Transformer(不含SORT中的局部注意力、查询剪枝、MoE、注意力门控和QKNorm)、HSTU和OneTrans,各模型规模经过对齐以保证公平比较。所有模型使用AdamW优化器,batch size为12K,默认训练1个epoch,用户历史序列最大长度为1K,采用BF16混合精度(排序头和MoE路由器保留FP32),根据模型规模在4~32张A100上训练1~10天。所有模型的Embedding参数量均约为20B。
3.2 生成式预训练有效性
我们首先在标准Transformer上验证生成式预训练的效果,对比三种做法:从零训练;用预训练的商品Embedding初始化并继续微调(Sparse Transfer);初始化后在排序训练中全程冻结(Sparse Transfer + Sparse Freeze)。
实验证明,仅迁移预训练Embedding并继续微调不仅没有收益,反而略有下降;而冻结预训练Embedding让点击(CTR)、转化(CVR)、加购(AddCart)三个目标的AUC分别大幅提升了2.81pt、1.34pt和2.08pt(pt表示AUC的绝对提升,1pt = 0.01)。Sparse Freeze的另一个好处是支持多轮(Multi-epoch)训练而不会严重过拟合:训练和验证AUC都随epoch平稳增长。后续实验均默认采用Sparse Transfer + Sparse Freeze。

图2:生成式预训练以及参数迁移策略对训练过程中各指标的影响。
3.3 消融与对比实验
在Base规模下,我们把各项优化分别单独加到标准Transformer上,观察每一项的独立贡献,并与HSTU、OneTrans两种代表性结构进行对比。

几个值得关注的结论:
-
每项优化都带来了独立收益,其中特殊Token和查询剪枝最为突出,分别提升CTR AUC +0.33pt和+0.26pt;查询剪枝还把FLOPs从43G降到24G。MoE则在计算量不变的情况下,把模型参数量(不含Embedding)从18M扩大到83M,CTR AUC提升0.19pt。 -
通过可视化注意力分布,我们发现BOS Token吸收了相当多的注意力权重,起到了Attention Sink的作用;QKNorm则有效抑制了注意力权重的波动,有利于训练稳定。 -
局部注意力在1K序列长度下只把FLOPs从43G降到40G,但在更长序列下作用会变得至关重要。 -
各项优化叠加后的SORT在点击、转化、加购三个目标上的AUC分别提升0.41pt、0.25pt和0.31pt,全面领先。作为对比,HSTU反而比标准Transformer低约0.2pt,OneTrans只提升0.1~0.2pt。同时,SORT的计算量只有标准Transformer的56%(24G vs. 43G FLOPs)。
3.4 Scaling:数据、模型与序列长度
与LLM几乎取之不尽的语料不同,推荐系统的数据量受限于用户交互规模,一定时间窗口内的数据是有限的。为此我们探索了两种扩大有效数据量的方式:一是在同一数据上多轮训练(得益于生成式预训练和冻结Embedding,多轮训练不会严重过拟合);二是融合其他场景的数据,并把场景标识作为输入特征,让模型区分不同数据来源。最终的Scaling实验覆盖:
-
数据规模(多轮):训练1、2、3个epoch; -
数据规模(多场景):单场景 vs. 多场景; -
模型规模:Small、Base、Large; -
序列长度:256、512、1K、2K、4K。
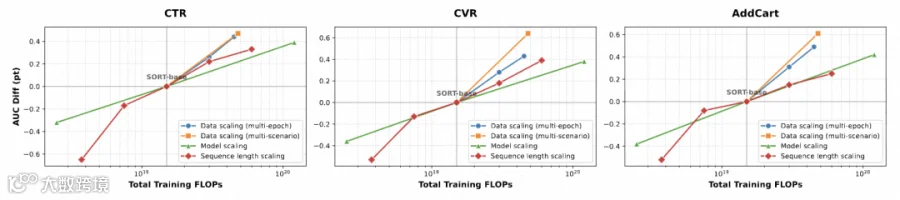
图3:SORT在数据规模、模型规模与序列长度上的Scaling(以单场景、1个epoch、序列长度1K的SORT-base为基准)
如图3所示,增加数据规模、模型规模或序列长度都能稳定带来效果提升,验证了SORT良好的可扩展性。其中数据Scaling的收益最为显著,在增加相同训练算力(FLOPs)时提升最快。这意味着在给定算力预算下,生产实践中应优先扩展数据,其次是序列长度,最后是模型规模。
3.5 在线A/B实验
我们在AliExpress的首页、详情页、购物车和支付后四大推荐场景进行了为期一个月的在线A/B实验。线上基线是已基于一年以上数据增量训练的传统DLRM,而上线的SORT采用Base规模配置,仅使用最近三个月的数据训练。
SORT在效果和效率上都取得了显著提升:平均订单+7.47%、买家+6.67%、GMV+8.65%,同时延迟平均降低62%、吞吐平均提升589%。分场景看,四个场景的订单、买家和GMV全部正向增长:订单提升2.37%~11.43%,GMV提升6.12%~11.49%;各场景延迟降低51%~72%,吞吐提升325%~1180%。效率提升来自数据、模型与系统三个层面的协同:以请求为中心的数据组织让共享的用户画像和历史序列在一次前向中被所有候选复用;统一的Transformer架构减少了碎片化算子带来的开销;再加上优化后的推理系统,共同带来了显著的效率收益。
4. 总结
SORT是一个面向工业级排序系统化优化的Transformer,旨在弥合Transformer与工业级排序模型之间的鸿沟。针对高特征稀疏和低标签密度两大挑战,SORT将以请求为中心的样本组织、局部注意力与查询剪枝、生成式预训练,以及特殊Token、QKNorm、注意力门控、稀疏MoE等架构改进整合进一个统一且硬件友好的设计中。SORT显著优于多个强基线,并在数据规模、模型规模和序列长度上平稳扩展,其中在固定算力预算下数据Scaling的收益最为显著。目前SORT已在AliExpress全量上线,在带来GMV +8.65%等显著业务收益的同时,延迟降低62%、吞吐提升近6倍。
5. 关于我们
我们是阿里国际数字商业集团AliExpress推荐算法团队,致力于将大模型时代的前沿技术引入工业级推荐系统,围绕可扩展的排序大模型、生成式推荐、用户超长序列建模等方向持续深耕,以更深刻地理解用户的个性化偏好,持续提升用户体验与平台收益。近年来,我们在KDD、SIGIR、CIKM等顶级学术会议上发表了多项研究成果。欢迎对推荐大模型感兴趣的同学加入我们,共同探索推荐系统的下一代范式!
🎁 关注抽奖 · 本周福利
关注公众号,即可参与本周抽奖!
点击文末「抽奖助手」小程序,一键参与,我们会在下周四自动开奖,抽出 1 位 幸运粉丝送出 天猫超市卡 50 元 🎁。
开奖结果会在小程序内公布