

编辑 | 张 珊
审核 | 王紫嫣
今天介绍的是Arxiv上的一篇名为“De novo design of monoclonal and bispecific antibodies with OFAntibody”的文章。
1.引言
抗体特异性高、亲和力好、骨架可以改造,已成为一类主要治疗分子。纳米抗体体积小、稳定性高,容易组装成多价分子。但抗体发现仍主要依赖动物免疫、展示筛选和亲和力成熟。CDR 的序列和构象空间很大,识别又同时取决于表位、界面几何和 CDR 构象,因此很难用计算精确设计所需的结合模式。
基于深度学习的蛋白质结构预测和生成模型,已经明显改变了蛋白质工程。AlphaFold 3、RFdiffusion 和 ProteinMPNN 能够在明确目标下搜索蛋白的序列–结构空间,为把生成方法扩展到抗体奠定了基础。不过,抗体的结合界面主要位于由框架支撑的 CDR 环上,核心任务是在固定框架内重设计 CDR,使其与指定表位形成互补的相互作用。围绕这一任务,抗体生成模型已从局部 CDR 优化推进到按靶点条件生成。DiffAb 在给定框架和抗原的条件下重设计 CDR,RFantibody 和 IgGM 则按指定表位或抗原设计抗体。PPIFlow、BoltzGen、AnewOmni 和 ODesign 进一步把抗体纳入通用的分子设计框架。但是,这些方法仍主要生成只有一个界面的复合物,还不能系统设计含有两个偶联界面的双特异性抗体。
双特异性抗体把不同的靶点识别功能和生物学功能放在同一个分子中,正成为一种日益重要的治疗分子。例如,CD20×CD3 同时识别表达 CD20 的靶细胞和表达 CD3 的 T 细胞。这种功能整合带来了特殊的结构设计问题。两个结合界面由同一套抗体结构连接,所以双抗设计不能简单分成两步:先独立设计两个单特异性结合单元,再把它们组装起来。成功的设计必须让每条结合臂朝向指定表位,同时使两个抗原–抗体界面与整体双抗格式相互兼容。结构域的排列和连接方式、linker 的几何形状,以及邻近的可变区,都会限制两个互补位的位置、朝向和可及性,抗原可能因此无法进入某个结合位点。于是,两个各自都能形成良好界面的结合单元,放进同一个双抗后仍可能发生几何冲突。实际开发中,仍主要依靠专家选择格式,并反复筛选亲本结合分子与分子结构的组合。
这篇文章提出 OFAntibody,一个用于单克隆抗体和双特异性抗体设计的统一生成框架。它既能按条件生成抗体骨架和由 CDR 介导的表位界面,也能在同一框架内按指定格式设计双抗。模型通过臂感知的多热点路由指定每条臂对应的表位,用三元复合物学习多个界面的空间约束,并利用从 ASD 蒸馏得到的约 15 万对抗原–抗体相互作用扩充界面数据。在纳米抗体基准中,其 Top-5 富集率为 41.5%,是 RFantibody 的 5.39 倍。三个双抗任务的热点通过率为 94%–100%;双链抗体、串联纳米抗体和交叉双可变区的能量通过率分别为 60%、13% 和 8%。
2.方法
2.1 OFAntibody框架

OFAntibody 是一个统一的全原子抗体结构设计模型,可根据靶抗原结构、表位约束和双抗格式生成单抗或双抗(图 1a)。输入包括抗原结构、希望抗体接触的表位,以及抗体自身的设计约束;输出是满足这些要求的抗体–抗原复合物构象。
单抗和双抗的生成对象不同。对于单抗,OFAntibody 在固定的 VHH 或 ScFv 框架上生成 CDR 构象。对于双抗,OFAntibody在串联纳米抗体、双链抗体或交叉双可变区等预先给定的格式下,同时生成各条结合臂的 CDR 以及连接区的构象。这一生成框架包含三项设计原则:
-
格式条件使模型适应不同双抗的结构域排列和连接方式。 -
臂感知的多热点路由明确编码靶点表位、热点区域和结合臂之间的对应关系,从而把每条臂引导到指定表位(图 1c)。 -
多来源结构数据训练:训练数据有三个来源:实验解析的抗原–抗体复合物、三元复合物,以及蒸馏得到的抗原–抗体相互作用(图 1b、d)。其中,单抗数据提供界面相互作用和 CDR 几何,三元复合物提供多个界面共存时的空间约束(图 1e)。
基于该框架,OFAntibody 可以设计纳米抗体和成对 ScFv,也可以设计上述三种双抗。生成时以靶点表位、抗体结构约束和结合臂分配为条件。后文从纳米抗体设计、多格式双抗设计和多界面联合设计三个方面评估这一模型。
2.2 训练数据集与预处理
2.2.1 数据集
OFAntibody 使用三类数据训练。SAbDab 提供抗原–抗体晶体结构。PDB triplex 是从 PDB 中整理出的三元复合物,凡已出现在 SAbDab 中的结构,都从 triplex 的训练集和测试集中删除。蒸馏数据是由结构预测得到的抗原–抗体复合物,只用于训练,不进入测试。所有测试集还去掉与任一训练结构序列相似度不低于 40% 的样本。单抗版不使用三元复合物,SAbDab 与蒸馏数据按 1:1 抽样。双抗版加入三元复合物,三者按三元复合物:SAbDab:蒸馏数据 = 2:1:1 抽样。训练前先对数据聚类,再按类别抽样,避免少数靶点或界面类型在训练中占比过高。
2.2.2 抗体和纳米抗体复合物数据的蒸馏
蒸馏数据来自抗原特异性抗体数据库 ASD。与 SAbDab 重复的样本先删除,再用 ColabFold 为所有抗原–抗体对搜索多序列比对,并由 AlphaFold2-Multimer 为每一对预测 5 个结构,只保留 ipTM ≥ 0.7 的结果。部分抗原含有多个结构域和很长的无序区。这些抗原用 AFragmenter 按预测对齐误差 PAE 切开,每个结构域再单独与抗体预测一次。只保留 ipTM 最高、且仍然 ≥ 0.7 的结构域–抗体对。
2.2.3 三元复合物数据集的获取
三元复合物从 PDB 中筛选。每个候选包含一条结合链和两条没有顺序之分的靶链,三条链必须来自同一个 PDB 条目。结合链须是与两条靶链都不同的蛋白,并且到两条靶链的距离都 ≤ 5 Å。满足条件的样本构成初始数据集。同一 PDB 条目中的重复结构再两两比较。若结合链是同一种蛋白、两条靶链也是同一组蛋白,就认为组成相同。由于靶链没有固定顺序,两种配对方式都做结构比对;只要其中一种复合物 RMSD < 2 Å,就视为重复并删除。去重后得到最终的 triplex 数据集。
2.3 抗体和双特异性抗体设计的条件策略
2.3.1 多路由热点残基的采样
训练时先确定结合链和靶链,再从每条靶链的结合界面上采样热点。每个残基带有坐标、链编号和条件指示。条件指示表示该残基保持给定结构;它的取反是设计指示,用来标出需要生成的区域。一条链只要含有至少一个待设计残基,整条链就是结合链。这条链上所有残基都算作结合残基。三元复合物不再按这个规则判断,直接使用数据集里已经标注的结合链。
每个训练样本有 1/3 的概率打开热点条件。关闭时,热点类别和结合臂类别都设为 0。打开时,结合残基周围 8 Å 以内的非结合链被选为候选靶链。每条靶链只从自己的界面采样热点,并获得独立的类别,不同靶链的热点不混在一起。
2.3.2 热点类别与结合臂类别的分配
为建立靶点表位与抗体结合臂之间的对应关系,热点残基按照所属靶链被赋予类别标签,这些标签再根据空间邻近关系传递给结合残基。设 表示靶链 上采样得到的热点集合。含有采样热点的靶链集合定义为 。按照靶链的顺序,为它们分配连续的类别编号 。每个热点残基继承其所属靶链的类别标签:
其中 。对于每个结合 token ,找到距离它最近的采样热点 若最近热点位于距离阈值 以内,该结合 token 就继承对应的热点类别标签:
随后,第 条抗体结合臂定义为类别为 的结合残基集合 。
2.4 基准评估
2.4.1 纳米抗体基准评估
每个靶点、每种方法生成 100 个候选结构。这些结构来自四套 VHH 框架,每套采样 25 个。抗体区域按 IMGT 编号,框架的序列和结构保持固定,只重设计 CDRH1–3。每个结构再用 ProteinMPNN 生成 8 条 CDR 序列,先用 BoltzGen 的排序策略在内部排序,只保留得分最高的一条。随后,所有方法的候选放在一起比较。iPTM 和界面最小 PAE 的权重为 1,结合分子 pTM、氢键、盐桥和 ΔSASA 的权重为 2。每个候选先按各项指标分别排名,再取归一化名次中的最大值作为最终分数,也就是由它表现最差的一项决定名次。分数越低,排序越靠前。设 为第 个设计在指标 上的名次,最终分数为各项归一化名次的最大值:
进入排序前还要通过几何过滤。结合链上相邻残基若缺少主链原子 C、N 或 CA,或者 C–N 距离大于 2.0 Å、CA–CA 距离大于 4.5 Å,就视为断链。非相邻原子距离小于 1.1 Å 视为碰撞;同一残基内部和相邻残基之间的原子对不计入,碰撞检测也不考虑共价键连接。断链和碰撞都不能出现。
2.4.2 双特异性抗体基准评估
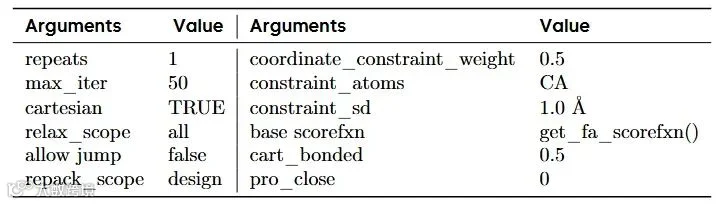
交叉双可变区、双链抗体和串联纳米抗体分别以 PDB 6O8D、9IP8,以及 4KRL– –4KRO 为模板。框架和晶体中已有的 linker 保持固定,只重设计固定长度的 CDR。每个任务采样 100 个结构,每个结构由 ProteinMPNN 写 8 条序列,再用 Rosetta 做侧链填充和约束松弛(参数见表 1)。每条结合臂保留界面能最低的序列。两条臂的界面能都低于或等于参考复合物,整个设计才算能量通过。
热点通过率和 CDR 相互作用通过率根据采样结构计算。串联纳米抗体按纳米抗体标准评估,另外两种格式按抗体标准评估。热点残基的 Cα 到对应结合臂任一原子的距离小于 9 Å 即算命中;每条臂的热点覆盖率都要超过 60%。CDR 相互作用要求每条臂同时满足表 2 中该格式的全部距离规则。

2.4.3 联合设计与独立结合分子组装的评估
独立组装用来模拟先分别设计、再拼成串联纳米抗体的流程。两个 VHH 分别靶向 HER2 上的 NM02 和 2RS15d 表位。单条 VHH 需满足 iPTM > 0.8、链间最小 PAE < 2.0、VHH 的 pTM > 0.8,合格候选再穷举配对。配对时以共同的 HER2 A 链为参考做刚体叠合,并把 NM02 的 VHH 变换到 2RS15d 的坐标系中。两个 VHH 之间只要有一对非氢原子距离小于 2.0 Å,就视为碰撞并删除。没有碰撞的组合再比较两种串联方向:2RS15d → NM02 和 NM02 → 2RS15d。末端 Cα 距离不超过 54.15 Å 才认为 linker 接得上,并选择距离更短的方向,插入 。随后只优化 linker 构象,两条 VHH 的序列保持不变。
3.实验
3.1 OFAntibody 在纳米抗体设计中取得当前最优的计算机模拟性能


为评估纳米抗体设计,OFAntibody 与 IgGM、BoltzGen、PPIFlow、RFantibody 和 AnewOmni 放在同一套标准下比较。所有方法的候选先去除断链和严重碰撞,再混在一起排序,而不是各自单独打分。基准包含 12 个靶点上的 13 个任务,覆盖 SARS-CoV-2 RBD 和 Core、流感 HA、TNFα、TSLP、IL-33、HER2、EGFR、PD-L1、VWF-A1、CCR8、NKp30 和 LGR4。每个任务使用预先指定的热点和四套 VHH 框架。
在全部任务中,OFAntibody 的 Top-5、Top-10 和 Top-20 富集率分别为 41.5%、39.2% 和 36.5%,均为最高(图 2a)。Top-10 在 13 个任务中的 11 个排名第一,其中包括 LGR4。它的中位排名为 250.0,比第二名 BoltzGen 靠前 28.5 个名次;平均排名为 270.3,比第二名 IgGM 靠前 18.0 个名次(图 2c)。
OFAntibody 的 iPTM 和结合分子 pTM 更高,界面最小 PAE 更低,氢键、盐桥和 ΔSASA 也更大(图 2b)。这说明预测界面和 VHH 自身结构的置信度更高,极性接触和界面埋藏也更充分。AnewOmni 的大多数候选因断链或原子重叠未通过几何检查;少数候选的局部接触指标较好,但存在原子插入抗原内部,预测置信度也较低。因此,局部接触数量需要和整体几何、界面置信度一起判断。
去掉蒸馏数据后,Top-5、Top-10 和 Top-20 富集率分别下降 9.2、6.9 和 7.3 个百分点,其中 Top-5 下降最多(图 2d)。大规模蒸馏相互作用增加了模型见过的界面几何和相互作用模式,从而改善了不同靶点和表位上的纳米抗体设计。
3.2 OFAntibody 能够在预先指定的表位约束下设计多种格式的双特异性抗体
双抗需要同时优化两个相互偶联的界面,并使其兼容预先给定的格式。评估从四个方面进行:
-
热点通过率要求两个界面都满足指定热点; -
CDR 相互作用通过率要求两个界面都符合典型的 CDR 结合标准; -
几何通过率要求同时满足前两项且没有严重原子碰撞; -
能量通过率要求两个界面的计算能量都优于对应的参考结合分子。
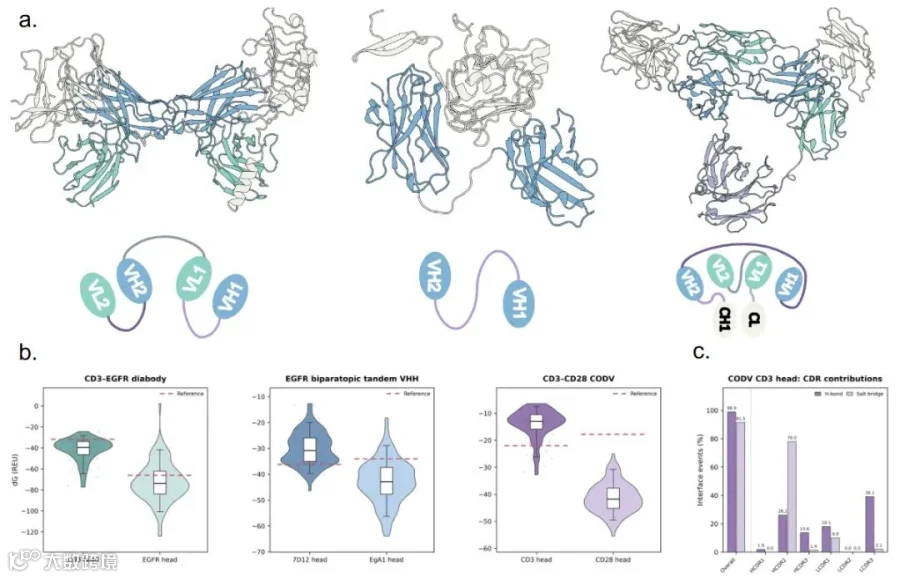
串联纳米抗体由柔性肽连接两个 VHH,两条臂的朝向主要取决于 linker(图 3a,中)。单链双链抗体在一条多肽上排列四个 VH/VL,不相邻的可变区配成两个结合位点(图 3a,左)。交叉双可变区由两条链组成,两对 VH/VL 交叉配对,C 端的 CH1 和 CL 将整体稳定为三角形(图 3a,右)。

三个任务分别是:以 PDB 9IP8 为参考的 EGFR×CD3 双链抗体,以 PDB 6O8D 为基础的 CD28×CD3 交叉双可变区,以及结合 EGFR 两个表位的 7D12×EgA1 串联纳米抗体。如表 3 所示,热点通过率分别为 94%、100% 和 100%,三个任务平均覆盖 96.79% 的指定热点。CDR 相互作用通过率分别为 69%、10% 和 68%。能量通过率分别为 60%、8% 和 13%,所有设计的 Rosetta 界面能都为负值(图 3b)。这些结果表明,OFAntibody可以在预先定义的表位-结合臂分配下生成双特异性抗体设计,同时保持CDR介导的界面相互作用和有利的计算界面能量。
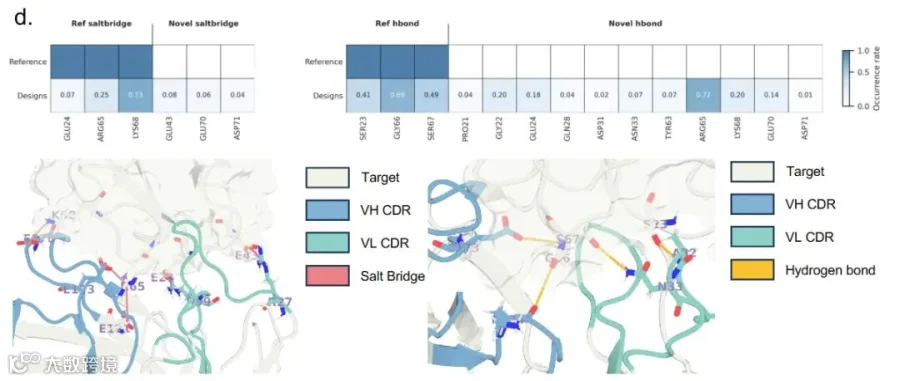
CD28×CD3 的低通过率主要来自 CD3 臂。该臂的 CDR 相互作用通过率和能量通过率分别只有 10% 和 8%(表 3)。设计出的 CD3 界面上,98.9% 的氢键和 91.5% 的盐桥仍由 CDR 形成(图 3c)。表明CDR残基仍贡献了大部分关键界面相互作用,但通过率低,是因为按常规抗体制定的残基数量和距离阈值不能充分描述 CODV 的三角形几何。与 OKT3–CD3 参考界面相比,这些设计保留了 46.4% 的氢键和 87.2% 的盐桥,表明模型在 CODV 的几何约束下,模型保留了相当一部分参考极性相互作用。同时还观察到新生成的氢键和盐桥,说明 OFAntibody 可以在受限的双抗几何中探索替代的局部相互作用模式。(图 3d)。
3.3 双特异性抗体的联合设计优于单特异性结合分子的独立设计与组装
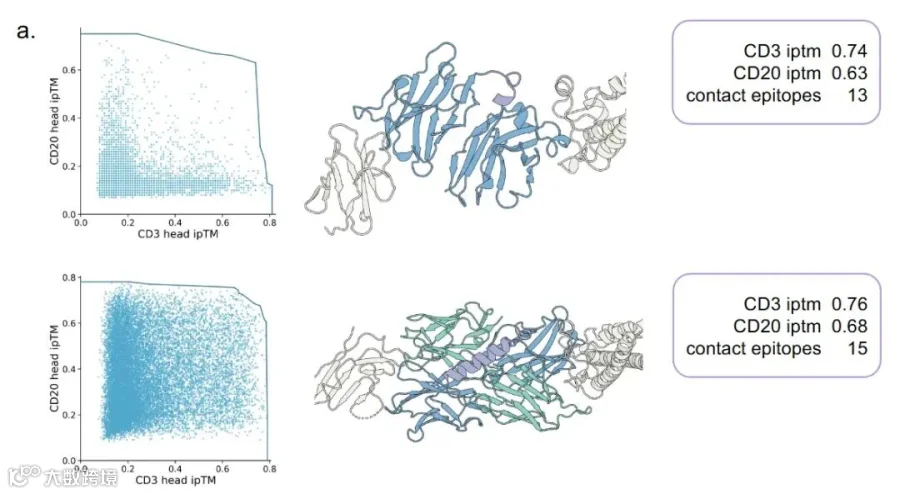
两条单独合格的结合臂,拼进同一个双抗后仍可能发生几何冲突。相对朝向、空间可达性和 linker 连接都会限制它们能否共存。为此,实验在相同表位约束下比较两种策略:联合设计一次优化两条臂及其连接方式;独立组装则先分别设计两条臂,再按各自的结合构象拼接。案例是同时结合 HER2 上 NM02 和 2RS15d 两个表位的串联纳米抗体。联合设计同时指定两个热点,并一次生成两个 VHH 的 CDR 和 linker。独立组装先按各自表位设计两个 VHH,选出高置信度的单特异性候选,再组合、构建 linker 并检查界面几何。
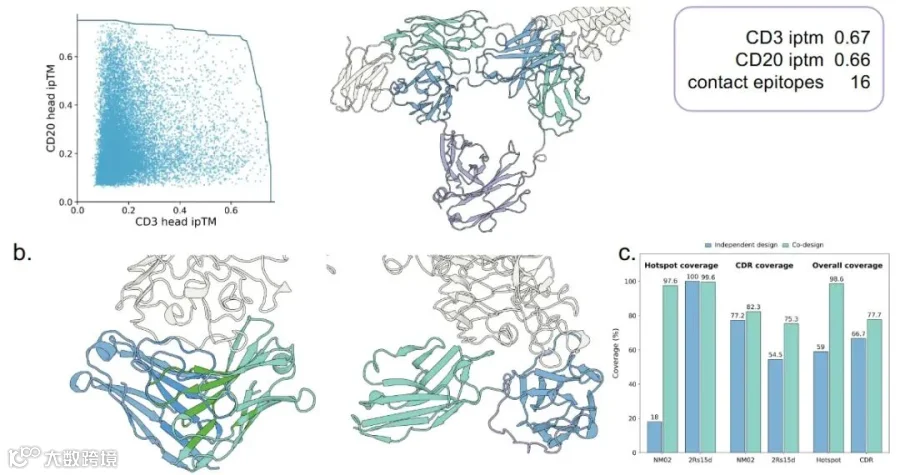
独立组装得到 2,130 种组合,其中 1,708 种(80.2%)存在严重的 VHH–VHH 碰撞(图 4b)。去除后,又有 246 种因朝向或间距无法连接 linker 而被排除,最后只有 176 种进入 linker 优化。联合设计的候选没有严重空间冲突。单个界面质量高,并不必然得到整体兼容的双抗。
在通过几何过滤的候选中,接触残基定义为距离抗原 5 Å 以内的重原子所在残基。联合设计的接触残基中,CDR 占 77.7%,比独立组装高 11 个百分点;热点覆盖率为 98.6%,高 39.6 个百分点(图 4c)。独立组装在 NM02 端的热点几何变差,在 2RS15d 端的 CDR 几何变差。这些结果表明,独立组装可能会损害互补位与表位的兼容性;联合生成能同时协调两个界面、两条臂的朝向和 linker,从而更好地保持表位靶向。
3.4 使用 OFAntibody 将双特异性抗体格式作为设计变量进行探索
双抗格式决定结构域如何排列,以及两条结合臂如何连接。即使靶点和表位不变,不同格式也会改变两条臂能否同时形成兼容界面。常规做法是先得到单特异性结合分子,再改造成选定格式;然而,为一种格式优化的分子却未必适用于另一种格式。OFAntibody 把格式作为生成条件,可以在同一对靶点和表位下分别生成不同格式。
实验以 CD20×CD3 为例。串联纳米抗体、双链抗体和交叉双可变区各采样 20,000 个结构,每个结构由 ProteinMPNN 写 4 条序列。AlphaFold 3 再分别预测两条结合臂与对应抗原形成的子复合物,两侧 iPTM 取平均。三种格式的平均 iPTM 都高于 0.65,双链抗体最高为 0.72。排名靠前的候选平均覆盖 91.7% 的指定热点(图 4a)。这些结果表明,OFAntibody 可以在更换双抗格式的同时,仍让两条臂结合指定表位。
4.结论
OFAntibody 把结构约束、表位和双抗格式都作为生成条件,从而从设计单个抗原–抗体界面扩展到同时设计多条结合臂。单抗任务表明,晶体结构和大规模蒸馏数据可以帮助模型在指定表位下探索抗体序列和结构。双抗任务则在同一次生成中协调两个界面、分子格式和整体几何,而不必先分别设计两条臂再拼接。目前的结果仍是计算评估,不能代替结合活性、特异性和可开发性实验。模型主要覆盖纳米抗体和抗体片段,实验解析的多界面结构也较少。后续还需要更大规模的结构数据和实验反馈。
5.参考文献
论文链接:https://arxiv.org/pdf/2610.09548

扫描二维码获取
更多精彩
AI in Graph
本公众号主要介绍应用于图、知识图谱的人工智能算法和研究进展,及其在生物信息、医学健康领域的应用。欢迎关注本公众号获取领域最新文献解读。

点个在看+赞支持一下