

本文是「KV Cache 安全」系列总纲。系列含三篇单篇精读:I Know What You Asked(NDSS '25,PromptPeek,调度行为侧信道)· Shadow in the Cache(NDSS '26,KV 数据重建 + KV-Cloak 防御)· Auditing Prompt Caching(ICML '25,商业 API 黑盒审计)。本文只做横向组织与口径提示,机制细节与数字以单篇为准。
三个数字放在一起,能看出同一个机制的三张面孔。PromptPeek 用 60 个请求,读出受害者模板里的性别、年龄、体重、身高四个占位符(p.2、p.11);Shadow in the Cache 在 LLaMA-7B 第一层缓存上把用户输入逐字复原到 BERTScore 1.000(p.6–7);而对 17 家商业 API 的一轮统计审计里,8 家被检出 prompt 缓存、其中 7 家是跨用户的全局共享(p.1、p.6)。
往期文章:
大模型启动,七成时间花在加载权重上:FAST'26 论文用可编程页缓存把延迟砍了 79%
当 KV Cache 装不进内存:FAST'26 五篇论文给出的五个不同答案
当 KV 装不进显存:四篇论文的四种内存账,与一个「统一命名空间 + 成本旋钮」的设想
一、背景:什么是 KV Cache 安全
KV Cache 是推理的中间状态,也是 prompt 的近明文表示:它由用户输入计算而来,可逆程度足以让拿到它的人重建出原文大意乃至逐字内容。在单个用户的私有实例里,这不构成安全问题;而当代推理系统为了省算力,系统性地把这份中间状态变成共享资产——Prefix Caching 与 APC 让不同请求复用同一份缓存块,跨节点传输为 PD 分离在集群里搬运它,分层存储把它写进 CPU 内存、NVMe 甚至远端对象存储。共享越过的那道线就是信任边界;KV Cache 安全关心的,就是这份被共享的中间状态:在哪些位置、可以被谁、以什么精度读到。
沿着缓存的流动路线,常见的「不安全场景」可以直接数出来:
-
• 跨用户复用(多租户推理平台,prefix 共享开启):同一实例上「他人的缓存是否命中」,可以隔着客户端 API 被邻居逐次观测,共享行为本身就是泄露面; -
• 跨节点传输(PD 分离、集群内缓存共享):KV 在链路上以明文出现,路径上的中间节点都是天然的读取位; -
• 分层落盘(CPU 内存 / NVMe / 远端存储):缓存被写进比 HBM 更「够得着」的介质,生命周期也远超单个请求; -
• 托管与服务边界(商业 API、机密计算里被外置的 TEE 缓存):用户与服务商之间隔着信任边界,缓存由服务商侧的架构持有。
攻击者站在哪里,决定了他能读到什么:同一服务上的普通邻居隔着调度读行为;握住缓存数据的人直接重建读数据;只有一根秒表和公开 API 的人靠统计读时延。三种读法,本系列三篇论文各占一种,并把各自的路走到了可定量判决的程度(详见 §二、§三)。把三篇并排看,重点在每层信任边界各自泄露什么、在什么前提下成立。
二、同一个问题,三种问法
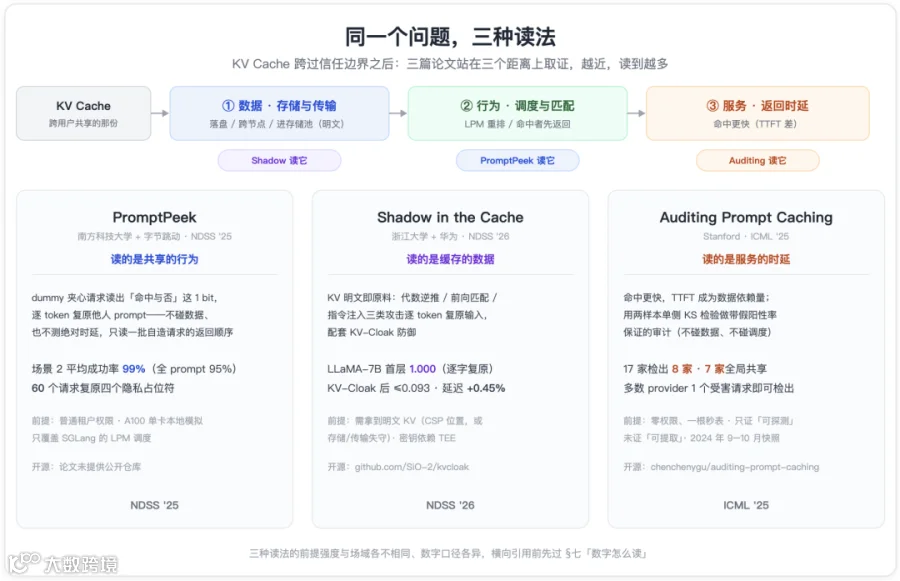
同一份 KV Cache 的三种读法,取证点各不相同:
-
• PromptPeek 读的是共享的行为:SGLang 的 LPM 调度让「命中他人缓存」的请求先被返回,攻击者用自造请求构成图案、把「命中与否」这 1 bit 读成可判定的信号,再逐 token 复原他人 prompt; -
• Shadow in the Cache 读的是缓存的数据:KV 张量接近明文,拿到即重建——三类攻击分别覆盖代数逆推、前向匹配与指令注入,并配套防御 KV-Cloak; -
• Auditing Prompt Caching 读的是服务的时延:不碰数据、不碰调度,只用商业 API 的响应时间做统计审计,判断「跨用户共享是否正在发生」。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
口径说明:数字均为论文自测或自测量,对照基线各不相同,引用前先过 §七「数字怎么读」。
三种读法的前提强度与场域各不相同:PromptPeek 的攻击者权限最低(普通租户),但实验在本地模拟环境;Shadow 的攻击者前提最强(要拿到明文 KV 数据),但把这条路走到了逐字复原并给出防御;Auditing 的攻击面最真实(真实商业 API),但只证明「可探测」、没能证明「可提取」。三篇合起来恰好回答同一问题的三种问法:缓存的「行为」泄露什么、缓存的「数据」泄露什么、缓存的「服务」暴露什么。
三、三种取证位置
3.1 读行为:PromptPeek(NDSS '25)
起点:多租户共享是省显存的主流对策(KV 每 token 约 1 MB、可超模型权重,p.2),而 SGLang 的 LPM 调度让「共享前缀越长越先被服务,哪怕只多一个 token」(p.5)——等待队列因此成为隔着客户端 API 可读的端口。
机制:每轮发出 pre-dummy、候选、post-dummy 三批请求(dummy 批要超过服务端最大批),命中候选恰好嵌在两批 dummy 之间(等匹配长度保持原序,p.6);攻击者只读一批自造请求的返回顺序,不测绝对时延(pp.5–6)。候选由本地模型按已复原片段生成、逐 token 推进,配换靶判据与显存清场完成 prompt 级循环(pp.6–7)。
账本:场景 2(知道模板、复原输入)三数据集平均 SR 99%、场景 3(已知输入反推模板)98%、场景 1(无先验全 prompt)95%(p.2、p.12);>90% 的 token 十次以内猜中,最难的单 token 烧掉 4,093 个请求(pp.10–11);60 个请求复原四个隐私字段(p.11)。GQA 模型(Llama3-8B-GQA)三个场景全部 100%(p.12)。
前提:A100 80G 单卡本地模拟负载(云上 colocation 未验证,p.13);只覆盖 LPM 调度;请求数只计候选请求、成本实验批=1(p.10)。论文归纳出三个攻击条件——缓存持久性、共享可观测(≥1 bit)、客户端控制力(pp.12–13),并给出皆未实现的缓解方向。

3.2 读数据:Shadow in the Cache(NDSS '26)
起点:KV Cache 全程明文是性能妥协(全量加密的延迟不可接受,p.1);在 TEE/机密 MaaS 里,高吞吐架构必须把缓存外置出保护边界,"This architectural design—not a vulnerability—directly exposes the KV-cache to the CSP"(p.2)——对手不需要漏洞,缓存就在他手里。
机制:三类攻击覆盖不同的攻击者能力与代价——Inversion 用权重矩阵做代数逆推(限 MHA 第一层);Collision 把重建变成前向匹配的搜索(通用,跨架构失配即失效);Injection 在截获的缓存后追加 "Repeat the previous content.",让模型把隐私「回声」出来(pp.4–5)。防御 KV-Cloak 用秘密矩阵 + 每块一次性置换 + 加性掩码遮蔽代数与统计性质,全部融进权重、零精度损失(pp.8–10)。
账本:Inversion 在 LLaMA-7B 第一层 1.000/1.000(逐字),GQA 的 8B/3B 失效、1B 例外(pp.6–7);Collision 在 GQA 模型上首层重建最高 0.918,跨架构失配跌回 ≈0.06–0.09、随机水平(pp.6–8);KV-Cloak 后所有攻击 BERTScore ≤ 0.093、成功率 0%、精度逐项无损失,融合实现延迟 15.41 ms/GB = prefill 的 0.45%(pp.11–13)。
前提:攻击者须拿到明文 KV 数据;密钥托管依赖 TEE;量化模型(INT8/INT4)未覆盖;评估是实验室内截获张量后的重建,无真实服务端到端演示(p.13)。

3.3 读时延:Auditing Prompt Caching(ICML '25)
起点:缓存命中更快(TTFT 更小),响应时间因此成为数据依赖量(p.2)——「我的请求是否命中别人缓存过的前缀」可以在纯黑盒下被统计判定。
机制:把审计写成假设检验——两样本单侧 KS 检验、α = 10⁻⁸、Bonferroni 校正;四级递进(同 prompt per-user → 同前缀 per-user → per-org → global),只在上一级显著后升级(pp.3–5)。产出是带假阳性率保证的 p 值,这也是「审计」与「演示攻击」的区别。
账本:17 家商业 API → 8 家检出缓存、7 家跨组织全局共享(含 OpenAI 的 embedding 接口,披露后已修补,p.6);多数 provider 只需 1 个受害请求即可检出(p.6);副产品:从缓存行为推断出 text-embedding-3-small 为 decoder-only 架构(p.8)。缓解四件套:per-user 隔离、披露共享层级、关缓存、时延拉平(p.8)。
边界:2024 年 9–10 月快照(p.6);证明的是「可探测」而非「可提取」(§4.4,p.7);至少 5 家做了修改,但名单未点名(p.9)。

四、对号入座:你站在哪里
|
|
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
五、共同的支点与边界
共同的支点:先把「共享」量成可测的痕迹,再把痕迹做成判决器。 PromptPeek 量的是返回顺序里那 1 bit(命中与未命中的序位差),Shadow 量的是缓存与候选 token 的距离分布(正确 token 是显著离群点),Auditing 量的是命中与未命中的 TTFT 分布(KS 统计量)。三篇的机制各不相同,方法一致:先证明目标痕迹在某个观测面上可测,再把它做成逐次判决的仪器。方法与 04 系列同源:那边先量缺口再设计搬运,这边先量痕迹再设计取证。
第二个交叉点:取证距离的成本账。 三个取证位置对应三档成本,也对应三档信息量,同向递增:一根秒表(Auditing:零权限,只判「共享是否发生」)→ 一个普通租户席位(PromptPeek:请求级成本,复原 prompt 文本)→ 一份明文 KV 张量(Shadow:需要服务商位置或存储/传输失守,逐字复原)。防御的成本也排在相近的轴上:时延拉平(几行代码,丢掉缓存收益)→ 调度随机化与 M-token 门槛(改调度器)→ 块内加密(密钥管理与集成,代价 0.45%)。选防御动作之前,先看自己挡的是哪一档的对手。
攻击面是性能优化的副产品。 三项被利用的机制——LPM 调度、明文共享的 KV 复用、prompt caching——各自都是明确的性能优化,且都默认「缓存可以跨用户边界复用」。三篇的差别只在取证点:行为、数据、时延。
前提强度与现实性各不相同,跨篇结论不要对撞。 三篇针对的框架与内存管理粒度不同(SGLang radix + LPM 的返回顺序;PagedAttention 分块下的暴力猜中率论证;不依赖实现的时延审计),各自的结论只在各自前提下成立。Shadow 论文以 |V|¹⁶ 论证「暴力式侧信道不可行」针对的是盲猜整块的攻击;PromptPeek 走的恰是绕过盲猜的路线(本地模型生成候选 + 顺序判读)——两篇对读时不要把两条结论直接对冲。
缓解都在半路。 PromptPeek 的三条缓解论文未实现;KV-Cloak 是完整方案但未集成、密钥依赖 TEE、浮点之外未覆盖;商业 API 侧只有 per-user 隔离是完全档,且做了修补的 provider 名单未公开。
与 04 系列的分工。内存层级系列算的是「KV 放哪层」的性能账(显存装不下之后,DRAM、互联、调度怎么做交换);本系列算的是「KV 被谁看见」的安全账。同一个 KV Cache,前一个系列关心它放得对不对、搬得快不快,这个系列关心它落在谁的信任域里。串读顺序:先看层级账(缓存会被外置到哪些层),再看本系列(外置出去的每一层各有什么泄露面)。
六、未来方向:从隐式共享到可验证的信任契约
三篇打的是同一件事的三种读数:共享机制的默认值。Prefix Caching、APC、prompt caching 上线时,跨用户复用是默认开着的性能优化;Auditing 的动机一句话点破:provider 宣布了缓存功能,却未必宣布共享层级。三篇的取证点(一根秒表 → 一个租户席位 → 一份明文张量)就是「默认敞开的共享」在三个距离上的读数:越近,读到越多。
如果这个默认值本身可以翻转,三篇的泄露面会整体改变。翻转需要两件东西:
-
• 共享层级,可声明也可验证:Auditing 已经给出成形的仪器:per-user / per-org / global 三级坐标系,加上带假阳性率保证的审计方法。把它从论文方法变成常规工具,共享层级就能像证书一样成为显式契约:provider 声明、第三方验证、用户按需选择。而如今用户在缓存上能控制的,基本只有「开 / 关」这一个布尔值。 -
• 加密,去掉性能借口:KV-Cloak 已经证明,块内自洽的加密不打破 PagedAttention 与调度语义,代价 0.45%;「明文是性能妥协」这个前提在数据面上已经不成立。剩下两个取证面(返回顺序、时延差)也各有低成本旋钮:调度随机化与 M-token 门槛、时延拉平。
一个历史对照:HTTP 到 HTTPS 的迁移也曾困在「加密是性能代价」的论点上,直到工程把成本压到可以忽略,今天没人再谈判这件事。KV 缓存的加密正在复刻这条曲线:数据面的成本已经落到 0.45%,剩下的是密钥的根(KV-Cloak 仍吊在 TEE 上)与习惯。
需要防的一个误读:显式契约不等于泄露消失。缓存跨过信任边界,就必须假设对手在读;契约改变的是默认值(从「默认敞开」到「默认关闭、按需声明」),不是泄露的物理。缓解清单里也只有 per-user 隔离是完全档,这正是契约要把「共享给谁」变成可声明、可拒绝的原因。

七、数字怎么读
-
• PromptPeek:95% / 99% / 98% 是「完全 + 部分复原」合并口径、三数据集算术平均(重算 95.9 / 98.9 / 98.2,论文似下取整);请求数只计候选请求(dummy 不计、成本实验批=1),真实攻击流量高于表中数字;Fig.10–12 的中位数与峰值为读图值;Table II 的 cloze 模板行合计 190 与数据集 180 对不上(论文内部出入,引用保留原样)。 -
• Shadow in the Cache:0.45%(15.41 ms/GB)是算子融合后的口径,未融合版在 b=16(最常见块大小)是 +1.53%;附录 F 的 7.1% → 0.83% 以「从隐藏态重算同一块」为分母,与 prefill 口径不是同一笔账;DP 的正确读法是「有效隐私预算与可用精度不可兼得」,不是「DP 无效」;Table I 与 Table II 的 Distilled 行有内部出入(以正文/Table I 为准)。 -
• Auditing:「8 家」是 provider 口径(表 1 九行、OpenAI 占两行);平均精度是分类器口径、不是攻击成功率;0.03 / 0.1 秒来自表 7 的单次样例,不是全 API 一般值;全部数字限 2024 年 9–10 月。
系列篇目
-
• 缓存命中的 1 个 bit 出卖了你:NDSS'25 PromptPeek 平均 99% 成功率复原他人 prompt——读行为(NDSS '25) -
• 你的 prompt 就存在 KV Cache 里:NDSS'26 三类攻击逐 token 复原输入,KV-Cloak 以 prefill 0.45% 的延迟挡住——读数据(NDSS '26) -
• 0.03 秒命中、0.1 秒未命中:ICML'25 审计发现 7 家 LLM API 跨用户共享 prompt 缓存——读时延(ICML '25) -
• 精读报告(I Know What You Asked: Prompt Leakage via KV-Cache Sharing in Multi-Tenant LLM Serving,逐条页码核对版):PromptPeek · Shadow · Auditing;论文原文 PDF 在 references/papers/
声明
-
• 三篇的数字均为论文自测或自测量,本仓未复现;本文的横向比较跨论文、跨系统、跨时点,除注明外不可直接互比。 -
• 本文每个数字都取自对应单篇精读;各单篇的「诚实声明」列出了自己的口径限定与未核实项(PromptPeek 的本地模拟环境与读图值、Shadow 的 KV 数据前提与 TEE 密钥依赖、Auditing 的 2024 年秋时点)。 -
• 三篇的防御现状与商业 API 共享层级截至各自论文的时点,此后可能已变化。 -
• 「未来方向」一节是展望性论述:由三篇的实测经验与公开背景(HTTPS 迁移史、TEE、主流 API 的缓存开关形态)并读推演而来,不是任一论文的主张,其中的产品与硬件侧细节未按本系列的逐条核对标准核验。
延伸阅读:本仓相关(按主题)
本系列攻的是「共享」这件性能优化本身;共享机制的原理、共享走出的边界、缓存外置的每一层,分别在下面这些文章里。
共享机制本身(被攻击的那几套实现):
-
• Prefix Caching 原理与实现 · RadixAttention 原理与 SGLang 实践及 vLLM APC 对比 · Claude 提示词缓存机制与源码实现深度分析 · RoPE 与 Prefix Caching 的互作用
复用的扩展边界(共享跨出同实例之后):
-
• 当复用跨出同前缀与同模型:两篇论文给出的两条扩展路径 · 把 14B 的 KV 交给 32B:跨模型复用的可能与代价
缓存外置的层级与存储(KV 落在谁的地盘):
-
• 当 KV 装不进显存:四篇论文的四种内存账,与一个「统一命名空间 + 成本旋钮」的设想 · 当 KV Cache 装不进内存:FAST'26 五篇论文给出的五个不同答案 · SGLang HiCache 深读 · LMCache 概览
参考资料
-
• Guanlong Wu, Zheng Zhang, Yao Zhang, Weili Wang, Jianyu Niu, Ye Wu, Yinqian Zhang. I Know What You Asked: Prompt Leakage via KV-Cache Sharing in Multi-Tenant LLM Serving. NDSS 2025. NDSS 论文页 -
• Zhifan Luo, Shuo Shao, Su Zhang, Lijing Zhou, Yuke Hu, Chenxu Zhao, Zhihao Liu, Zhan Qin. Shadow in the Cache: Unveiling and Mitigating Privacy Risks of KV-cache in LLM Inference. NDSS 2026. arXiv:2508.09442 -
• Chenchen Gu, Xiang Lisa Li, Rohith Kuditipudi, Percy Liang, Tatsunori Hashimoto. Auditing Prompt Caching in Language Model APIs. ICML 2025, PMLR 267:20477–20496. PMLR 论文页 -
• 本仓相关:KV Cache 内存层级总纲(04 系列) · Prefix Caching 原理与实现 · FAST'26 KV × 存储五场景