



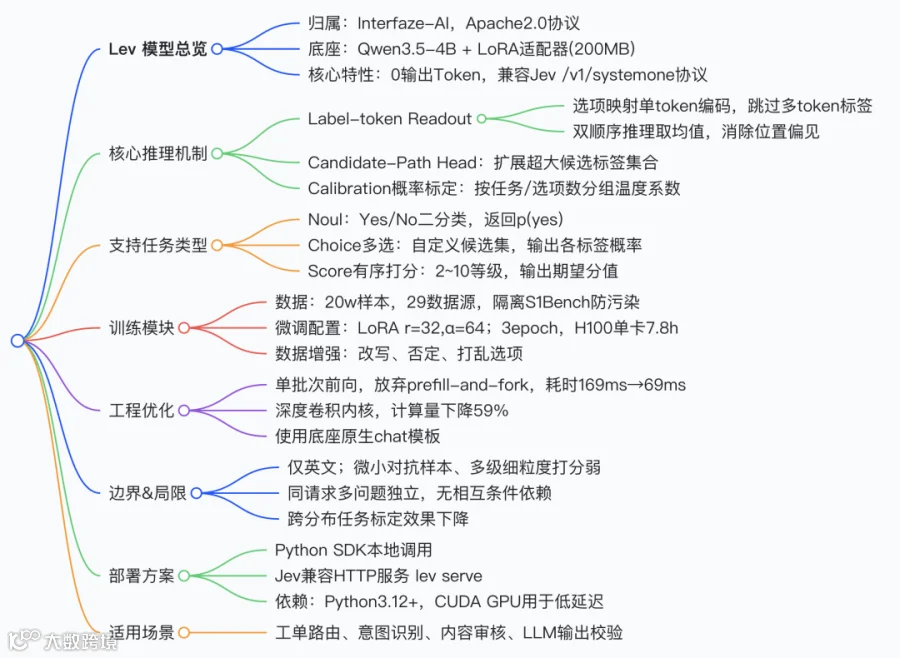
编者摘要:Lev 是 Interfaze AI 开源、基于 Qwen3.5‑4B 底座的 LoRA 决策适配器,对标 TypeSafe 闭源 Jev,核心范式革新在于零输出生成 Token:模型不做文本续写,单次前向推理直接读取标签 token 的 logits,输出经过概率标定的判定结果,专门解决企业内大规模结构化判断任务。
传统 LLM 做分类判定普遍采用 “生成 JSON + 解析 + 重试” 链路,存在生成不稳定、解析异常、多任务串行推理成本高等痛点。Lev 通过 Label‑token Readout 机制,为每个候选选项分配单 token 编码,规避多 token 拆分带来的偏差;通过正反两次选项顺序推理取平均,消除标签位置偏见,可支持多达上百个候选标签。搭配小型 Candidate‑Path Head,进一步突破标签 token 数量上限,适配 Banking77、Clinc_oos 这类百级意图识别场景。训练后按任务类型、选项区间拟合温度系数做概率标定,输出的概率可直接作为业务分流阈值,例如高于 0.9 自动执行,低于阈值流转人工。
模型采用 LoRA 微调方案,r=32,仅训练 Qwen3.5‑4B 的注意力 q/k/v/o 与 MLP 层,适配器体积仅 200MB;单 H100 显卡 7.8 小时完成训练,训练集包含 20 万样本,覆盖意图识别、NLI、内容审核、多选择 QA 等 29 个数据源,严格隔离 S1Bench 测试集,杜绝数据污染。Lev 支持在单次请求内并行提交 Noul(二分类)、Choice 多选、Score 有序打分三类任务,所有问题共享一次前向传播,1 个问题与 8 个问题算力开销几乎不变,短文本模型内部推理仅 69ms。
在 S1Bench 评测中 Lev 综合 Macro 68.9%,在公开子集上性能与 Reflex‑4B 持平,落后 Jev 与 26B~35B 大参数量开源模型;holdout 独立测试集加权准确率 80.7%,Banking77 意图识别达到 98%。但模型存在明确短板:微小文本改动对抗样本、5 级以上细粒度主观打分效果较差,跨分布场景概率标定会衰减,且原生仅支持英文。
Lev 提供兼容 Jev 的 HTTP 服务,原有 TypeSafe SDK 仅修改 base_url 即可接入,支持自托管部署。它并非通用大模型,不能做文本生成、信息抽取,定位是业务判定专用推理引擎。在客服工单路由、内容审核、LLM 输出校验等高吞吐场景,Lev 相比常规 LLM+LoRA 分类方案,大幅减少生成与解析错误,在 4B 小模型硬件成本下,提供可信任的标定概率,为企业落地轻量级判定智能体提供新范式。
Lev 生产落地 Checklist
✅ 阶段 1:前期评估
-
业务场景确认:任务限定为二分类 / 多选 / 有序打分,不需要文本生成、抽取 -
语言确认:业务文本为英文;多语言场景不适用 -
候选标签评估:标签集合稳定,不会频繁大量新增标签 -
延迟 & 吞吐评估:预估 QPS,确认单 H100 能否承载;CPU 仅离线批量使用 -
风险评估:业务是否强依赖概率阈值自动放行;高风险场景必须人工兜底
✅ 阶段 2:数据校验
-
自建 holdout 测试集,完全独立于训练数据 -
覆盖困难样本:文本微小修改、边缘 case、OOD 离群样本 -
标签一致性校验:标签定义清晰,标注者一致性达标 -
数据集规模:至少几百条业务真实样本,用于标定与验证 -
污染检查:测试数据不能和 S1Bench、Lev 训练数据源重合
✅ 阶段 3:概率标定与阈值验证
-
在业务 holdout 集上计算 ECE 期望标定误差 -
测试不同标签数量下概率稳定性 -
阈值扫描:绘制 PR 曲线,确定自动放行 / 转人工分界值 -
OOD 样本测试:检验域外输入的概率漂移情况 -
定期重标定:业务分布漂移后,重新评估概率可靠性
✅ 阶段 4:压测与部署
-
HTTP 服务压测:并发请求、批量多 question 请求(单请求最多 8 个问题) -
延迟基准:记录 P50/P90/P99 端到端延迟 -
批处理测试:验证多 question 共享单次前向的性能收益 -
资源监控:GPU 显存、利用率、内核加载冷启动耗时 -
健康接口 /health接入监控告警
✅ 阶段 5:风险点与运维
-
限制:同请求多个判定任务相互独立,如需联合决策要合并 choice -
降级策略:模型超时 / 异常时,自动切人工兜底 -
版本管理:锁定 adapter、校准文件、tokenizer 版本 -
定期评估:月度在新业务样本上复测准确率、ECE -
合规检查:核查训练数据集许可证,商用场景确认版权约束。 横向对比表:Lev / Jev / Reflex / 普通 LLM+LoRA 分类
-
对比维度 Lev (Interfaze 开源) Jev (TypeSafe 闭源) Reflex-4B 普通 LLM+LoRA 分类(生成 JSON) 核心范式 0 输出 Token,logit 直接读取标签 0 输出 Token,闭源架构 0 输出 Token 决策模型 生成文本 JSON,后解析 底座 Qwen3.5-4B LoRA 闭源 4B 基础模型 任意 LLM+LoRA 微调 开源状态 适配器 Apache2.0 闭源 API 开源 开源 S1Bench Macro 68.9% 76.1% ≈69% 视底座而定,通常低于上述专用决策模型 概率标定 支持,ECE=0.115 优秀,ECE=0.091 带标定 大多无专门标定,概率不可靠 单请求多任务 ✅多问题共享一次前向,算力几乎不变 ✅支持 ✅支持 ❌串行,每任务单独推理 候选标签上限 数百标签(label-token + 候选头) 高 较高 受生成长度限制,长标签不稳定 典型延迟 (短文本) 容器内 69ms;端到端 414~654ms 335~346ms 中位数 相近 更高,包含生成 + 解析开销 协议 兼容 Jev SystemOne 协议 SystemOne 原生 自定义 无统一协议 语言 仅英文 仅英文 英文 可多语言 主要短板 微小对抗样本、多级细粒度打分弱 闭源,无法本地部署 对抗样本能力有限 JSON 解析失败、生成幻觉、重试开销、概率不可信 部署方式 自托管 GPU 托管 API 自托管 GPU 自托管 GPU 适用场景 工单路由、意图、审核、LLM 校验 高价值业务判定 API 轻量本地判定 通用分类,低可靠性阈值场景
附录:Lev 模型完整解读(interfaze-ai/lev)
一句话定位
Lev 是基于 Qwen3.5-4B 的 LoRA 适配器决策模型,属于 Jev 兼容的 System One 决策模型。最大特点:零输出生成 Token,单次前向推理,直接从 logits 读出标定后的概率,专门做批量业务判断(路由、内容审核、意图识别、工单分级、LLM 输出校验)。
核心口号:Zero output tokens,没有生成、不用解析 JSON、无需重试
一、基础信息
-
底座:Qwen3.5-4B + LoRA(LoRA r=32, α=64,只训练 attention q/k/v/o + MLP) -
参数量:主干 4B,LoRA 适配器仅~200MB -
硬件训练:单张 H100,7.8 小时完成训练,3 个 epoch,18750 步,batch=32,lr=5e-5 -
协议:兼容 TypeSafe /v1/systemoneprotocol,原有 TypeSafe SDK 改 base_url 即可对接 -
许可证:Apache-2.0(适配器;训练数据集部分有单独协议,商用需自查数据集) -
语言:仅英文 -
依赖:Python ≥3.12,CUDA GPU 用于低延迟推理;CPU 可跑但延迟为秒级,无法实时
二、支持 3 类问题类型(一次请求可并发多个问题,共用一次前向)
- Noul(Yes/No 二分类)
返回 p (yes) 概率 - Choice 多选
自定义候选选项集合,返回每个选项概率、置信度;输出只能限定在你提供的选项集合内,不会出现外部标签(结构保证,不代表结果一定正确) - Score 打分
2~10 个有序等级,返回期望分值、各等级概率、置信度
关键特性:同一个 state 上下文,一次性丢入 N 个问题,计算开销几乎不变。1 个问题和 8 个问题推理成本基本一致;60 个候选选项的分类,开销和简单 yes/no 一样。
示例场景(官方 Demo)
客户工单文本:Hi, I was charged twice for my order #4471 and I want a refund.一次性同时提问 3 个任务:
-
intent(多选:退款 / 取消 / 查物流 / 其他) -
urgent(二分类:一小时内是否需要人工介入) -
frustration(4 级情绪打分:平静→轻度烦躁→烦躁→愤怒)
返回结果:
output_tokens=0,直接拿到各标签标定概率。
三、底层核心技术原理(Why it works)
1. Label-token readout 标签令牌读取(最核心创新)
给每一个候选选项分配单 token 编码,跳过会被拆成多 token 的编码。模型不生成文本,直接读取这些预设标签 token 对应的 logits 作为答案。
-
解决位置偏置:两个不同选项顺序做两次读取,结果取平均,消除选项排序带来的 bias -
上限:可支持数百个候选标签(如 Banking77 77 个意图分类)
2. Candidate-path head 候选路径头
一个小型额外学习头,把上下文 state 和每个选项文本做匹配;用来支撑超大候选集,不被 token 读取方案限制死。
3. 后训练概率标定 Calibration
训练后拟合温度系数,按【问题类型、读取模式、选项数量区间】分组设置温度; 目标:概率可靠可落地,业务上可以直接用阈值做自动化放行 / 转人工
指标:S1Bench 上 ECE=0.115(Jev 0.091),在 13 个子集里 5 项标定效果优于 Jev。
4. 关键工程优化(大幅度降延迟)
- 单批次前向,放弃 prefill-and-fork
推理耗时从 169ms 降到 69ms;该模型瓶颈是内核启动开销,不是浮点计算量 -
深度卷积内核:总计算量减少 59% -
过滤会被分词拆成多 token 的标签编码:Banking77 精度从 0.818 提升至 0.98 -
复用底座原生 chat 模板做 prompt 封装,冻结底座时基准提升 5.7 个点
四、训练数据
-
20 万样本,来自 29 个数据源、26 个 HuggingFace 公开数据集 -
任务覆盖:意图识别、NLI、复述检测、多选 QA、毒性审核、有用度评分 -
数据增强:问题改写、否定改写、打乱选项、调整选项数量 - 污染防护:训练集严格排除 S1Bench 的 13 个子集,测试集完全隔离
五、Benchmark:S1Bench(13 个子集,macro 68.9%)
-
Lev macro:68.9%;Jev macro:76.1% -
在公开 6 项榜单上,Lev 性能和 Reflex-4B 持平,仅次于 Jev 以及 3 个 26B~35B 开源模型 -
优势子集:MNLI 自然语言推理、Helpsteer2 有用度评分 - 明显短板
微小编辑对抗样本(PAWS、VitaminC)、长摘要一致性打分 Summeval-consistency;精细 5 级评分任务效果差,部分场景简单 “总是预测最多类别” 的基线都能超过模型 -
独立 Hold-out 测试集:加权准确率 0.807,ECE=0.061;Banking77 (77 意图) 0.98,Clinc_oos (151 意图) 0.968,FEVER 事实核验 0.872
统计说明:子集之间 5~9 个点的差距才是真实显著差异,小于这个区间视为噪声。
延迟指标
短文本请求纯模型计算:69ms(容器内) 端到端:H100 单卡 Modal 部署,两次测试中位数 414–654ms;Jev 托管 API 中位数 335~346ms
六、边界与局限性(非常重要,生产落地必看)
- 微小改动、细粒度多级打分能力弱
文本仅替换单个词 / 数字的对抗样例容易出错;超过 5 级的精细评分不准 -
标定依赖训练分布:完全异于训练分布的任务,概率标定会失效,上线前必须用自有数据校验阈值 -
同一个请求内多个问题相互独立,答案之间不会互相条件依赖;若需要联合决策,需要合并成单个 choice 问题或多轮调用 - 仅英文,不支持其他语言
-
CPU 推理延迟极高,实时业务必须 GPU -
只能做判断打分分类,不能做文本生成、抽取、搜索(区分于 Interfaze 主平台)
区分 Lev vs Interfaze 托管平台:
-
Lev:本地自托管,0 输出 token,仅分类判断; -
Interfaze 托管 API:混合 token 输出,除分类还支持 OCR、检索、信息抽取、结构化 JSON 输出
七、部署方式
1. 安装
pip install "lev[serve] @ git+https://github.com/Abhinavexists/lev#subdirectory=packages/lev"
自动拉取 Qwen3.5-4B 底座(约 8GB)+ Lev LoRA 适配器(200MB)
2. Python SDK Quickstart
import lev
model = lev.load("interfaze-ai/lev")

state = "Hi, I was charged twice for my order #4471 and I want a refund."
questions = {
    "intent": {
        "type": "choice",
        "instructions": "What does the customer want?",
        "criteria": {
            "refund": "wants money back",
            "cancel": "wants to cancel an order",
            "track": "wants to know where an order is",
            "other": "anything else",
        },
    },
    "urgent": {"type": "noul", "instructions": "Does this need a human within the hour?"},
    "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["calm", "mildly annoyed", "annoyed", "angry"],
    },
}

result = model.system_one(state, questions)
print(result.answers["intent"].choice)
print(result.answers["intent"].probabilities)
print(result.usage.output_tokens) # 0
3. 自托管 HTTP 服务(兼容 Jev 协议)
lev serve --checkpoint interfaze-ai/lev --host 0.0.0.0 --port 8000
直接调用 /v1/systemone,TypeSafe SDK 无缝切换;提供/health健康接口,支持批量、并发请求,非法参数返回 422。
八、适用业务场景 & 不适合场景
✅ 适合
-
客服工单路由、优先级分诊、用户意图识别(Banking77 这类多标签意图很强) -
内容安全 /moderation 毒性判断 -
LLM 输出结果校验(事实、合规检查) -
大批量、高吞吐的固定选项判断,需要可信赖概率阈值做自动 / 人工分流 -
低资源 4B 模型,单 H100 部署,一次性并行多个判断任务
❌ 不适合
-
多语言任务 -
需要文本生成、长文本抽取、检索增强 -
细粒度多级主观打分(>5 级) -
对抗性微小文本差异判断 -
对跨分布场景直接信任概率阈值(必须重新标定)
九、Lev 和 Jev 对比简表
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|