大数跨境

开源成了一门生意:具身模型密集放模型、权重、数据——谁真给了,谁只给了个说法?

开源成了一门生意:具身模型密集放模型、权重、数据——谁真给了,谁只给了个说法? 机器人产业应用
2026-10-16
8
导读:什么才是真正有价值的开源?


作者:陈钶  


从9月开始,具身模型近期扎堆宣布开源,这篇给你讲讲谁是真开源。

9月3日,大晓机器人带着 Puffin-World 的论文与配套数据率先亮相;

9月6日,新加坡国立大学、清华大学、北京大学等高校联合团队放出 OpenWAM 代码库及预训练、微调权重;

9月7日,智象未来发布 HiDream-O1-Embodied,首次参评即在 RoboColiseum 扰动适应子榜登顶;

随后一周,小米把 Xiaomi-Robotics-U0 的 4B 与 Sequence 系列权重、FSDP 训练代码补进仓库,蚂蚁灵波补齐了 LingBot-World 2.0 的剩余模型变体,宇树开源了 6B 的 UnifoLM-WLA-1.0;

9月中旬,智元机器人公布 GE-Act 2.0 的数据规模化研究,Zero-WAM 也代码、模型和 HumanGen 数据一一兑现;

9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action……

这些新闻在普通读者完往往记住的就是一句话:某某具身模型开源了。

但仔细查看项目页面会发现,同样宣称“开源”,它们交出来的东西却千差万别:

有的开放了代码、权重、训练说明和测评脚本;有的只提供可以下载的模型;有的给出整套研究栈;有的只给权重,而非训练数据;还有人只给了一张时间表,表示代码和权重“Coming soon”……

对于开发者,对于要把模型装进机器人、接控制器、换本体、跑现场的人来说,这些不同的“开源”背后真正能拿走的内容相差很大,而这些差异会反映到实际的工程成本上,差着几周甚至几个月的工作量。

所以真正值得看的,不是谁先喊着“开源”,而是谁把承诺变成了别人能下载、能运行、能复现的东西。

更有意思的是,“开源”这个词正在被拆开重新标价。


01

给开源分四级:从完整交付到尚待兑现


判断一个模型是不是真“开源”,要看开发者实际能够获得什么,又能使用到什么程度。

在作者看来,一个模型的开源可用度,主要由五部分决定:

1、代码:训练、推理等核心代码是否公开;
2、权重:模型权重是否可以实际下载;
3、数据:数据或数据配方是否可用,提供的是原始数据、数据配方,还是只有一句规模描述;
4、许可证:是否允许研究、修改,以及在目标场景中使用;
5、复现流程:训练配置、评测脚本和实验协议是否齐全。

这些决定了一个项目能不能运行和修改、能不能还原训练过程,又能不能进入商业应用。

由这五部分构成的“开源”呈现木桶效应,缺少一项就会让效果大打折扣。

权重没有,模型跑不起来;代码没有,想改都没入口;数据没有,训练过程很难还原;许可证写着NonCommercial,企业更不可能因为仓库是 Public 就直接拿去上产线。


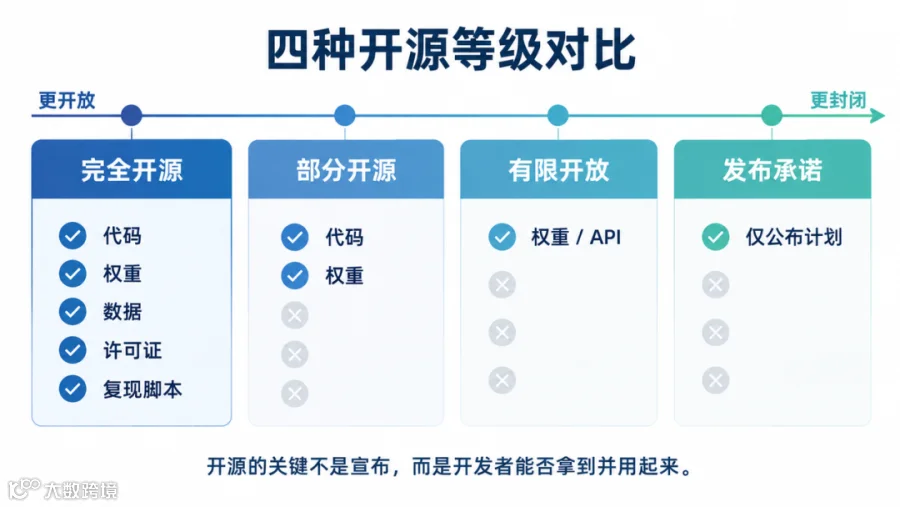
为了方便把近期扎堆开源的模型放在横向比较,基于上述内容,我们把“开源”程度做了个简单分级:

最开放的第一级,是代码、权重、数据和许可证都能找到,最好还配有训练脚本、推理说明和评测协议。这是最接近完整开源的形态。

第二级,是代码和权重开放,但训练数据不开放,或者只公布数据配方,不提供原始数据。开发者可以运行模型,却无法完整复现实验。

第三级,是只开放模型权重或API。它对体验和二次开发有帮助,但更像模型发布,而不是完整开源。

第四级,是新闻稿里写“将开源”“全面开源”,但仓库还没有更新,权重仍然显示Coming soon。它可能代表团队确实有开放计划,但在开发者真正下载之前,仍然只能算开源承诺。

有了这个分级表,以后再看到某企业宣传模型开源,你就可以对照看他们具体开放了哪些,到什么程度。

GitHub 上有个公开仓库只是起点,距离“这是一套可复用的开源系统”,还隔得很远。

02

逐个核对模型开源表:谁已交付,谁还在预告?


把9月这些项目按一手页面重新排一遍,会发现这不是一波整齐划一的“首发潮”,更像一群项目在不同位置补票:有人第一次开门,有人把之前没放的权重补上,有人把训练代码补出来,也有人只是把“以后会放”写得更明确。

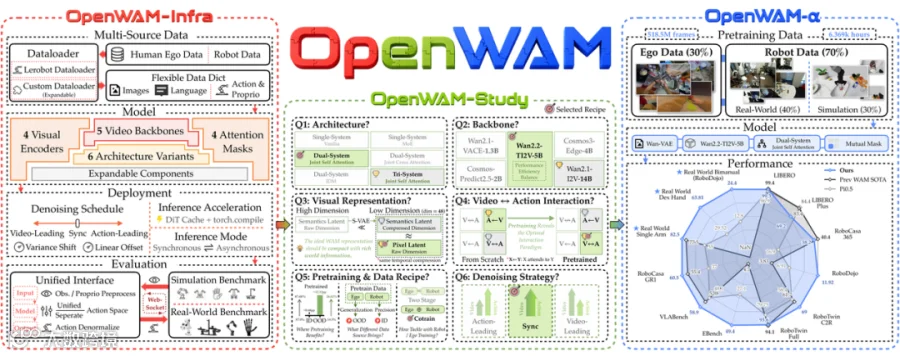
先看 OpenWAM,它是由新加坡国立大学、清华大学、北京大学等多所高校联合团队开发的一款开源机器人学习框架及预训练模型系列。官方仓库记录得很清楚:9月6日代码库发布,同时放出预训练和微调模型;论文在9月9日上线。OpenWAM-α 的预训练规模约为5.185亿帧、约6400小时的人类第一视角与机器人数据,项目采用 Apache-2.0。它真正值得注意的,不只是“又一个 WAM”,而是把模型架构、训练、部署、评测这些原本容易散落在论文附录里的东西,尽量收进同一个研究栈里。


但即便是 OpenWAM,也要把“公开数据配方”和“原始训练数据全部可下载”分开。方法能复用,不代表别人能原样凑出同一批6400小时数据。这个区别很小,却恰恰决定了“能研究”和“能复现到同等规模”是不是一回事。

9月7日,HiDream-O1-Embodied(智象未来)发布,并在 RoboColiseum 的 Robustness(扰动适应)子榜以0.692的平均分拿到当时的第一。这个成绩可以说明它在这套扰动评测里表现很强,但在我核对到的公开发布材料里,重点仍然是模型能力、训练思路和榜单结果,而不是一套“代码—权重—数据—许可证”完整清单。把它叫“模型发布”很准确;直接和完整开源画等号,就容易把两件事混在一起。

小米的情况又不一样。Xiaomi-Robotics-U0 (小米)的技术报告、主模型权重和推理代码在7月就已经发布;9月官方仓库新增的是4B与 Sequence 系列权重,以及 FSDP 训练代码。也就是说,9月对它更像一次“把门再推开一截”,而不是从零开始的首发。这个细节很重要,因为它说明未来的开源未必是一个发布日,而可能是一串持续更新的 commit。

9月11日,UnifoLM-WLA-1.0(宇树)的仓库新闻区明确写了 UnifoLM-ER-1 和 ER-Flow 两套权重发布。与此同时,它的 Open-Source Plan 里仍列着后训练代码、UnifoLM-WLA-Base 和若干数据集条目。项目本身是6B参数,官方称训练使用约2500小时高质量真机数据、统一覆盖64项任务;但“训练用了2500小时”和“2500小时训练数据已经全部开放下载”,显然不是同一句话。


更有意思的是许可证。UnifoLM-WLA 仓库使用 CC BY-NC-SA 4.0,其中 NonCommercial 写得很明确。于是一个特别典型的场景出现了:仓库是公开的,研究可以做,企业商用却不能只凭“开源”两个字往下走。

Puffin-World (大晓机器人)则把另一个容易混淆的词摆到了台面上:数据。论文在9月3日提交,并明确写到代码、模型和数据已发布;Puffin-16M 的确很大,但它主要是 camera-centric 的物理世界与3D建模数据——约1533万组图像-文本-相机样本,再加约113.7万条相机轨迹。它不是“1600万条机器人真机操作轨迹”。数字一样很大,数据的含义却完全不同。

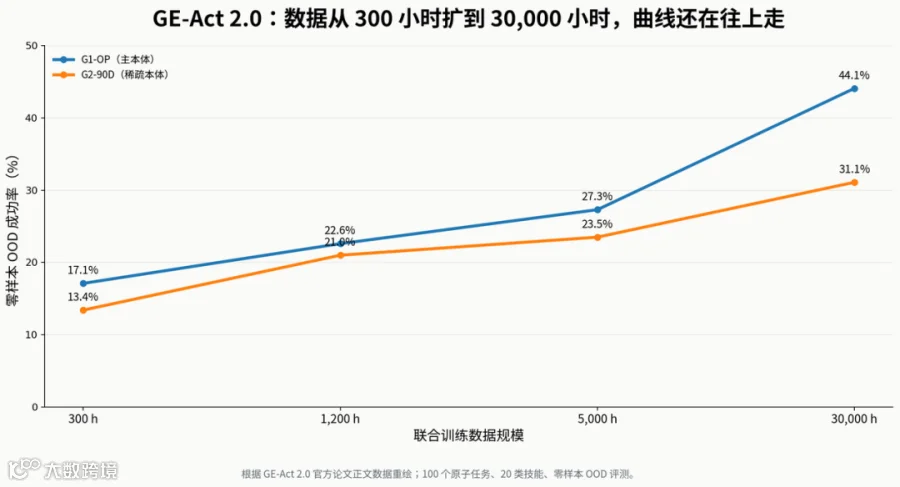
GE-Act 2.0 (智元机器人)可能是这轮里最适合拿来讲“数据 scaling”的项目:从300小时一路扩到3万小时,G1-OP 的零样本 OOD 成功率从17.1%上升到44.1%,G2-90D 从13.4%升到31.1%。但同一张官方项目页上,Code 后面现在仍然写着 Coming soon。换句话说,它是一项很有价值的公开研究结果,却不该因为“论文公开了”就自动归进“代码已开源”。

LingBot-World 2.0 (蚂蚁灵波)也不是9月才第一次出现。它在7月已经发布技术报告、推理代码和部分模型;9月10日补齐了剩余模型变体。Zero-WAM 则刚好相反:8月底仓库曾把“9月15日前发布代码、模型和 HumanGen 数据”写成明确计划;再回头看现在的官方仓库,代码、两套模型入口以及 HumanGen 的公开子集已经落地。这个过程特别适合拿来理解什么叫“开源兑现”。

所以这张时间表最值得看的,不是谁在同一天喊得最响,而是谁把承诺一点点变成了可以下载、可以运行、可以检查的东西。


03

最难开放的不是权重,是昂贵的真机数据


为什么代码和权重越来越容易开放,真机数据却总是最谨慎?

原因很简单:前两者复制起来太便宜,后者生产起来太贵。

一个模型权重可以从服务器复制无数份;一套代码也可以被无数人fork。真机数据背后却是一整套物理世界:机器人本体、遥操作设备、场景搭建、人工复位、故障处理、数据清洗、隐私脱敏、存储和长期维护。

很多数据里还藏着团队最难复制的工程经验——哪些失败值得留、什么时候接管、怎样标动作、怎样把不同本体的数据对齐。

GE-Act 2.0 的 scaling 曲线为什么有产业讨论价值?不是因为44.1%这个数字本身有多“炸”,而是因为从5000小时继续扩到3万小时后,曲线仍然明显往上走。至少在它的实验范围里,还看不到“数据已经喂够了”的迹象。

这说明,数据仍是模型能力增长的重要来源。也正因如此,当一个项目只开放训练完成后的权重、却没有同步开放训练数据时,开发者拿到的是结果,却未必拿得到复现和继续扩展这一结果的关键条件。

这就让开源呈现一个很微妙的结构:模型越来越像加工好的成品,真正稀缺的反而是原材料。

你可以把成品拿回去用,但如果没有原始数据、失败样本、接管记录和统一标注体系,就很难回答一个关键问题——这个模型到底为什么有效?是架构占了主要功劳,还是数据覆盖足够广,还是训练里还有一堆没有写进 README 的工程手艺?

即便项目宣布开放数据,也还要继续追问:开放的究竟是哪一类数据?人类视频、真机轨迹、仿真轨迹、相机运动、失败rollout和动作标签?它们都可以被称为数据,但它们对机器人学习的价值完全不是一个维度。

所以,以后再看到“XXM 数据集”,第一反应不用被数据量吓到,可以先问一句:你这M到底数的是什么?


04

开源不是做慈善,模型换适配,开放换生态


既然最贵的数据舍不得全放,模型公司为什么还积极开源?

因为这笔账实际算起来不一定亏,开源可以降低模型进入更多机器人和应用场景的成本。

具身模型不能脱离硬件独立工作。它得接相机、接关节、接动作空间、接控制器,还要适配不同的机械臂、灵巧手和移动底盘,而只靠一个团队很难自己去完成十几种本体适配。开放代码和权重之后,更多开发者可以参与接入、测试和改进,相当于用模型能力换外部适配的工程工作量。

开源换来的还有人才、生态伙伴和技术标准。一个模型如果被更多整机厂、集成商和研究团队采用,它的动作表示、数据格式、接口设计甚至评测习惯,都更容易变成事实标准。谁让别人最省事,谁就更可能把自己的技术选择变成行业的默认选项。

因此,开源不只是发布可以下载的文件,也是在争取开发者、生态伙伴和技术标准的话语权。


从这个角度看,开源更像一笔价值交换:团队开放模型、工具和部分资产,换回适配、反馈、采用、合作机会,以及下一轮标准的话语权。


05

参数量很显眼,但真正让企业停下来的,常常是一行 LICENSE


发布会上,4B、6B、14B、34B这些模型参数都很抢眼,但到了企业技术尽调,最可能把项目拦住的不是参数量,而是许可证。

OpenWAM 用的是 Apache-2.0,这类许可证对复用和商业使用相对清晰。UnifoLM-WLA 和 LingBot-World 2.0 的仓库则采用 CC BY-NC-SA 4.0,NonCommercial 直接写在名字里。Puffin-World 使用的是 NTU S-Lab License 1.0 这类自定义许可,更需要把条款逐段看清楚。

这就是为什么“公开仓库”不能简单翻译成“企业可用”。

企业真正要确认的是:权重能不能商用,代码和数据是不是同一个许可证,衍生模型怎么处理,部署输出有没有额外义务,第三方数据又带着什么限制。

哪怕模型本身免费,只要其中一个关键资产的授权不清楚,法务和采购就可能直接把项目停在 PoC 门口。

因此,开源的含金量也不该只看 Star、下载量和榜单成绩。进入真实业务之后,版本维护、漏洞修复、兼容性、责任边界和升级路径都比“第一天能不能跑”更重要。

模型免费以后,软件价值不会凭空消失,只会往更具体、更麻烦的地方挪:数据清洗、本体适配、动作空间转换、仿真、安全控制、部署调度、现场运维。底座便宜了,最后一公里反而更清楚地露出来。


06

最重要的是开源兑现率


Zero-WAM 有个细节我很喜欢:它曾把代码、模型和 HumanGen 数据的发布时间写得很具体——9月15日前。这个做法的妙处在于,开源从一句态度表态,变成了一个可以回头检查的承诺。

现在再回到它的官方仓库,已经能看到代码、安装说明、模型入口和 HumanGen 公开子集。这个项目未来好不好用,还要继续看;但至少“说什么时候放”和“后来到底放没放”之间,形成了一条可以核验的链。

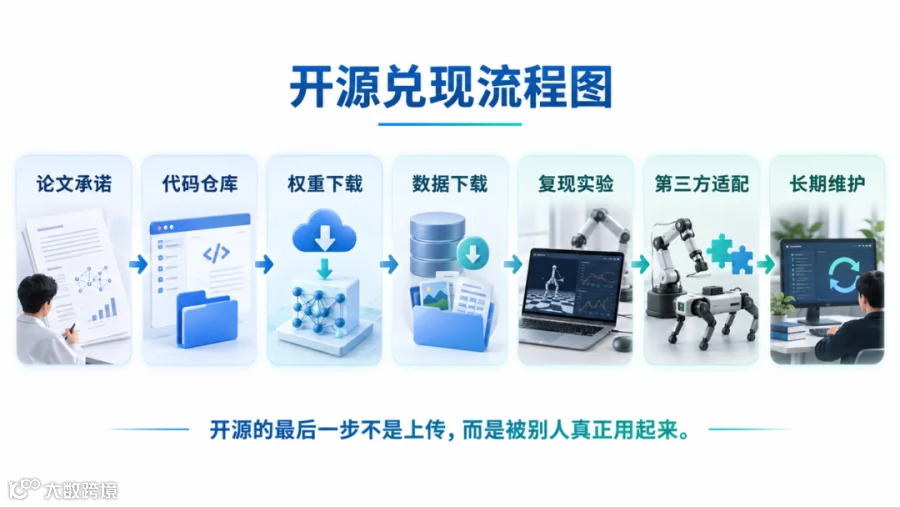
我愿意把这种东西叫“开源兑现率”。它不是严格的学术指标,也没必要硬算成一个百分数。它更像开发者心里的一本账:论文之后多久有代码,代码之后多久有权重,数据是不是能真的下载,许可证是不是写清楚,复现实验有没有人跑通,仓库半年以后还有没有人维护。

真正成熟的开源,不是上传完文件、按下 Publish 就结束。它得继续回答那些最不性感的问题:怎么安装,怎么训练,怎么换机器人,怎么排错,版本冲突怎么办,结果对不上怎么办,半年后依赖炸了谁来修。

所以开源的最后一步从来不是“我把东西给你了”,而是“你真的接得住”。


07

结语:免费的模型,可能把价值推向更贵的数据和更难的工程


最近这波具身模型更新,表面看是模型越来越多,往里看其实是行业开始争夺“基础设施”的位置。代码、权重、推理框架越容易获得,后来者从零起步的必要性就越低;与此同时,差异也会被挤到那些更难复制的地方:数据、仿真资产、本体适配、失败恢复和现场经验。

这也是为什么“开源会不会把软件公司都卷没”可能问错了。更可能发生的是,基础能力越来越便宜,但把基础能力变成可靠产品的工程越来越值钱。

以后再看到一条“全面开源”的新闻,也许最值得做的不是立刻转发,而是顺手点进仓库看三分钟:权重在哪,数据在哪,LICENSE 写了什么,README 里的 TODO 还有几项。

开源不是把东西扔到网上,而是把一条别人能走通的路铺出来。GitHub 上多一个文件夹不算终点;另一支团队把机器人真正跑起来,才算交付。

真正有价值的开源,不是让大家看到你有什么,而是让别人拿走之后,真的能把机器人用起来。


连界创新


推荐阅读


产业应用场景


·出海!中国具身智能企业在全球市场大“杀”四方!

·比人形更快进入家庭?具身智能宠物机器人迎爆发!

·文娱巨星!人形机器人“表演大乱斗”,谁赢了?

·商业导览成具身智能商业化破局点?

·巡检机器人之困,场景刚需,但这一问题亟待解决


机器人本体企业


·仿生机器人=伴侣机器人?一文为仿生机器人正名!

·乐聚Taskor,为人形机器人规模化进厂按下“快进键”

·具身智能争霸赛打响!四大核心区都有哪些“扛把子”?

·CES 2026|星动纪元携人形机器人家族亮相

·智元CES放大招!开源Genie Sim 3.0强的可怕!


供应链动态


·零部件企业跨界突围!这些企业上大分!

·夺取物理世界的入场券:具身智能操作系统拆解

·人形机器人关节生死局:执行器路线之争与技术博弈

·灵巧手赛道“激战”,新老玩家各执什么王牌?
·开源数据集图鉴!这份具身智能“军火库”请查收

【声明】内容源于网络
0
0
机器人产业应用
由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
内容 589
粉丝 0
机器人产业应用 由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
总阅读6.7k
粉丝0
内容589