


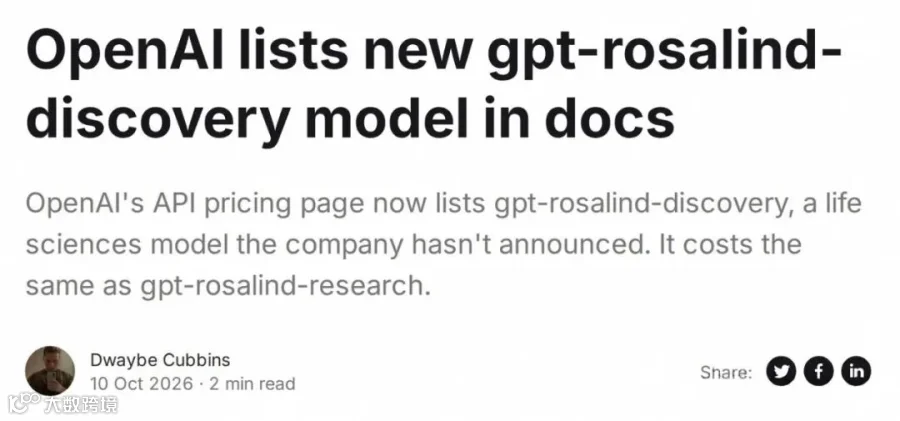
图1|OpenAI API 定价页面出现全新模型
当地时间 10 月 10 日,OpenAI 的 API 价格页上出现了一个并未正式发布的型号—gpt-rosalind-discovery。它被归在“生命科学模型”里,紧挨着 gpt-rosalind-research。两者定价完全相同:输入每百万 Token5 美元、缓存输入 0.5 美元、输出 25 美元。
OpenAI 尚未公开说明 Discovery 的具体用途、技术指标、评测结果或正式可用状态。因此,这一名称更适合被视为 Open AI 生命科学产品线可能进一步扩展的信号,而不能直接证明 Open AI 已组学能够经正式发布了一款专门负责药物发现的新模型。以下分析,将官方已经公布的信息与基于产品布局的趋势判断分开讨论。
要理解 GPT-Rosalind Discovery,首先需要把它放回 OpenAI 的整体生命科学布局中。
从目前已经公开的信息来看,OpenAI 正在逐步形成一套由模型、工具和工作空间组成的生命科学产品体系,并呈现出三个层次。
从最初的研究预览版,到基于 GPT-5.5 训练的新版本,GPT-Rosalind 持续强化药物化学与基因组学能力,并通过可信访问计划向相关机构开放。
OpenAI 成立 OpenAI for Science 专属团队,并与 Ginkgo Bioworks 等机构探索将 AI 与自动化实验室结合,让 AI 负责实验设计,机器人负责执行,从而形成“模型设计—实验验证”的闭环。与此同时,Rosalind 的应用方向也进一步延伸到生物安全等领域。
OpenAI正逐渐形成 “GPT-Rosalind 模型 + Rosalind Workbench研究空间+ 科学工具与 Skills” 的产品结构,将模型与科研数据、分析工具和研究流程连接起来。
因此,OpenAI 的战略方向可以概括为:从提供一个专业模型,走向提供一套以模型为核心、以科学工具为执行能力、以科研工作流为组织方式的研究平台。
这也解释了为什么理解 GPT-Rosalind Discovery,不能只盯着一个模型名称,而要观察整个 Rosalind 产品体系。
•模型:负责理解问题、推理、规划和解释结果
•工具:负责读取数据、执行分析、处理科学对象或展示结果
•Skills:将特定任务的方法、步骤和工具使用方式组织成可复用的工作流程
如果只看模型名称,很容易把 GPT-Rosalind 理解为一个生命科学聊天机器人。但从已经公开的 Rosalind Workbench 来看,整个体系的能力并不只来自模型本身。
三类科学数据查看器
•分子结构查看器:查看蛋白与小分子构象、结合位点与结构特征。
•生物序列与比对查看器:序列比对、变异分析,关联序列变化与蛋白功能。
•组织切片查看器:辅助定位病理切片重点区域,结合 AI 做图像分析与人工复核。
三类查看器的重点是结构、研究问题和解释过程能够在同一个环境中关联起来。
NGS 分析工作台
基因组学是目前最成熟的落地方向。NGS Analysis Workbench 覆盖 FASTQ 质控、常规 RNA 测序、单细胞 RNA测序等任务,自动协调工具、生成分析方案、输出可校验结果。

图2|基于MultiQC 的 NGS 数据质控评估
分子设计、结构分析与候选分子比较
包括小分子与目标蛋白质结构对接分析、检查排名靠前的候选结合构象、分析候选分子与蛋白质之间的相互作用、比较分子性质和结构-活性关系。
Skills
如果把成熟的分析流程,例如测序分析、靶点评估流程等,配置为可复用的Skills,那么下一次执行类似任务时,只需要调整参数并审核关键节点即可。
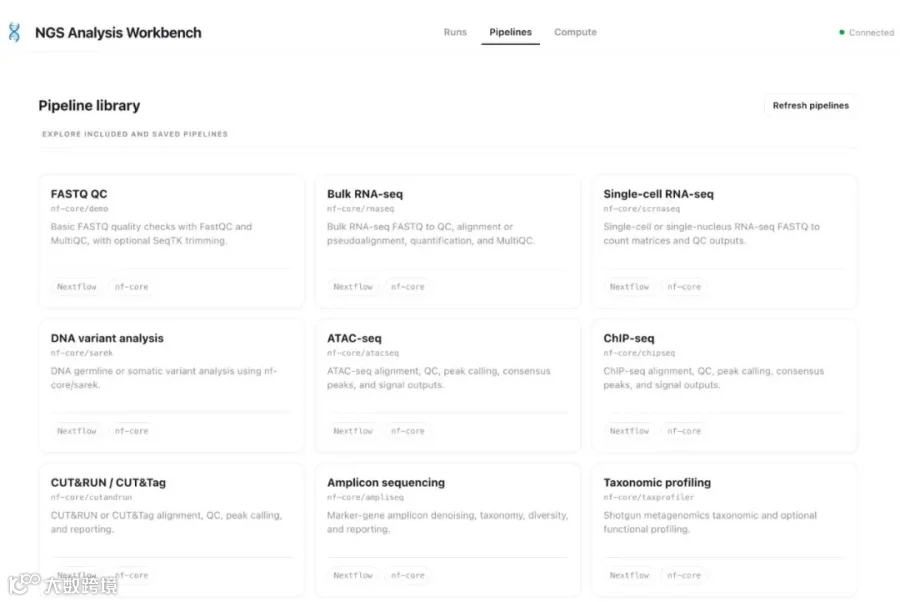
图3|NGS Analysis Workbench 标准化测序分析流程
需要特别说明的是:以上能力属于整个 Rosalind 产品体系。

因此,真正值得关注的技术壁垒,也不是“接入了多少工具”,而是工具编排和结果可追溯能力:系统能否说明使用了什么数据、执行了哪些步骤、得出了什么结论,以及哪些环节仍然需要人工判断。
如果模型只是“会调用工具”,价值仍然有限;真正重要的是,它能否根据科研问题自主判断应该调用什么工具、如何组合这些工具,并让整个过程可追踪、可复核。这可能才是 Rosalind 未来真正的技术壁垒。
双模型信号,未来会如何分工

图4|OpenAI API 价格页显示两模型定价相同
目前可以确认的是,gpt-rosalind-discovery 这一名称曾出现在 API 价格页面,并与 gpt-rosalind-research 并列。仅凭名称和价格,还无法判断两者在架构、训练方式、任务分工或性能上有何区别。
一种可能的解释是,OpenAI 正在探索按科研任务细分模型产品线:Research 侧重较广泛的科学研究任务,Discovery 未来可能更贴近发现阶段的某些工作。但这只是基于命名和产品布局的推测,并非 OpenAI 已经公布的分工。
如果未来确实出现多个面向不同研发环节的专业模型,它们可能分别处理文献与证据整合、靶点研究、分子设计或候选方案评估,再通过统一工作台和专业工具衔接起来。
这意味着未来的竞争单位,可能不再是单个模型,而是一个“科研智能体系统”:不同模型或智能体负责不同环节,再由统一的工作空间、工具和 Skills 将它们连接起来。
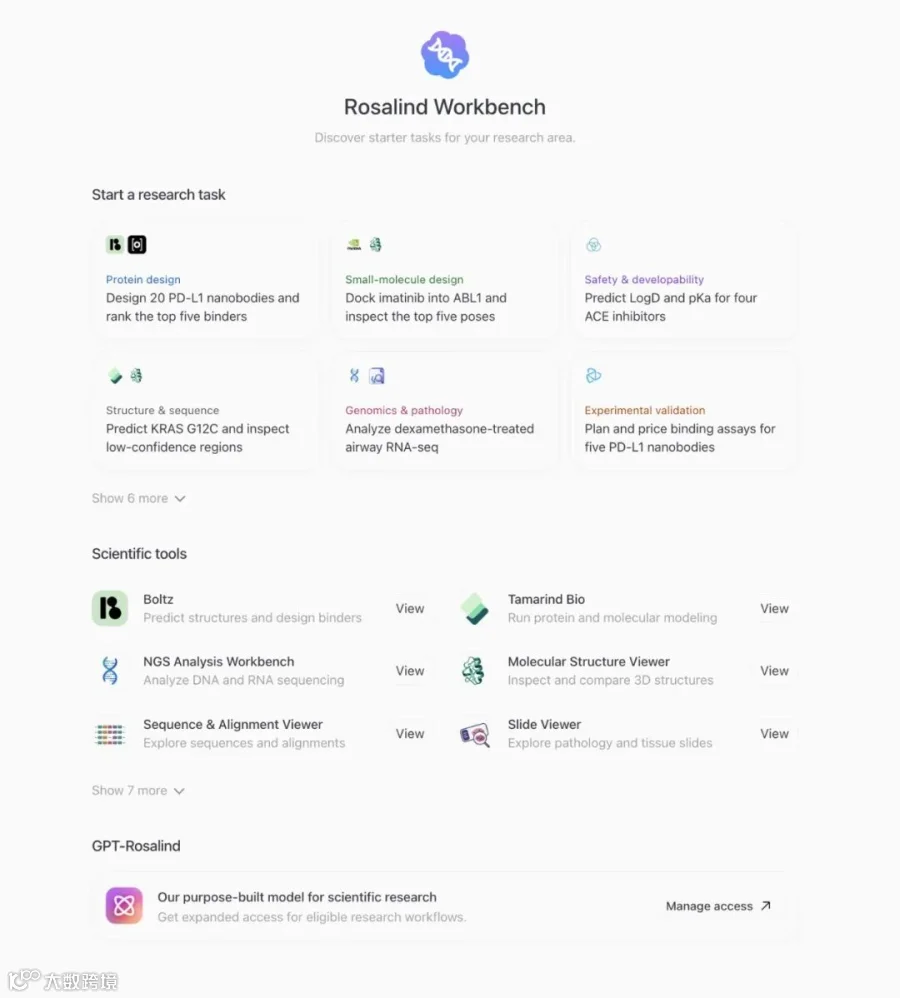
图5|Rosalind Workbench:不同科研任务的统一入口
生命科学 AI 并非只有一种路线。
Google DeepMind 长期投入蛋白质结构预测与生物分子建模,并通过 AlphaFold 和 Isomorphic Labs 向药物研发延伸;Anthropic 等通用模型公司也在探索智能体与专业工作流程的结合;Microsoft 则拥有科研计算、数据平台和企业工具方面的布局。
这些路线并不完全相同,也不能简单排出高下。但一个值得关注的区别是:
DeepMind 更强调对生命科学基础问题的建模与理解;而 OpenAI 当前 Rosalind 路线更值得关注的地方,则是试图让 AI 进一步参与生命科学研发流程。
换句话说,如果说前者更接近:“让 AI 理解生命科学”,那么 Rosalind 所探索的方向更接近:“让 AI 参与生命科学研发。”
Rosalind 的特点,是将专业模型、科研工具和工作空间放在同一产品体系中,强调从研究问题到可检查结果之间的流程衔接。
这条路线的价值,最终还是要看它能否在真实研发场景中带来可重复、可衡量的改进,而不只是演示效果或模型基准分数。
AI 制药过去核心问题更多是:AI 能不能设计出一个好分子?下一阶段的核心问题,可能逐渐变成:AI 能不能持续参与整个研发循环?
因此,未来更有竞争力的系统,可能逐步形成这样的循环:
AI 提出假设 → 专业工具分析 → 研究人员审核 → 实验验证 → 新数据回流 → 更新后续研究判断
谁能以更低的成本、更快的速度、更高的可重复性完成这个循环,谁就可能建立优势。与此同时,数据质量、实验可重复性、模型可靠性、知识产权、隐私保护和生物安全治理,也都会影响这条路线最终能够走多远。
OpenAI 尚未正式公布 gpt-rosalind-discovery 其功能、评测结果和开放范围,目前不应把它直接描述为已经正式发布的“药物发现模型”。真正值得持续观察的是 OpenAI 是否会继续扩展 Rosalind 模型系列,以及这些模型能否与科学数据、专业工具和真实实验流程形成稳定连接。
如果这种整合不断成熟,AI 制药的竞争重点就可能从:“单个模型有多强”逐渐转向:“整套研发系统能否更可靠地把科学假设变成实验依据。”
对 AI 制药而言,真正的分水岭或许不是又多了一个模型名称,而是:AI 能否持续、可验证地参与科研过程。这可能才是 Rosalind 最值得关注的地方。
