


导读本次分享由碧桂园服务技术总监毛卓带来,主题为《企业大规模 AI 编程落地,如何控制大模型成本》。讲者所在的研发团队超 300 人,从今年 1 月起整体切换到 AI 大模型编程之后,成本出现急剧上涨,这场分享正是团队真刀真枪跑下来的一手经验。
1. 为什么成本很重要:ROI 视角下的投入产出比、成本与效率是否矛盾、AI 时代研发团队成本的新算法
2. Token 到底消耗在哪了:智能体与大模型的调用原理、分词规则、输入输出为何不同价、上下文窗口与日常消耗构成
3. 技术手段优化上下文:模型分层路由、架构解耦、输入与输出两个维度的精细控制,以及 Harness 工程
4. 管理手段创新研发流程:把传统敏捷改造成"多人写 PRD + 少数人写代码",以及代码评审与防返工
5. 人才视角:对 Vibe Coding 与规约编程的清醒认知,工程师能力如何直接决定 Token 消耗
01
第一章 为什么成本很重要
第一部分先讲背景。为什么要专门拿出一场分享来谈成本?在同期的会场里,也有老师提到"现在大模型成本越来越便宜,不需要太关注"——这个判断对于自己有大模型的大厂来说也许成立,但对传统企业和大多数其他企业而言,成本是一个致命的问题。所有团队都必须控成本,只有成本控制好了,团队未来的价值才更能呈现出来。
投入产出比合理的项目才有未来
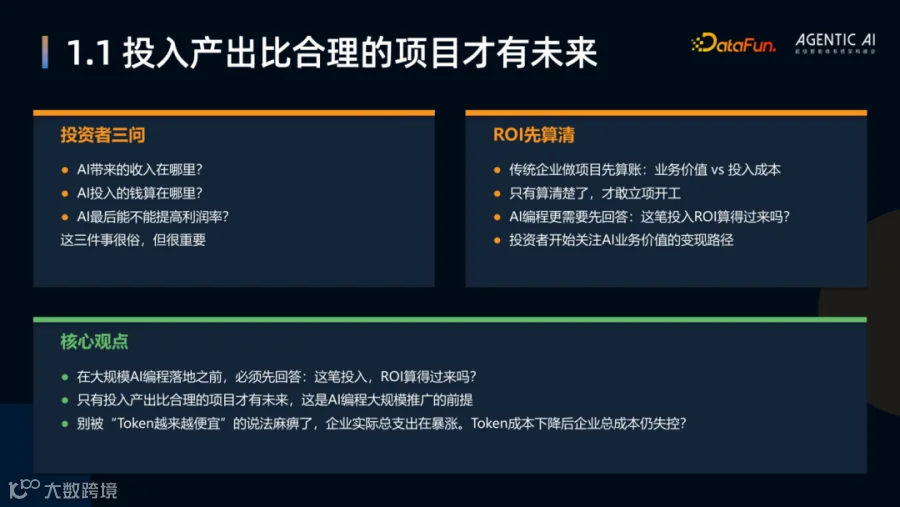
投资者的灵魂三问始终是:AI 带来的收入在哪里?AI 投入的钱算在哪里?AI 最后能不能提高利润率?这三件事听上去很俗,但很重要。讲者此前长期在 500 强外企工作,那类公司做项目动辄几百万美元、对钱相对不敏感;而在国内的民营企业里,凡是做过管理、申请过项目预算的人都能感受到,老板对钱是非常敏感的。你申请 500 万、1000 万的预算,老板一定会问 ROI:这个项目做成了,年底能给公司带来多少钱?传统企业做项目一向要先算账——业务价值对比投入成本,算清楚了才敢立项开工。作为管理者,必须给老板把这笔账算清楚,如果算不清楚,这个团队未来只会越做越危险。所以在大规模 AI 编程落地之前,必须先回答:这笔投入,ROI 算得过来吗?也别被"Token 越来越便宜"的说法麻痹了——单价在降,企业的实际总支出却在暴涨。
成本与效率的关系:鱼和熊掌可以兼得
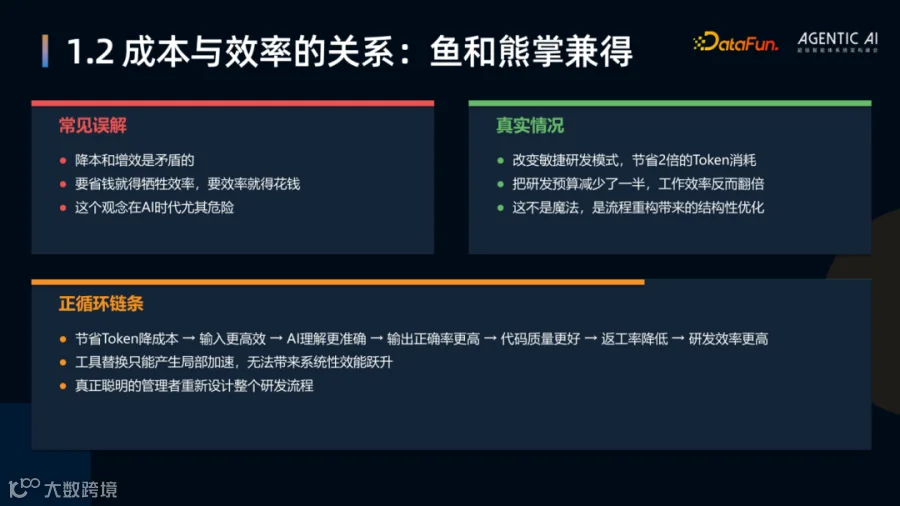
第二个灵魂拷问是:省 Token 和保效率能不能兼得?很多人下意识认为降本和增效是矛盾的——天天在员工身上抠 Token,员工用得少了,工作效率不就下降了吗?这个观念在 AI 时代尤其危险。团队的实践结果恰恰相反:当一个团队能把 Token 成本控制得很好,工作效率反而是大大提升的。这里面是一条正向链条:你想着要控 Token 成本,就必然会从给大模型的输入上下文、从提示词的角度去思考;提示词输入得精准,AI 的理解就更准确,输出正确率更高,代码质量更好,返工率随之降低,研发效率反而更高。反过来,什么都不管、什么都往大模型里塞,输出效果一定特别差。复旦的肖仰华教授在会上举过一个很有启发的例子:现在模型上下文动辄百万 Token,但你把 30 万行代码一把喂给大模型,它消化得了吗?输出能准吗?如果把输入尽量控制在 3000 行甚至更少,它的理解会更精准,回答也会更准确。需要强调的是,工具替换只能带来局部加速,无法带来系统性的效能跃升,真正聪明的管理者会重新设计整个研发流程——这也是后面第四章要讲的重点。
未来研发团队成本的计算方式

从管理者的视角看未来整个团队的成本,算法已经变了。传统软件工程某种程度上是平庸者的温床:工程师像流水线上的螺丝钉,接需求、写 CRUD、解 Bug,只要听话、肯加班、不出大错就算靠谱员工。很多小公司习惯招资质差一些、工资低一些的工程师,但这里的隐性成本巨大——代码质量差、Bug 率高、来回修 Bug,工期拉得很长,人效其实很低,只是老板往往看不出来。到了 AI 时代,Token 成了照妖镜。大家都用 AI 编码,速度都很快,如果一个工程师本身水平一般、AI 工具又掌握得差,消耗的 Token 还很高,他的个人成本就直接上去了。团队的实际做法是每个月把每位工程师的 Token 账单拉出来,结果非常明显:很多优秀工程师消耗的 Token 量反而很少,他们会想尽办法把 AI 的产出质量做高;而几位绩效偏弱的工程师,Token 消耗甚至是优秀工程师的 2 到 3 倍。所以未来真实的成本公式是:工资 + Token 消耗 + 到底提效了几倍。老板一定会去拉这张账单,有的工程师在 AI 时代效率翻了很多倍,有的却看不到什么提升,而公司又多花了这笔钱——后一类工程师未来会很危险。这也是 AI 时代在倒逼每一个人不断成长。
02
第二章 Token 消耗在哪了

第二部分快速过一下原理层面的背景:Token 到底消耗在哪里。理解了计费和消耗的来源,后面的优化动作才不是照搬招式,而是能对症下药。
智能体与 LLM 的调用原理
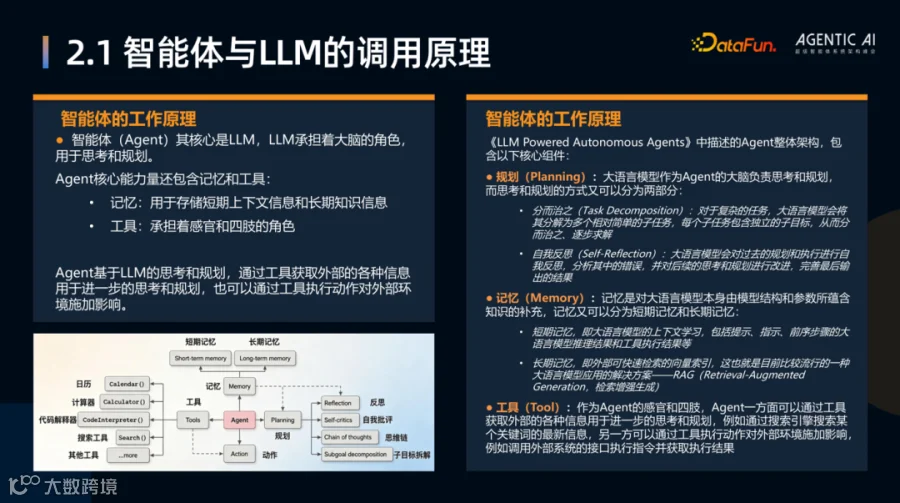
不管是 Claude Code、Codex 还是其他 AI 编程工具,它们本质上都是一个智能体。大模型本身只提供最基本的输入输出能力——你输入什么,它输出什么;真正让 AI Coding 跑起来的,是这些 IDE 侧的智能体帮你完成的一整套流程。按 OpenAI 前研究负责人 Lilian Weng 在《LLM Powered Autonomous Agents》一文中的划分,智能体包含三个核心组件:规划(Planning),由大模型充当大脑负责思考和规划,其中又分为把复杂任务分解为子任务的分而治之(Task Decomposition),以及对过去规划与执行做复盘改进的自我反思(Self-Reflection);记忆(Memory),分短期记忆(即上下文学习,包括提示、指示、前序步骤的推理结果和工具执行结果)和长期记忆(外部可快速检索的向量索引,也就是当下流行的 RAG);工具(Tool),承担感官和四肢的角色,一方面通过工具获取外部信息用于进一步思考规划,另一方面通过工具执行动作对外部环境施加影响——比如做 AI Coding 时接入 Figma、云效等各类 MCP 工具。任务拆解、记忆、工具调用,这些都发生在智能体这一层。
为什么大模型天生没有记忆

大模型本身是没有记忆的。从算法角度看,Transformer 的自注意力机制(self-attention)是根据一段输入计算每两个 token 之间的关联程度,输出结果之后把所有中间状态全部丢弃;Q(查询)、K(键)、V(值)三个矩阵全部由当前输入线性变换而来,没有任何来自上一次调用的状态参与计算。每次推理都是一次纯粹的"输入 → 输出"映射,从数学上就没有记忆。从软件工程角度看,这也是一个必然的选择:做后端开发的都熟悉微服务和无状态设计,大模型如果把记忆带进去,服务器资源消耗会非常高。无状态意味着每次调用完全独立,同一个模型可以同时服务数万个并发用户,同时也避免了用户信息被存储和滥用的隐私安全风险。那为什么用户会觉得 AI 记得自己?因为程序把之前的对话原样重新塞回给了模型,它只是读到了一段长文字,并不是真的记得,再加上人类天生倾向于把情感投射到非生命体上。
如何解决大模型没有记忆的问题
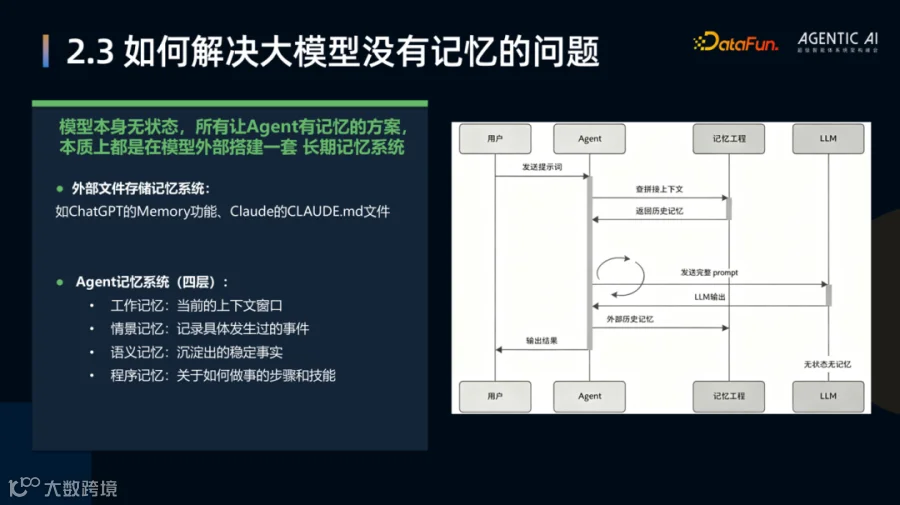
既然模型本身无状态,所有让 Agent 有记忆的方案,本质上都是在模型外部搭建一套长期记忆系统。最常见的是外部文件存储记忆,比如 ChatGPT 的 Memory 功能、Claude 的 CLAUDE.md 文件;更完整的 Agent 记忆系统可以分为四层:工作记忆(当前的上下文窗口)、情景记忆(记录具体发生过的事件)、语义记忆(沉淀出的稳定事实)、程序记忆(关于如何做事的步骤和技能)。讲者所在公司今年建了很多智能体,管理层有、一线员工有、人力也有,本质上都是在建各自的记忆工程。不同场景下记忆工程的建法差别很大:像陪伴聊天类的智能体需要非常理解人,记忆要做得很复杂,要学这个人的习惯;而数据智能体反而越简单越好——对一个问数场景来说,最多记 5 条、10 条记忆可能就足够了,记得太多反而会形成干扰,导致查询结果不精准。
分词规则决定 Token 消耗量

大模型的计费最终记的是 Token 消耗量。Token 是 AI 大模型读取和生成文本的最小基本单元,可以理解为 AI 眼中的单词碎片或字母积木,而且输入加输出不能超过最大上下文长度。Token 同时锁死了大模型的三项物理极限:记忆容量(上下文窗口)、你的钱包(计费标准)、响应速度(生成速率)。中文的粗略换算是:简单词如"我""你""好",一个汉字就是一个 Token;复合词如"喜欢""女朋友",一个 Token 大约对应两个汉字;成语一般四个汉字被看作一个整体。要特别注意代码比自然语言更费 Token——缩进的空格、换行符都单独计数,结构化数据用 JSON 比 YAML 更贵,括号和引号都是要花钱的字符。每种大模型都有自己的分词器(Tokenizer),拆解规则和词库都不一样,所以大家常有困惑:同样的问题问 Claude 和问千问,显示的 Token 数量不一样。这里有一个实用的经验:国产模型对中文的分词更友好,中文在国产 LLM 中通常更省 Token,因为复合词、成语俚语甚至网络词汇都被训练进去了;反过来英文在英文 LLM 中消耗更少,中文模型会把少见的英文词切得更碎。所以要结合自己的实际工作场景去选择合适的大模型。
大模型输出比输入更贵
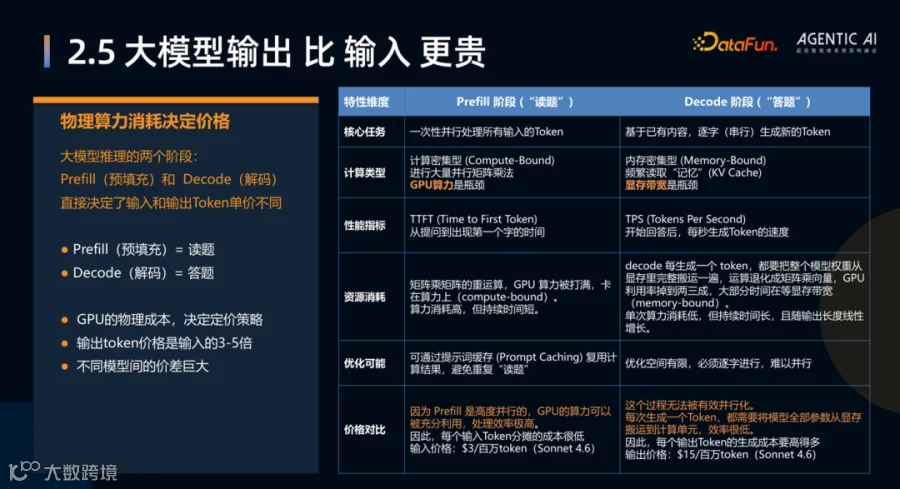
大模型的计费不是打包价,输出单价通常是输入的 3 到 5 倍甚至更高,根源在于推理分成两个阶段。Prefill(预填充)相当于"读题",一次性并行处理所有输入 Token,是计算密集型(Compute-Bound),做的是大量并行矩阵乘法,瓶颈在 GPU 算力,算力消耗高但持续时间短,性能指标是 TTFT(从提问到出现第一个字的时间);由于高度并行、GPU 利用率高,每个输入 Token 分摊的成本很低。Decode(解码)相当于"答题",基于已有内容逐字串行生成新 Token,是内存密集型(Memory-Bound),每生成一个 Token 都要把整个模型权重从显存里完整搬运一遍,运算退化成矩阵乘向量,GPU 利用率掉到两三成,大部分时间在等显存带宽,性能指标是 TPS(每秒生成 Token 数);单次算力消耗低但持续时间长,且随输出长度线性增长。优化空间上也不对等:Prefill 可以通过提示词缓存(Prompt Caching)复用计算结果、避免重复"读题",而 Decode 必须逐字进行,难以并行。归根到底,我们付给这些公司的钱就是算力成本,这些年就是谁卡多谁的天下。
上下文窗口与记忆容量

这一页横向对比了从去年到现在主流模型的上下文窗口、最大输出和价格。可以明显看到,上下文窗口一路变大,旗舰模型基本都到了 1M,但经济型模型多数仍在 200K 量级,或许再过一两年会更大。上下文窗口就是 AI 大模型一次能"记住"并处理的最大文字量,也就是它的短期记忆容量,窗口大小决定了模型能读多长的文档、聊多久的天而不忘事。但关键在于:窗口再大也架不住乱用。就像前面提到的那个例子,你一次塞 30 万行甚至 100 万行代码进去,那确实是模型能力的提升,但编码质量就一定会提高吗?不一定。所以还是要自己想办法,从各个维度让输入更精准、更高效,这就是第三章的主题。
日常开发的 Token 花在哪里了

右边这张截图很经典,是 Claude Code 官方被人报的一个 bug:那个人只跟 Claude Code 说了一句"嗨",就消耗了 3.1 万个 Token。这样烧下去费用是扛不住的。事实上用 Claude Code 这类工具时,你完全可以往下深挖,把 Token 到底消耗在哪里拆解出来——系统提示词、工具名称、MCP 工具、Skill、自定义 agent、记忆文件等等。按日常编码的消耗构成粗算:系统提示与会话初始化约 1 万 Token、占 10%,是每次会话的固定开销;工具调用累积上下文约 4 万、占 40%,Read/Grep 返回的内容会不断累加,这是最大的一块;AI 思考与生成代码约 2 万、占 20%,这才是真正"干活"的部分;返工修复(幻觉/调试)约 2 万、占 20%,是 AI 写了错误代码后的反复修改;其他(解释性文字、不必要的格式化)约 1 万、占 10%。当你发现每次跟 AI 编程工具聊天的 Token 消耗越来越涨的时候,一定要先分析清楚是哪个环节用多了,再对症下药,没有一个标准答案。
03
第三章 技术——优化上下文
第三部分讲技术优化。因为计费规则就是上下文,所以技术侧的所有文章,归根到底都要做在上下文上。下面按模型、架构、输入、输出、软件工程五个维度展开。
大模型维度:分层路由不同级别的模型
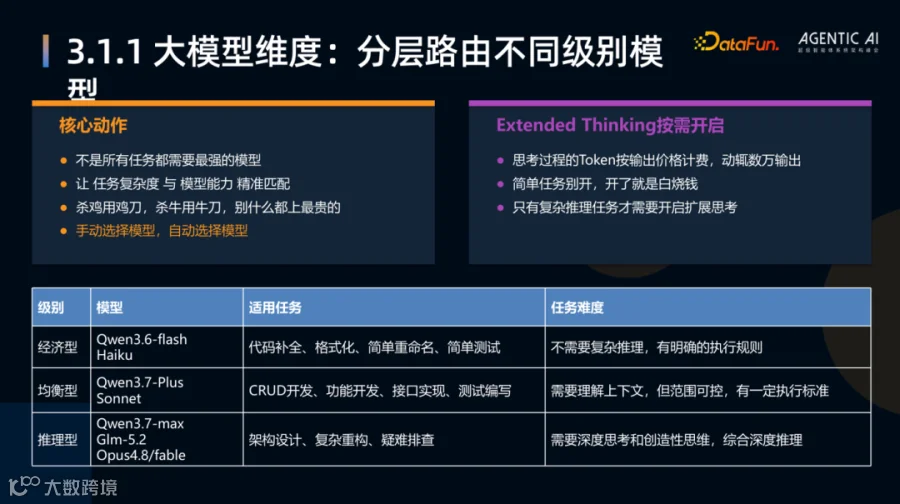
在做上下文优化之前,首先要选对模型。核心动作是:不是所有任务都需要最强的模型,要让任务复杂度与模型能力精准匹配——杀鸡用鸡刀,杀牛用牛刀,别什么都上最贵的。团队实践中经常遇到的情况是,很多人并不会去深入研究,就跟你死磕,说每次都要用最贵的 Opus 5。其实是不了解:如果去看国际上比较权威的 AI 编程排行榜就会发现,国内模型进步非常大,千问、GLM、DeepSeek 在多个权威编程评测榜单中已稳居第一梯队。所以一个团队里一定要有几个技术专家持续关注技术动态,知道大模型进步到哪里了,再来做合适的搭配。团队的做法是按三档划分:经济型(Qwen3.6-flash、Haiku)用于代码补全、格式化、简单重命名、简单测试这类不需要复杂推理、有明确执行规则的任务;均衡型(Qwen3.7-Plus、Sonnet 5)用于 CRUD 开发、功能开发、接口实现、测试编写这类需要理解上下文但范围可控的任务;推理型(Qwen3.8-Max、GLM-5.2、Opus 5)用于架构设计、复杂重构、疑难排查这类需要深度思考的任务。另外要特别提醒工程师的一个小经验是:Extended Thinking(深度思考模式)别乱开,思考过程的 Token 是按输出价格计费的,动辄数万输出,简单任务开了就是白烧钱。
大模型维度:分层路由的配置示例

理念讲得再多,落地时工程师照样会去用最贵的模型——把团队叫来开一天会,讲完了他还是选 Opus。所以要在软件工程层面做约束,把路由规则固化成配置。具体分四步:Step 1,在 ~/.claude/settings.json 中配置模型别名,把 ANTHROPIC_DEFAULT_HAIKU_MODEL 映射到 qwen3.6-flash、SONNET 映射到 qwen3.7-plus、OPUS 映射到 qwen3.8-max,默认 model 设为 sonnet;Step 2,创建子代理文件 .claude/agents/fast-worker.md,指定 model: haiku、工具限定为 Read/Grep/Glob/Edit,定位是快速处理格式化、typo、小重构这类简单任务,用最少的改动、速度优先;Step 3,创建 .claude/agents/deep-thinker.md,指定 model: opus,工具放开到 Read/Grep/Glob/Bash/Edit,用于复杂 bug、架构设计、安全审查这类深度分析;Step 4,在 CLAUDE.md 中写明智能路由规则——简单任务委派给 fast-worker,复杂任务委派给 deep-thinker,日常开发自己处理。规则写进去之后,工具就能根据当前任务自动切换模型,当然也可以手动切换。现在很多工具本身也提供自动模式,可选模型更多,会自动为工程师搭配合适的模型来降低成本。
架构维度:模块解耦与无状态

很多工程师觉得写代码跟架构没什么关系,其实架构设计对 AI Coding 的 Token 消耗影响非常大。做过 AI Coding 的人肯定遇到过:一个看起来很简单的功能,让它去改,它给你越改越多,烧了一堆 Token,几乎把整个工程都改完了。根源就在于系统是个"大泥球"单体——模块切分不清、耦合严重,AI 每次修改都需要理解整个系统,Token 自然爆炸。核心动作就是缩小 AI 可触碰的代码范围:同一个需求,不同架构能差出 3 到 5 倍 Token;在 Prompt 层抠 30%,不如在架构层省 300%。做后端的都知道要切微服务、切模块,各模块之间通过 API 接口或消息中间件对接。架构切干净之后,就可以让 AI 把本次任务限定在某一个微服务内完成,要跟其他服务对接就去查 API 文档库,AI 不会过度发散,也改不到别处。落地动作上有几条建议:用 Fitness Function(如 ArchUnit)把架构约束代码化;契约先行(OpenAPI / Protobuf),人定契约、AI 填实现;模块化单体优先于伪微服务。从数据看,大泥球单体单任务消耗 40 到 100 万 Token、返工率 40% 以上,分布式大泥球(伪微服务)更差,达到 50 到 120 万、返工率 45% 以上;而契约化模块架构和真微服务(强契约)都只需 5 到 15 万 Token,返工率低于 15%。AI 时代还多了一个新的度量维度:Modification Surface(修改面)与 Context Boundary(上下文边界)。
输入维度:高效高质量的会话

跟大模型编程通常先开一个会话,会话本身也很关键。基本原则是对话越长越贵,一个任务一个会话:每个任务尽量控制在 5 到 8 轮对话内完成,超过 10 轮时强制保存状态、开新会话,用 /resume 续接避免重复加载上下文。会话的拆分与合并要结合架构和任务原子性——按架构拆分、按任务原子性拆分,同类小任务可以合并以共享上下文。对于相对独立的重任务,要善用子代理:子代理的本质是"一次性探索员",它在独立空间中执行搜索等重任务,完成后只回传关键结论并自动销毁,主会话因此免于被海量中间结果污染,始终聚焦核心逻辑;适合子代理的任务类型主要是搜索探索类、信息收集类、独立验证类。此外要定期做会话压缩和清理:/compact 是有损压缩,能节省 80% 以上,并且可以指定保留项,比如"保留所有代码修改记录和文件路径,丢弃分析过程";/clear 是彻底清空,完全切换任务时使用。一条铁律:一个会话只解决一个独立任务。
输入维度:缓存命中与增量更新
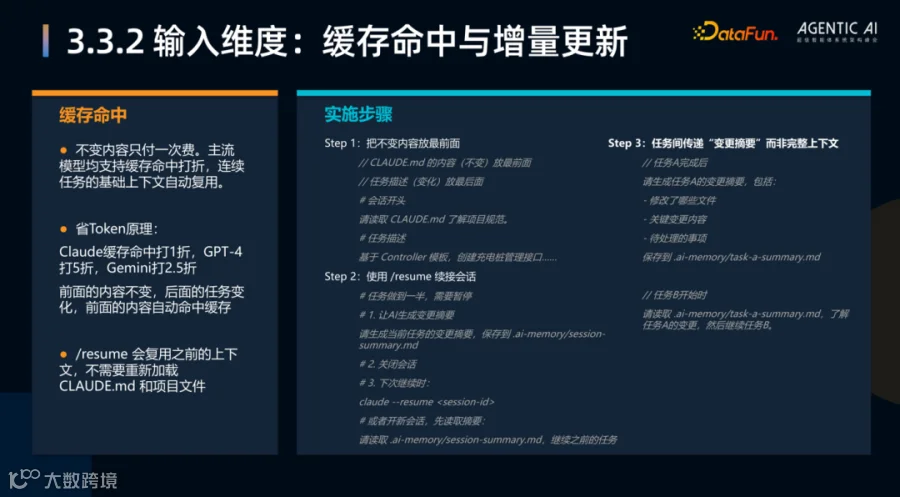
缓存命中是典型的对症下药。查各家的官方计费规则会发现,缓存命中的折扣力度很大——Claude 缓存命中打 1 折,GPT-4 打 5 折,Gemini 打 2.5 折,各家不同但方向一致,且最新一代模型仍在持续加大缓存折扣力度:不变的内容只付一次费,连续任务的基础上下文可以自动复用。做好缓存命中,能大幅降低 Token 费用。落地分三步:Step 1,把不变内容放最前面——CLAUDE.md 的内容(不变)放在会话开头,任务描述(变化)放在最后面,前面不变、后面变化,前面的部分就会自动命中缓存;Step 2,使用 /resume 续接会话——任务做到一半需要暂停时,先让 AI 生成变更摘要保存到 .ai-memory/session-summary.md,下次用 claude --resume <session-id> 继续,或者开新会话时先读取这份摘要;Step 3,任务之间传递"变更摘要"而不是完整上下文——任务 A 完成后生成摘要(修改了哪些文件、关键变更内容、待处理事项)存到 .ai-memory/task-a-summary.md,任务 B 开始时先读这份摘要再继续。
输入维度:精准提示词输入
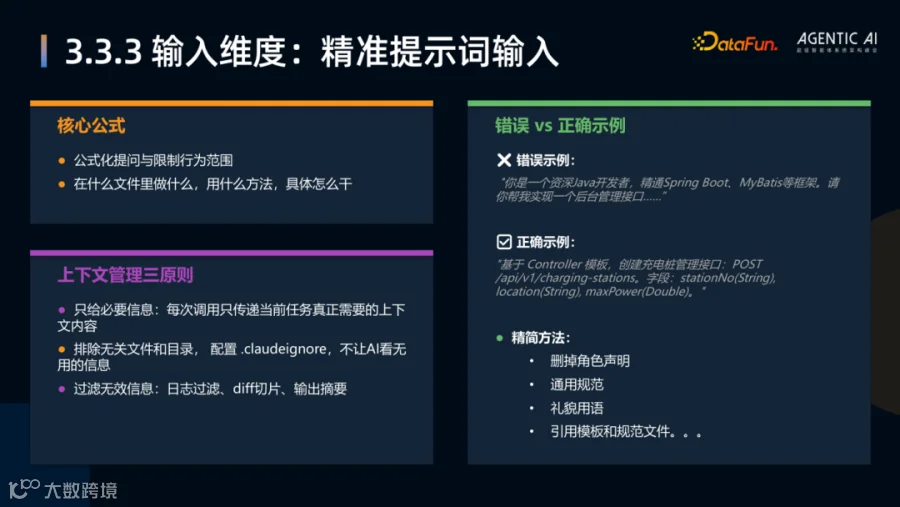
大的架构层面抠完了,小的提示词层面也要抠。但要澄清一点:抠提示词的关键不在于字数多少,而在于让 AI 执行任务的准确性。团队最初也定过规范说少讲"你好""请帮我"这类礼貌用语,其实那几个字省不出多少钱。真正核心的是把任务讲清楚——跟大模型沟通和跟人沟通是一样的,一个人说了半天描述不清楚任务,执行的人自然会做错或做偏。所以团队定义了一个提问公式:在什么文件里做什么,用什么方法,具体怎么干。反面例子是"你是一个资深 Java 开发者,精通 Spring Boot、MyBatis 等框架,请你帮我实现一个后台管理接口……";正面例子是"基于 Controller 模板,创建充电桩管理接口:POST /api/v1/charging-stations。字段:stationNo(String), location(String), maxPower(Double)。"精简的方法包括删掉角色声明、删掉通用规范、删掉礼貌用语,改为引用模板和规范文件。上下文管理还有三条原则:只给必要信息,每次调用只传递当前任务真正需要的内容;排除无关文件和目录,用 .gitignore 兜住 node_modules、构建产物、日志这些大头(检索工具默认遵守),再用 settings.json 的 permissions.deny 做补充限制,不让 AI 去读那些没用的东西——注意 Claude Code 并不支持 .claudeignore,那是一个流传很广的幻觉配置;过滤无效信息,做日志过滤、diff 切片、输出摘要。
输入维度:通过 Skill 动态加载上下文
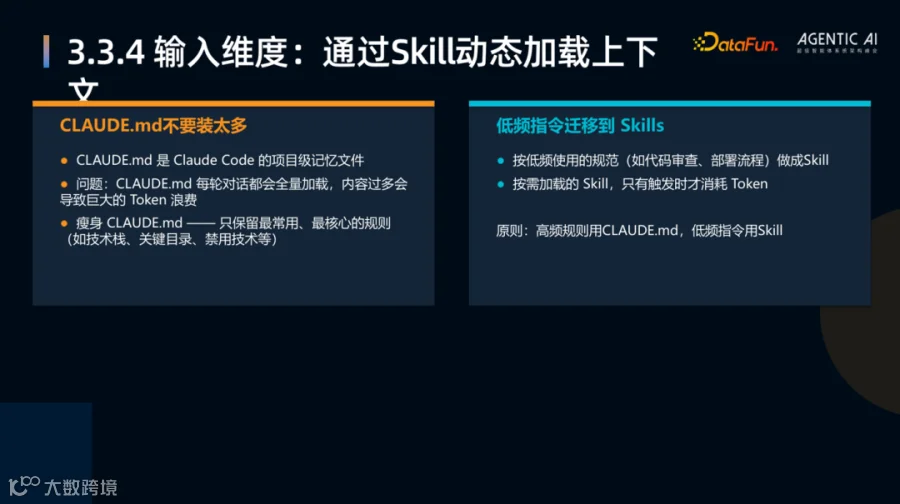
CLAUDE.md 是 Claude Code 的项目级记忆文件,问题在于它每轮对话都会被全量加载,内容过多就会造成巨大的 Token 浪费。实际中经常看到工程师的 CLAUDE.md 爆炸——Coding Style 规范、Code Review 流程,什么都往里写,越写越大,而这些内容每一次会话都跟着进上下文,这就是前面那个"说一句嗨消耗 3 万多 Token"的同类问题。正确做法是给 CLAUDE.md 瘦身,只保留最常用、最核心的规则,比如技术栈、关键目录、禁用技术等短而硬的东西;把低频使用的规范(如代码审查、部署流程)做成 Skill,按需加载,只有触发时才消耗 Token。原则很简单:高频规则用 CLAUDE.md,低频指令用 Skill。
输入维度:MCP 按需加载
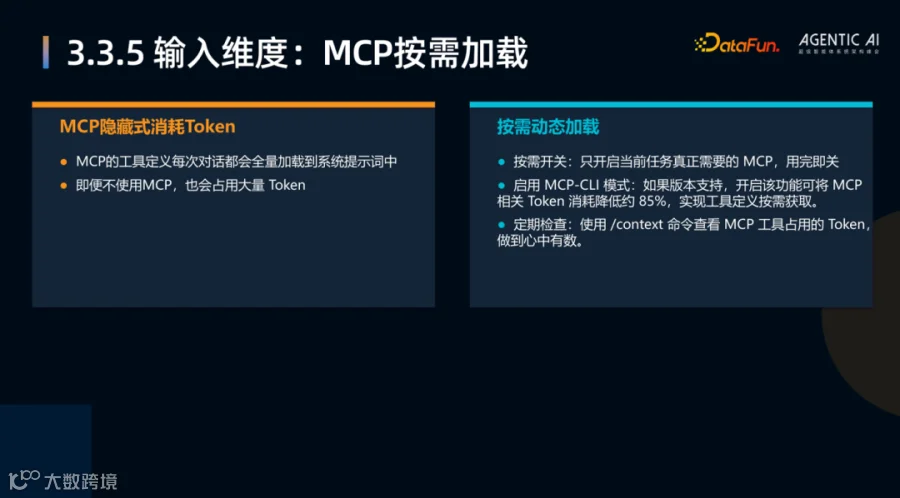
MCP 是一处隐蔽的 Token 消耗源:MCP 的工具定义每次对话都会全量加载到系统提示词中,即便这次根本不用它,也照样占用大量 Token。很多工程师做原型设计要配 Figma、做敏捷管理要配管理工具的 MCP,全都往里堆,越配越大,最后 Token 爆炸。做法是按需动态加载:按需开关,只开启当前任务真正需要的 MCP,用完即关;如果版本支持,启用 Tool Search(工具搜索)与 Programmatic Tool Calling,可将工具定义占用的 Token 降低约 85%,新版本客户端也已默认对 MCP 工具定义做按需加载;同时定期用 /context 命令查看 MCP 工具占用了多少 Token,做到心中有数。
输出维度:精简输出内容
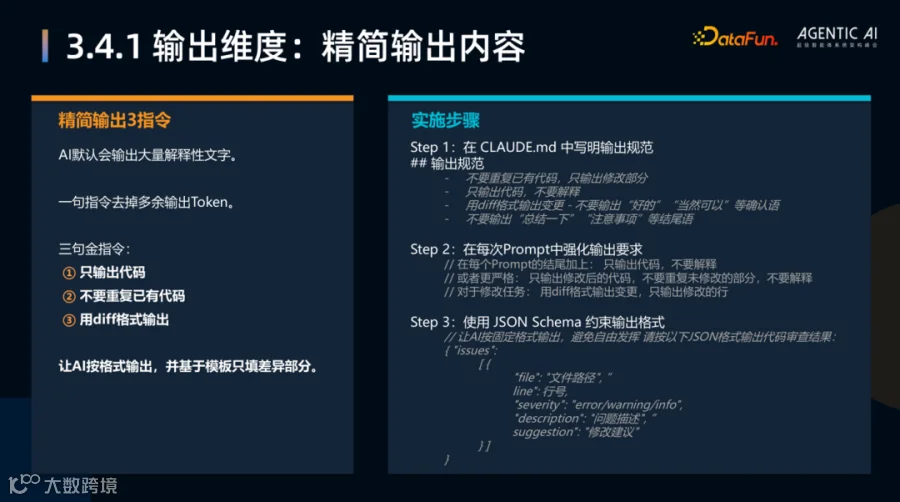
输入抠完了,输出侧同样能省则省——输出都是钱,而且单价更贵。实践中会发现大模型在输出里废话很多,代码中还会加大量注释。关于注释各家理念不同:讲者刚毕业时在外企被要求注释写得极其详细,注释甚至比代码多;后来在另一家科技公司,理念是几乎可以不写注释,代码即注释——真正的高手方法名起得好、类起得好、结构清晰,一看就懂。所以团队在规范里要求 AI 尽量少写解释性注释,一方面提升代码质量,一方面也大大降低了输出行数。具体有三句金指令:① 只输出代码;② 不要重复已有代码;③ 用 diff 格式输出。落地分三步:Step 1,在 CLAUDE.md 中写明输出规范——不要重复已有代码只输出修改部分、只输出代码不要解释、用 diff 格式输出变更、不要输出"好的""当然可以"等确认语、不要输出"总结一下""注意事项"等结尾语;Step 2,在每次 Prompt 结尾强化输出要求,比如"只输出修改后的代码,不要重复未修改的部分,不要解释",对修改类任务则要求"用 diff 格式输出变更,只输出修改的行";Step 3,使用 JSON Schema 约束输出格式,让 AI 按固定结构输出(如代码审查结果按 file / line / severity / description / suggestion 字段返回),避免自由发挥。
输出维度:结构化输出与模板复用

更进一步的做法是建立代码模板库,让 AI 从"写代码"变成"填代码"。Java 类里其实有大量样板内容——前面的定义、后面的 getter/setter、各种括号,与其让 AI 每次从上到下重新输出一遍,不如让它读取模板、只做填空题。团队在 .ai-memory/templates/ 下建了一套模板:Controller.template.java(标准 RESTful 接口模板)、Service.template.java(标准业务逻辑模板)、Mapper.template.java(MyBatis-Plus Mapper 模板)、CreateReq.template.java(创建请求 DTO 模板)、VO.template.java(响应 VO 模板)、PageReq.template.java(分页请求 DTO 模板)、IntegrationTest.template.java(集成测试模板)。使用上分两步:Step 1,在 CLAUDE.md 中引用模板,声明创建新类时先读取 .ai-memory/templates/ 下对应的模板,基于模板生成代码,只替换 {Entity}、{entity}、{api} 等占位符;Step 2,在 Prompt 中直接引用模板——不要说"请实现一个管理系统后台的 Controller,包含 create/getById/page/update/delete 方法……",而应该说"基于 Controller.template.java 模板,创建管理系统后台接口:Entity: ChargingStation,entity: chargingStation,api: charging-stations,需要的方法:create、getById、page、update、delete"。这样每次输出的行数都能大幅减少。
软件工程维度:Harness 工程
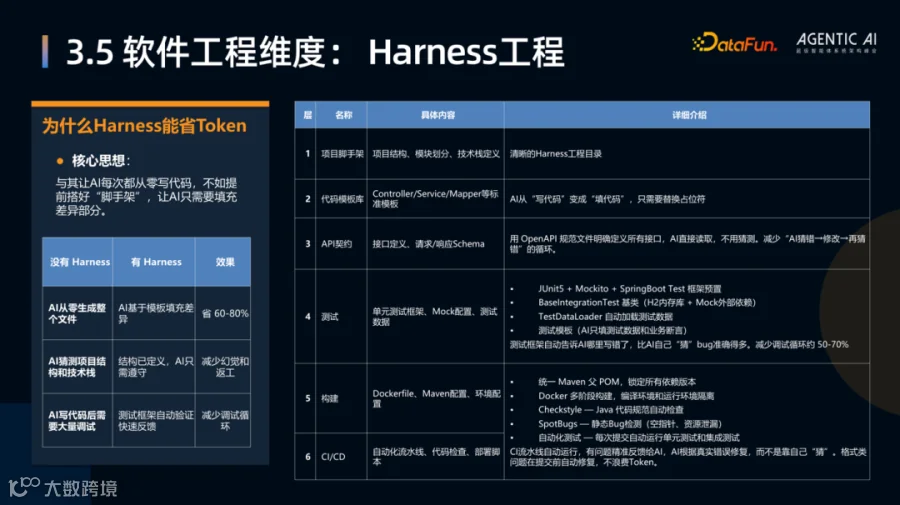
前面做的这么多事情,其实都属于 Harness。Harness 是一种理论和概念,核心是要驾驭大模型、不让它失控。对软件编程来说它没有一个直接对应物,现在流行的规约编程只能算 Harness 的一部分,不是百分之百对标——平时任何能把 AI 编码智能体框住、让它在约束中正确工作的工程实践,都属于 Harness 工程。与传统 DevOps 的区别在于,Harness 的核心对象是 AI Agent 而非人——它通过规则文件、模板、测试脚手架等约束 AI 的行为边界和输出质量。Harness 之所以能省 Token,核心思想是:与其让 AI 每次都从零写代码,不如提前搭好"脚手架",让 AI 只需要填充差异部分。对比来看:AI 从零生成整个文件 vs AI 基于模板填充差异,能省 60% 到 80%;AI 猜测项目结构和技术栈 vs 结构已定义 AI 只需遵守,能减少幻觉和返工;AI 写完代码需要大量调试 vs 测试框架自动验证快速反馈,能减少调试循环。完整的 Harness 分六层:第一层项目脚手架,定义项目结构、模块划分、技术栈;第二层代码模板库,提供 Controller/Service/Mapper 等标准模板;第三层 API 契约,用 OpenAPI 规范文件明确定义所有接口,AI 直接读取不用猜测,减少"AI 猜错→修改→再猜错"的循环;第四层测试,预置 JUnit5 + Mockito + SpringBoot Test 框架、BaseIntegrationTest 基类(H2 内存库 + Mock 外部依赖)、TestDataLoader 自动加载测试数据和测试模板,让测试框架自动告诉 AI 哪里写错了,比 AI 自己猜 bug 准确得多,可减少约 50% 到 70% 的调试循环;第五层构建,统一 Maven 父 POM 锁定依赖版本、Docker 多阶段构建、Checkstyle 代码规范检查、SpotBugs 静态 Bug 检测、每次提交自动跑单元和集成测试;第六层 CI/CD,自动化流水线、代码检查、部署脚本,让问题精准反馈给 AI,AI 根据真实错误修复而不是靠猜,格式类问题在提交前自动修复,不浪费 Token。需要补充一句:技术类的方法网上一搜很多,关键是结合自己公司的情况对症下药;而且技术在不断进步,今天讲的方法明天可能就失效了,要持续关注前沿。
04
第四章 管理——创新研发流程

第四部分讲管理,这是团队今年收益最大的一块。仅仅通过研发流程上的一次改变,就把整个研发的 Token 消耗至少降了一半,研发效率提升了 2 到 3 倍。
AI 编程时代的新研发流程

先说背景。公司有一个做了七八年、曾有将近七八十号员工维护的商城系统,如今技术栈已经非常混乱、年久失修,改不动了。今年借着 AI 时代的契机,团队决定重写一套全新的商城。问题随之而来:工程师们已经人手配备了 AI 编程工具,但他们评估下来的工作量和项目成本动辄几千万——在传统企业里这是很吓人的数字。于是团队复盘:为什么配了大模型,估算却和传统方式没有太大变化?这一页把旧研发模式的问题和新模式的解决方案做了完整对照,可以从三个维度看。第一是降低沟通成本。旧模式的问题是:管理沟通耗时太多、容易相互等待;需求传递链路太长,从产品到开发到 AI 再到测试层层传递,容易导致理解偏差、验收不通过而返工;重复撰写需求,产品写云效需求、工程师再翻译成 AI 可理解的 PRD、测试再写测试用例;系统老旧、文档缺失、隐藏逻辑多,纯靠产品经理输出需求质量难以保障。解决方案是团队全员参与编写需求 PRD,技术侧分析老系统代码,确保产品经理给出的需求没有逻辑遗漏;同时把需求标准直接定为"可输入给 AI 且 AI 可识别的 PRD 标准需求",从而消灭需求的层层传递讲解。第二是发挥成员长处。旧模式的问题是:部分工程师对 AI 编程掌握差,写出的产品和技术需求不规范、Prompt 能力弱、思维固化、工作量评估虚高;工程师单兵作战,各管各的模块缺少全局思考,技术架构标准执行不统一,前后端各自开发联调易出错,最终导致 AI 生成代码质量差、代码合并大量冲突、Token 消耗高,也缺少项目级需求,无法发挥 AI 批量生成代码的优势。解决方案是发挥老工程师需求理解的优势——老商城业务逻辑复杂,很多需求要看代码才能理解,正好弥补产品经理人手不足和隐藏逻辑理解不足;同时让 AI 编程能力弱的工程师聚焦需求梳理,配合 4 名核心 AI 编程工程师,在带教中提升团队整体能力。第三是统一技术标准。AI 编程目前业界最大的痛点是大规模多人协作易冲突,很难在项目初期就把团队全部技术规范和编程规范定义清楚,多人协同编码时容易导致 AI 理解混乱、大规模修改代码;团队人数多、工期紧时架构执行也容易不到位。解决方案是安排 2 名架构师专门编写 AI 技术规约、制定项目标准,4 名核心工程师掌控 AI 编程工具负责写代码。新流程因此变成:20 人团队全员分 4 组写 PRD 需求、产品经理带队;架构师 2 人写技术规约和架构设计文档;相关人员开计划会排期,需求清晰的功能优先进入开发;4 名核心工程师做 AI 编程,精通规约编程与和 AI 高效沟通;团队全员做测试与验收,谁写的需求谁验收,需求无需传递;然后上线。一句话总结就是:打破团队边界,打破职位边界,打破传统管理模式,不破不立,人尽其用,发挥所长,强者带教,重塑研发流程。
研发流程重构:多人写 PRD + 少数人写代码
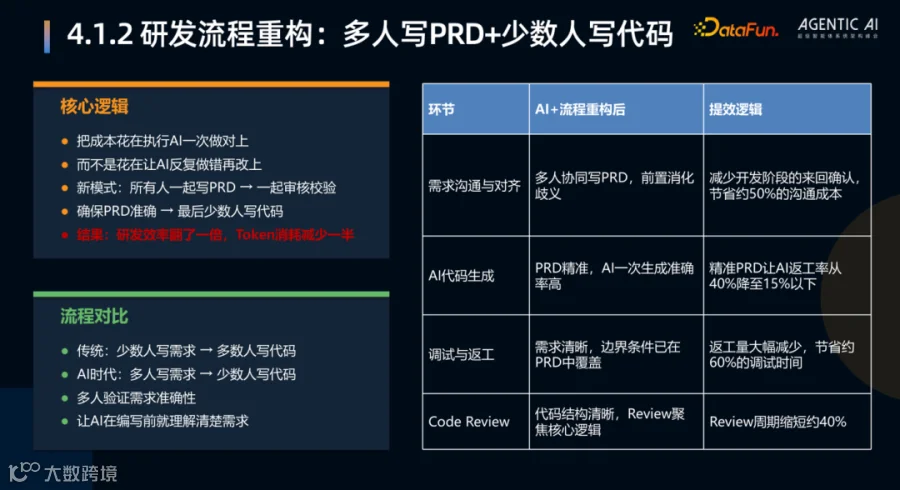
这次重构的核心逻辑是:把成本花在让 AI 一次做对上,而不是花在让 AI 反复做错再改上。传统流程是少数人写需求、多数人写代码;AI 时代要反过来——多人写需求、少数人写代码,用多人来验证需求准确性,让 AI 在编写之前就把需求理解清楚。因为在 AI 时代,慢的环节已经不是写代码了:只要需求写得精准,喂进去几十分钟到几小时就能跑出来。瓶颈往回推,其实卡在沟通和需求上。这个商城重构项目本来要 40 多个人,讲者只跟老板要了 20 个人,把产品、测试、研发全部拉齐成一个团队,分成几个小组,每组既有产品又有研发又有测试,所有人一起写需求,经过评审形成非常标准的需求,只抽出 4 名 AI 编程工具掌握得最好的核心工程师去写代码。架构上则抽调 2 名架构师专门为 AI 写规约、定技术规范,编程时把架构规范和产品需求同时喂给大模型,确保产出的直接就是可用的高质量系统。从环节上看提效逻辑很清楚:需求沟通与对齐环节,多人协同写 PRD、前置消化歧义,减少开发阶段的来回确认,节省约 50% 的沟通成本;AI 代码生成环节,PRD 精准让一次生成准确率提高,返工率从 40% 降至 15% 以下;调试与返工环节,需求清晰、边界条件已在 PRD 中覆盖,返工量大幅减少,节省约 60% 的调试时间;Code Review 环节,代码结构清晰、Review 聚焦核心逻辑,周期缩短约 40%。这个项目已经执行了大半年,效果很好:研发效率至少是原来的 2 到 3 倍,Token 至少省一半,整个项目的研发费用也节省了一半——而且这个说法还是比较保守的。
研发流程瓶颈:人工代码评审慢

AI 写代码那么快,谁来审核这些代码?这是同行交流时反复被提到的问题。现实是 AI 让写代码快了 2 到 3 倍,但 Review 只快了 30%,每人每天的代码量从 200 行涨到 600 行,人工审核的速度根本跟不上;Reviewer 的负担也从"检查作者的逻辑"变成了"验证 AI 的意图",而微 PR 不断累积,整体架构可能在悄悄腐化。针对 AI 生成的代码,Review 时还多出五个新增检查维度:幻觉 API(AI 可能编造不存在的 API)、License/IP 污染(是否用了违规许可证、是否抄了别人的代码)、安全漏洞、架构约束符合度、可维护性。应对思路是四层防御(Defense in Depth):L1 自动化检查,做静态分析和安全扫描;L2 AI 辅助 Review,验证意图和架构符合度;L3 人工 Review,聚焦业务逻辑和关键判断;L4 测试验证,看覆盖率和断言质量。
防返工:质量、测试与可维护性

节省 Token 还有一个很关键的环节是防返工。如果你和 AI 沟通得不好、话说不清楚,AI 理解偏了来回返工,那么 Prompt 上抠的那点 Token 完全是杯水车薪——返工环节消耗的 Token 才是大头。团队现在把迭代从两周压到了一周,正是因为一开始就要求需求非常规范,AI 写代码的质量提升之后返工率很低。这一页给出了几个需要关注的方面。AI 编程的效能度量要看四类指标:效率(代码接受率、PR 周期)、质量(引入 Bug 率、覆盖率)、成本(单需求开发成本)、团队(采纳率、满意度)。要警惕测试结果的虚假安全:覆盖率很高但关键路径断言很低;更隐蔽的是 AI 生成的测试和代码同源错误——AI 写代码用了错误假设,写测试又用了同样的错误假设,测试和代码一起错。还要正视生成代码的维护难度:代码的读者从人变成了人与 AI,沿用旧规范等于制造隐形技术债,注释要从简洁转向结构化,命名要从简短转向明确无歧义。归根到底,代码库在 AI 时代有了新角色——它是 AI 的操作系统:代码规范需要面向 AI 重构,文档体系要升级(ADR、CLAUDE.md、Decision Log),模块边界要从软约定变为强契约(OpenAPI)。
05
第五章 人才——注重综合能力

最后一部分是关于人的思考:到了 AI 时代,什么样的工程师才符合要求?我们自己又该成长为什么样的人才?
对 Vibe Coding 和规约编程的清醒认知
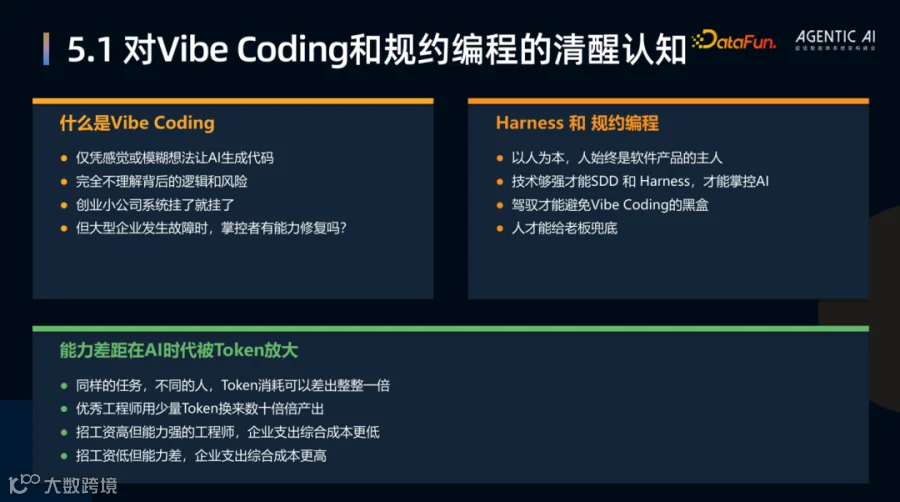
先说对 Vibe Coding 的态度。这个概念由 OpenAI 联合创始人 Andrej Karpathy 于 2025 年 2 月首次提出,刚出来时铺天盖地都是"一人公司"的新闻——我一个搞业务的什么都不懂,把需求一喂给 AI,AI 就写了一个系统,一个人全干了;程序员随之被灵魂拷问:是不是要失业了?讲者直言至今不认同这个概念,因为它根本不成立。Vibe Coding 的实质是仅凭感觉或模糊想法让 AI 生成代码,完全不理解背后的逻辑和风险。创业小公司的系统挂了就挂了,一个人的系统能有多少人用?但大型企业不一样——像微信、支付宝这种体量,几秒钟都不敢停机,发生故障时,掌控者有没有能力修复?而且现在的 AI 只能做到写代码,还远做不到 AI 运维。做 SLA 要求高的系统的人都有体会:半夜爬起来处理服务器告警,往往还不是自己代码的问题——云平台出问题、数据库出问题、第三方支付出问题,甚至遇到过宽带光缆被人挖断,这类问题 AI 解决不了,只能靠人去排查、去跨团队沟通。所以一定要走规约编程这条路。规约编程本质上就是驾驭工程:以人为本,人始终是软件产品的主人;技术足够强才能做好 SDD(Specification-Driven Development,规范驱动开发)和 Harness,才能真正掌控 AI;有驾驭才能避免 Vibe Coding 的黑盒;最终也只有人能给老板兜底——系统出问题时,总不能告诉老板"你去把 Claude Code 杀了祭天"。即使是 AI 写完的代码,程序员也一定要做 Code Review,要能读懂系统、能把 AI 写的代码控制在自己的架构要求之下。同时要看到,能力差距在 AI 时代被 Token 放大了:同样的任务,不同的人 Token 消耗可以差出 2 到 3 倍,优秀工程师用少量 Token 换来数十倍产出。所以招工资高但能力强的工程师,企业综合成本反而更低;招工资低但能力差的,综合成本更高。
工程师能力决定 Token 消耗
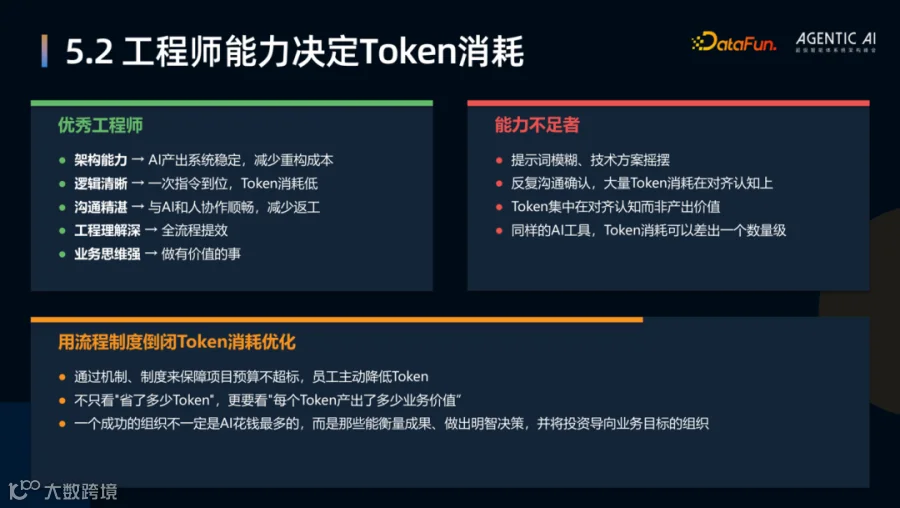
具体到能力模型,优秀工程师的几项能力会直接转化为成本优势:架构能力强,AI 产出的系统更稳定,减少重构成本;逻辑清晰,一次指令到位,Token 消耗低;沟通精湛,与 AI 和人协作顺畅,减少返工;工程理解深,能带来全流程提效;业务思维强,做的是有价值的事。而能力不足的人则相反:提示词模糊、技术方案摇摆,需要反复沟通确认,大量 Token 消耗在对齐认知上而不是产出价值上,同样的 AI 工具,Token 消耗可以差出 2 到 3 倍,个别极端案例甚至可达一个数量级。这里讲者分享了一个观察:在 AI 时代,对工程师沟通能力的要求反而更高了。有同行甚至认为,未来学中文、学文科的可能比学理工科的更吃香,因为沟通能力更强。传统印象里工程师是闷头不爱说话、穿格子衫的形象,性格倒不是问题,关键是能不能高效、精准地把要做的事情传达给大模型;做不到,就会导致代码质量低、返工率高,最终自己花的钱多、个人价值反而在降低。在管理上,则要用流程和制度来倒逼 Token 消耗优化:通过机制和制度保障项目预算不超标、员工主动降低 Token;不只看"省了多少 Token",更要看"每个 Token 产出了多少业务价值"。一个成功的组织不一定是 AI 花钱最多的,而是那些能衡量成果、做出明智决策,并将投资导向业务目标的组织。

最后做个总结。无论是工程师个人的价值,还是一个软件研发团队的价值,永远都要面对同一个灵魂拷问:AI编程的大模型费用增加了,但是今年研发效能提效了多少?带来了多少业务价值?我们都要提前好准备,别等被挑战时才陷入尴尬。

往期推荐
一个Agent如何搞定数仓搭建+数据治理+归因分析?
OpenAI 杀进数据分析,BI 反而成了必选项
WorkBuddy同款数据智能体在真实场景的落地探索!
从“完成任务”到“持续进化”: AI Agent 记忆能力的评测与实践
阿里集团2000+数字员工上岗,从试点到规模化的血泪经验
Foundation Protocol:Agent 社会的基础协议与协调底座
Palantir CEO:AI时代,不做“有”的企业,就等着被掏空
本体落地的分叉路口:天翼征信在语义映射与对象存储间的取舍
Semantic Layer不够了,Google开始给Agent补“业务关系”
理想汽车的判断:生产级 Agent 的瓶颈不在模型,在上下文

点个在看你最好看
SPRING HAS ARRIVED
