大数跨境

Git 被换掉,LLM 被替代:AI 编码开始反噬传统工具链?

Git 被换掉,LLM 被替代:AI 编码开始反噬传统工具链? AI科技评论
2026-10-14
11
导读:Anthropic 代码量暴涨,GitHub 密钥扫描又慢又贵,两家被迫改造系统。
Anthropic 代码量暴涨,GitHub 密钥扫描又慢又贵,两家被迫改造系统。

    作者丨郑佳美

    编辑丨岑   峰


Git 支撑软件开发二十余年,Anthropic 却决定将其替换。为适配 Claude 持续生成的代码流,7 名工程师耗时 5 个月研发出版本控制系统 Scion,并完成核心代码仓库迁移。
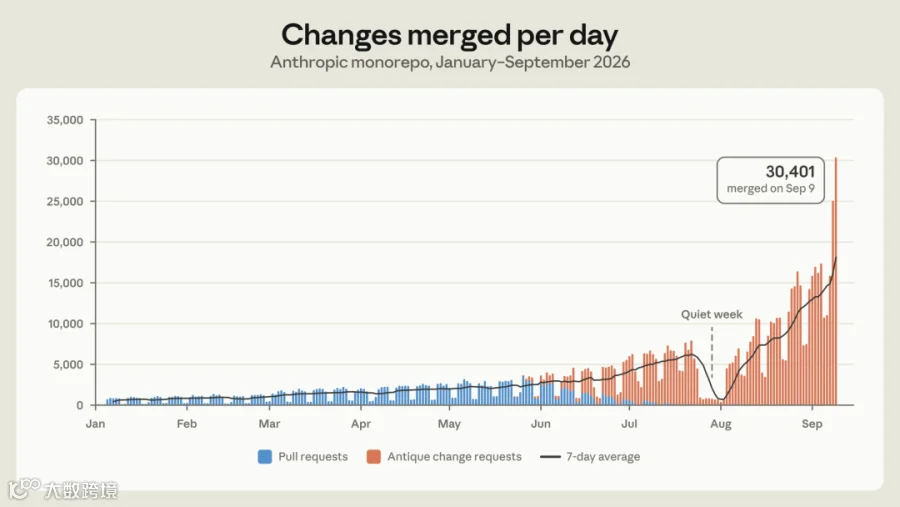
今年 5 月,Anthropic 日均合并代码变更约 2500 项,9 月已超 3 万项,CI 系统日均执行约 2500 万次代码检出。编码效率提升的同时,仓库准备、对象同步及历史查询带来的资源消耗急剧增加。
同期,GitHub 利用微调后的 ModernBERT 替代通用 LLM 进行密钥扫描判断;哥伦比亚大学与 Google DeepMind 等机构通过 BTTF 技术,将芯片仿真波形转化为 SQLite 数据,使 Agent 能利用 SQL 排查异常。
Scion 实现默认在线访问,BTTF 将波形转为查询接口,GitHub 则将高频判断交由分类器处理。原本围绕人类开发节奏设计的系统,正逐步适应 Agent 带来的新型负载。

01


Git 的离线能力,为什么成了负担

Git 的分布式设计支持工程师在断网环境下提交、合并及查看历史。然而,Anthropic 大量读取代码的任务依赖于始终联网的 CI 作业和 Agent 沙箱,这些任务运行几分钟即销毁,往往仅需获取少量文件、Diff 或确认提交关系。为此准备本地仓库导致了高昂的重复成本。
Anthropic 主分支历史接近 100 GB,压缩工作副本超 25 GB。若每日 2500 万次检出均获取完整副本,理论流量将超 600 PB。尽管公司采用了浅克隆、稀疏检出、快照及数百台 Git 镜像等措施,但镜像同步、快照过期及历史查询仍需补齐对象,仓库越活跃,维护成本越高。
Scion 将客户端简化为轻量入口,把提交创建、合并、变基与历史查询移至中心服务。本地仅监测文件变化并维护少量缓存,需工作目录时按需展开。CI 若仅需计算 Diff,可直接调用 API,无需完整检出。此举虽牺牲了离线自治能力,但大幅减少了重复初始化开销。
提交格式亦发生变更。Git commit 指向描述仓库状态的目录树,而 Scion 的 changeset 则以预写日志条目记录相对首个父提交修改过的文件,并通过内容寻址指针引用数据。
创建 changeset 无需生成 Git packfile,也无需立即移动共享分支。仅在 main 等引用更新时,系统才对 Spanner 中的单行记录执行 compare-and-swap 操作。Agent 可并发生成变更,竞争集中发生在分支引用移动阶段。
历史查询仍面临挑战:增量记录无法直接回答某行代码的修改者或文件演变史。Scion 为 blame、路径历史与提交图跳表维护衍生数据(derived data),按父提交关系预计算或在查询发生后生成,从而实现写入与历史分析的独立扩展。
检出时,scn 客户端从目标目录树开始,仅请求缺失的 tree 和 blob。请求依次经过节点上的 scion-daemon、区域 scion-cache,再由 scion-server 回源至 Spanner 或对象存储。
由于对象写入后不可变,缓存可跨任务复用,减少协商、压缩及反复传输。Anthropic 表示缓存命中率超 99%,并有效限制了故障时的回源流量。
迁移后,Scion 相较旧 Git 镜像体系的 CPU 和内存需求缩小约 200 倍,检出时间从分钟级降至秒级,CI 释放了约 25% 的 CPU 容量。
需注意,200 倍指的是基础设施资源占用的降低,而非 Git 操作整体提速。Anthropic 还同步建设了 Antique 代码评审、源码搜索、IAM 和批量合并工具以适配新协议,在线服务的维护也成为新的成本项。

02


让数据库读波形,Agent 才能追查故障

芯片验证面临另一重障碍。RTL 仿真产生的 VCD、FSDB 波形记录了海量信号随时间变化的状态,复杂设计的转储文件可达数十 GB 甚至 TB 级。
工程师可通过波形查看器沿时间轴寻找异常,但若 Agent 将原始波形转换为文本,上下文很快会被时间戳、信号名和重复跳变占满。追查其他信号时,还可能造成文件的重复读取。
此外,人类习惯在图表中“大海捞针”,但 Agent 再大的上下文也无法容纳几十 GB 的物理文件。因此,将这些“死文件”转化为可被 SQL 精准调用的“活接口”,是向 AI 提供数据的最优解。
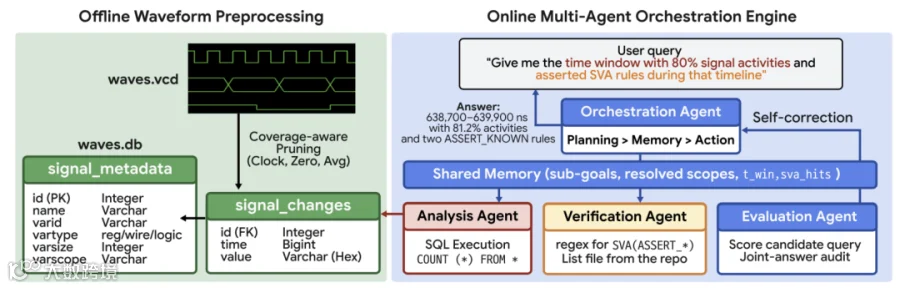
BTTF 将数据访问交给 SQLite。signal_metadata 表保存信号名称、类型和层级等静态信息,signal_changes 表记录信号 ID、时间戳和变化后的值,两表通过 ID 关联。
查询某信号在指定时刻的状态时,SQL 找到该时刻之前最近的变化记录;若要检查一段时间内的翻转,则按时间窗过滤与聚合。需注意,两次跳变之间状态不变,不能将无新记录误判为未知。
模型只需处理问题与少量返回事件。例如某段握手协议超时,Agent 可先检索请求与响应信号的变化,缩小至异常区间并检查时序关系。数据库负责检索,模型决定下一步查询内容。查询需对齐信号 ID、时间单位与 RTL 版本。
然而,将波形导入数据库并不能自动消除压力。高频时钟产生密集记录,逐行 INSERT 存在事务成本。BTTF 在摄取时建立波形标识到数据库 ID 的映射,统计信号跳变,并结合时钟过滤、无跳变信号裁剪和批量插入技术。
未裁剪数据库占用 1420 MB,查询耗时约 410.5 毫秒;过滤时钟和无跳变信号后,规模降至 395 MB,耗时降至 94.8 毫秒。若继续删除低跳变率信号,数据库可缩至 185 MB,但活动覆盖率仅剩 64.23%。
罕见故障可能恰好出现在几乎不翻转的控制信号上。若数据在导入阶段被删除,Agent 将无法恢复证据。因此,数据裁剪需服从断言与调试需求。
具备 SQL 接口后,BTTF 安排不同 Agent 分工:Orchestration Agent 拆解任务,Analysis Agent 生成查询,Verification Agent 检查断言并关联 RTL 源码,Evaluation Agent 核查时间范围、字段关系与结果完整性。
例如 ASSERT_KNOWN 发现信号出现 X/Z 未知状态,系统先锁定违规时刻,再向前检查相关操作数状态,逐步定位可能模块。若 SQL 出错,修正后可继续执行。
研究团队在 4.2 GB 波形、18450 个信号和 150 条专家标注查询的实验中,取得 95.33% 的执行准确率。Multi-Agent 质量评分比单 Agent 提高 17.3%,平均延迟增至约 1.96 倍,静态 SVA 检查准确率为 84.62%。该方案支持后仿真分析,但持续摄取与复杂归因仍需进一步验证。

03


为什么密钥扫描换回了分类器

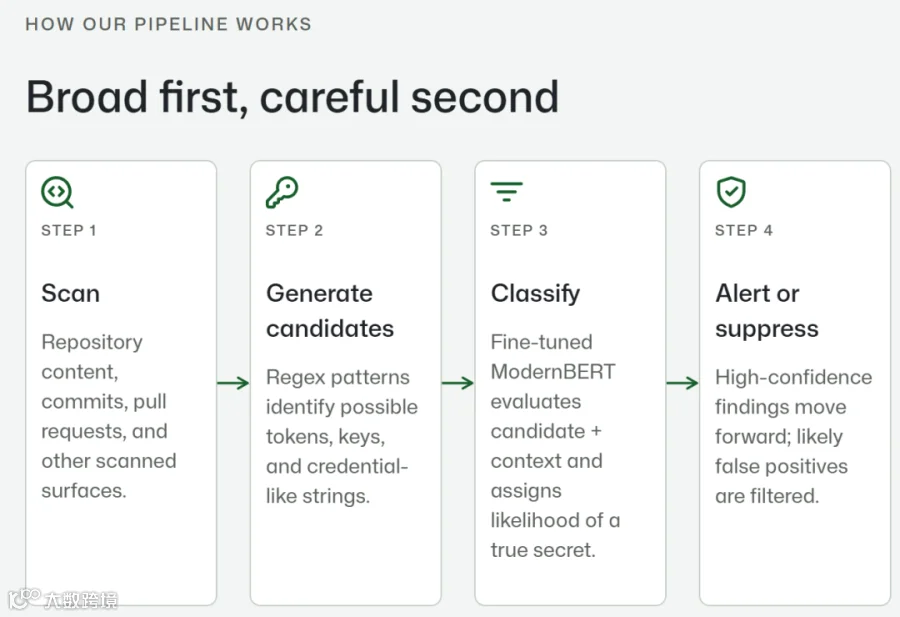
高熵字符串可能是真实凭据,也可能是测试数据、占位符或校验和。正则表达式能快速定位可疑格式,但不擅长判断代码上下文;通用 LLM 虽可辅助区分,但随着候选数量增加,推理费用和延迟不断累积。对于需在代码提交前给出结果的 Push Protection 而言,这种等待直接影响开发体验。
GitHub 保留正则作为候选入口,将后续判断交给微调后的 ModernBERT。它读取候选字符串、密钥类型、变量名、文件路径和附近代码,输出风险分类得分,再由阈值决定是否告警。编码器经前向计算即可返回类别,无需像生成式 LLM 那样逐 token 输出解释,适合批量处理同类请求。
难点在于处理 hard negatives(难负样本):即字符串很像密钥但实际无害的示例。GitHub 组合产品反馈、人工标注、真实仓库中的高召回候选以及专门合成的困难负样本,并按仓库、候选值和关联关系划分训练与评估集,以减少相似数据带来的评估偏差,避免模型仅记住文件名而无法辨认陌生项目中的凭据。
部署时,模型导出为 ONNX 并进行 8 位量化,以降低推理资源开销。阈值需结合 Precision、Recall 与线上流量校准:过宽导致误报,过严则可能漏报真实密钥。出现新密钥格式时,还需更新训练集和规则。
相较旧 LLM 管线,新方案离线 Precision 提高 13%,Recall 提高 19%。线上 A/B 实验显示,Post-push 扫描执行时间中位数下降 86%,模型服务成本下降超 98%,按仓库所有者加权的告警接受指标提高 11.5%。
需注意,98% 指模型服务费用降低,并非整套安全系统总成本。分类器仅能判断正则找到的候选,前置规则的覆盖范围仍限制漏报表现。
规则发现线索,分类器完成判断,开放式分析仍可交给通用 LLM,从而避免每次固定判断都承担生成式推理成本。

04


接下来可能轮到 CI

GitHub 缩短了安全扫描的反馈时间,但代码后续仍要经过构建、测试和部署。Anthropic 在解决源码检出问题后,也遇到新麻烦:一轮测试尚未结束,主分支可能已合入数百甚至数千项修改。
继续依赖全局锁会导致变更积压,放开并发又带来新风险。即便某次测试已通过,其对应的代码状态也可能与准备部署的版本存在差异。
这意味着 CI 接下来需解决验证结果如何在高频变更中保持有效的问题。构建缓存需识别源码与依赖关系的变化,测试记录必须关联具体提交和构建产物,系统还要判断哪些结果可复用、哪些修改会使此前验证失效。对于依赖复杂的 Monorepo,仅增加测试机器难以解决并发修改带来的版本一致性问题。
Anthropic 已开始强化合并后测试与部署前验证。对普通团队而言,完善依赖分析、增量测试和构建缓存,比直接重建版本控制系统更为现实。
随着 Agent 持续提高代码产出,软件工程的瓶颈将沿交付链路向后移动。代码进入主分支的速度可以越来越快,但构建、测试与部署之间必须保留可靠的验证关系。
未来可能会有越来越多的例子说明,AI 写代码的狂飙突进,最终倒逼着整条软件工程流水线被迫“重做一遍”。工程基础设施的价值,也将更多体现在能否让高速变化的代码持续获得可信的交付依据。
参考链接:https://www.anthropic.com/engineering/redesigning-source-control

上车,带你看遍全球 AI 顶会精华

可独家畅览:

专家演讲PPT

大会报告全文

热门论文解读

学术新星访谈

//

推荐阅读

深度拆解 Sonnet 5.5 :半价 Opus 只是表象,Agent Runtime 才是变化核心

GPT-6 丝滑「上身」宇树 G1,斯坦福把机器人控制链封装成了一套「专属 API」

未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8994
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读278.0k
粉丝0
内容9.0k