痛点:通用大模型在财税凭证识别中的局限
凭证识别是财务报销等业务中经济事项判断的核心环节,精准的票据识别对医院报销等业务的智能化至关重要。此前,行业多采用Kimi等通用大模型进行票证识别与要素抽取,但在深入财税业务场景后,面对复杂的票种、专业的业务语义及多样的附件组合,逐渐暴露出三大瓶颈:
1. 准确率遭遇瓶颈:以医院报销为例,原有云端方案分类准确率不足60%,长尾凭证识别精度更低,导致人工复核与纠错成本高企。
2. 模型稳定性不足:面对版式变化、新增票种或跨域迁移时,识别结果波动明显,置信度不可靠,难以支撑稳定的自动审核策略。
3. 响应速度滞后:多页附件和长文档的OCR解析、分类及要素抽取链路耗时较长,单次识别动辄数分钟,无法满足高并发、实时交互的业务需求。
上述问题反映了通用模型能力与财税专业要求之间的差距。为此,博思软件正式推出坤元票证识别模型(ky-voucher-ocr)。该模型面向财税凭证智能处理,提供分类识别与要素抽取两大核心能力,支持图片、PDF、OFD、DOCX等主流格式,旨在让每一次识别更准确、可控且高效。
一、业务需求:经济事项凭证识别的核心能力
针对医院、政府及财政机构票据格式千差万别的现状,单一的识别方案难以适配所有场景。坤元票证识别模型围绕以下三大核心需求构建技术闭环:
1. 认得出——明确附件类型:覆盖费用类凭证、医疗业务凭证、非税票据、国内外发票、合同清单及各类附件文档,解决传统方案仅能覆盖高频票种、长尾附件需人工兜底的问题。
2. 读得懂——精准抽取字段:精确提取金额、日期、交易明细等结构化字段,直接对接业务系统完成自动验真、填单及审核。
3. 靠得住——结果可信可控:在高准确性与合规性要求下,模型能自动区分“高置信可放行”与“疑难需人审”样本,优化人工审核资源配置。
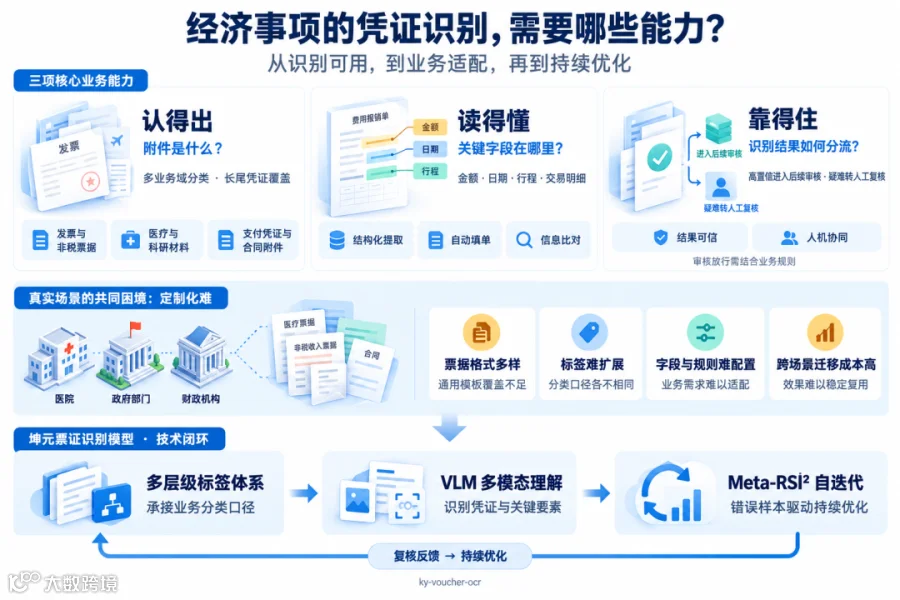
基于此,坤元模型形成了“多层级标签体系 + VLM多模态理解 + Meta-RSI²自迭代”的技术架构。
二、坤元票证识别模型的核心能力
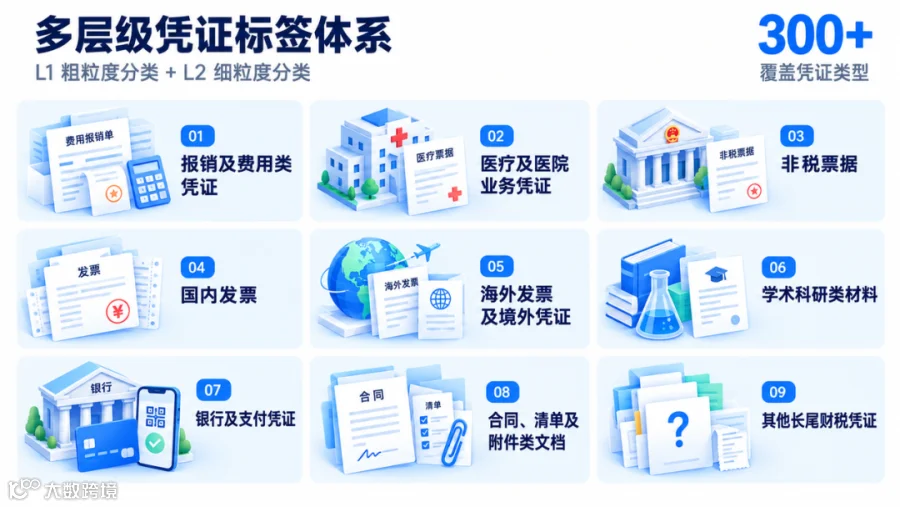
01 构建财税领域多层级标签体系,覆盖近300类凭证类型
针对财税文档种类多、版式差异大、业务语义复杂的特点,建立统一的多层级文档标签体系。采用层级化分类,将大类业务语义与细粒度凭证类型拆分,通过L1粗粒度+L2细粒度分类降低难度,目前已累计覆盖近300种凭证类型。
02 VLM超长多模态文档理解,一次请求读懂百页材料
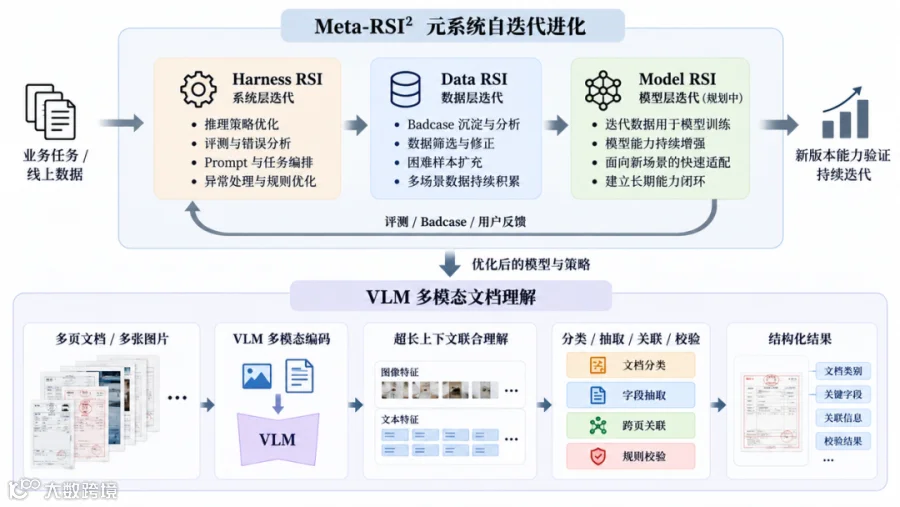
传统识别采用“OCR→分类→规则解析”的多阶段流水线,误差层层累积且无法关联跨页信息。坤元基于VLM(视觉语言模型)构建统一多模态理解能力,实现代际跨越:
- 单次请求支持处理约15张图片,目标能力提升至百张级别;
- 基于视觉信息和文本语义联合完成文档分类、字段抽取及跨页关联;
- 支持不同版式、分辨率及复杂表格等非结构化输入;
- 减少多阶段链路中的误差累积,利用跨页信息联合判断,更适配复杂财税材料与长文档任务。
03 Meta-RSI²元系统自迭代进化,模型“越用越聪明”
为解决传统模型Badcase依赖人工排查、优化滞后的痛点,坤元模型构建了Meta-RSI²自迭代体系,实现基于实际任务反馈的持续优化:
- Harness层RSI:自动分析任务执行链路、Prompt、推理策略及结果校验,根据Badcase优化执行策略;
- Data层RSI:自动沉淀线上Badcase、困难样本与边界样本,通过筛选、纠错、补充形成数据闭环;
- Model层RSI:将高质量迭代数据反馈至训练环节,形成“系统→数据→模型”的持续进化闭环。
实测效果:在某保险报案场景中,通过持续自动迭代,整体识别准确率由91.94%提升至98.17%。在4475条样本对比测试中,人工审核量由605条降至440条,减少约27.3%,约90.17%的数据可自动完成审核,同时风险样本召回率保持在约73%,实现了审核效率与风控质量的双赢。
04 多场景泛化能力,降低冷启动成本
针对凭证版式迭代快、长尾类别多的痛点,坤元模型具备优秀的长尾文档泛化与跨类别迁移能力。面对新增版式或相似凭证,模型可通过Zero-shot零样本方式直接识别;针对差异较大的新场景,依托少量样本注入与自动迭代快速适配。在约300条跨类别样本评测中,整体识别准确率达到91%以上,大幅提升了新场景上线效率。
三、模型能力评测结果对比
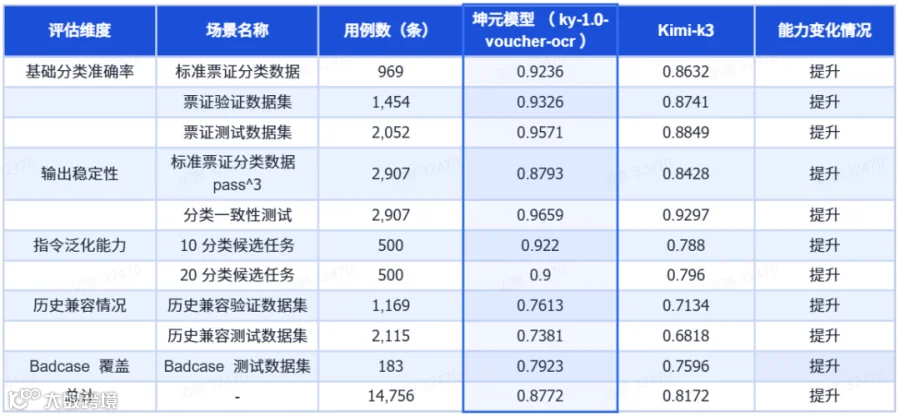
相较于通用模型,坤元票证识别模型在准确性、稳定性和速度上均有显著优势:
1. 更准:高优类别精准突破,易错长尾同步收敛
- 票证分类:在标准数据集中,坤元模型分类准确率达92.36%,较Kimi-k3(86.32%)提升6个百分点。
- Badcase准确率:在近200条包含高频易错、易混淆及长尾票据的评测集中,坤元模型准确率为79.23%,较Kimi-k3提升3.2个百分点。
2. 更稳:复杂版式稳健适配,跨域新类泛化可靠
- 输出稳定性:坤元模型pass^3(三次推理全部正确)通过率达87.93%,较Kimi-k3提升3.7个百分点;分类一致性得分0.9659,提升3.6个百分点。
- 指令泛化能力:在20分类候选任务中,坤元模型得分0.9,较Kimi-k3提升10个百分点。
3. 更快:时延分级可控,支持私有化部署
- 图片及小文件(5页以内):总耗时控制在6秒以内,较Kimi-k3(约10秒)下降近40%。
- 中长文档(16–64页):总耗时稳定在20-30秒,较Kimi-k3(30–55秒)下降50%。
- 长文档(64页以上):总耗时约1–2分钟,与Kimi-k3基本持平,保持服务稳定性。
此外,坤元模型支持私有化部署与弹性扩容,可随业务峰值调度算力,满足数据不出域的合规要求,从容应对批量归档、集中审核等高并发场景。
四、典型案例:从技术领先到客户应用价值
博思“智能报销”系统应用实践
大型公立医院报销业务中,原始凭证类型跨度极大,包括发票、行程单、合同、科研材料等,样式差异显著。接入坤元模型前,传统方案分类准确率不足60%,处理时长分钟级,严重依赖人工二次判断。
接入坤元票证识别模型后,基于多家医院近2000+条现场样本实测,成效显著:
1. 识别更准:附件分类与要素抽取综合准确率达到93%+,核心高频凭证识别准确率达到95%+;
2. 效率更高:依托智能审核分流机制,超90%的凭证可自动审核放行,审核人员仅需聚焦疑难与高风险样本;
3. 速度更快:5页以内文件的平均处理时长由分钟级降至6秒以内,大幅优化职工报销体验。
目前,坤元票证识别模型已接入华西医院、福建省人民医院、重庆中医院等9家机构,赋能智能报销、保险报案等多个智能体上线运营,累计识别凭证文件10万+张,在真实业务流量中得到了充分验证。
未来,坤元票证识别模型将持续围绕“更准、更稳、更快、更智能”迭代,丰富标签体系,增强长尾与跨域泛化能力,助力财税场景从流程数字化迈向审核智能化、运营数智化。
- END -
供稿丨AI研发中心、医疗智慧财务研发中心
编辑丨文化与品牌建设部-李健杰