


向AI转型的程序员都关注公众号 机器学习AI算法工程
文献来源:本文核心内容基于腾讯优图实验室团队 arXiv 的论文《YOLO-PEFT: Parameter-Efficient Fine-Tuning on YOLO Family》https://arxiv.org/pdf/2608.07051作者:林旭(Xu Lin)、聂文杰(WenJie Nie)、彭金龙(Jinlong Peng)、郑侠武(Xiawu Zheng)、刘勇(Yong Liu)等。代码已集成进腾讯开源项目YOLO-Master(github.com/Tencent/YOLO-Master,AGPL-3.0,入选腾讯犀鸟开源计划 2026)。
在 YOLO11s 上,老老实实把整个模型放开做全量微调,mAP50-95 是 0.6428。而只训大约 10% 的参数、用 LoRA 微调,成绩是 0.7138。
少的那 90% 参数不但没拖后腿,反而高出了 7 个点。
这不是某个数据集上的巧合,YOLO12s 上同样成立:0.6662 对 0.7307。而且 NVIDIA 那篇经典的 LoRA 论文里早就观察过类似现象——在相同数据、相同轮数下,全量微调更容易过拟合,LoRA 的"低秩约束"反而起到了正则化的作用,帮模型保住了预训练阶段学到的通用能力。
换句话说:对中小规模的下游数据集来说,全量微调很可能不是最优解,而是最容易踩的坑。
但 LoRA 有个一直没人好好解决的问题——到底该插在哪些层?
插多了参数省不下来,插少了精度上不去,插错位置直接训崩。绝大多数人的做法是:凭感觉试几组,跑不完就放弃了。腾讯优图这篇 YOLO-PEFT 要解决的,正是这件事。
这篇文章我想和大家讲清楚四件事:
第一,看懂它。YOLO-PEFT 到底做了什么,为什么"拒绝"比"硬上"更有价值。
第二,看清效果。精度、显存、时间三笔账,一笔一笔算给你看。
第三,判断适用性。什么场景该用,什么场景它自己会劝你别用。
第四,跑通它。从装环境到复现论文数字的完整命令,每一步都有判据。
老规矩,论文自报的数据我都会标出来源口径,不夸大。
一、问题的根源:从语言模型搬来的 PEFT,在检测器上会"静默失效"
LoRA 这套方法诞生于 NLP,服务的对象是结构高度规整的 Transformer:一堆同质的 Attention 和 MLP 堆在一起,往哪儿插适配器基本都成立。
但 YOLO 不是这样的结构。论文的用词很准——检测器的算子是异质的(heterogeneous),而且带着一堆 NLP 里根本不存在的检测专用组件。
我们拆开看看一个 YOLO 里都有什么:
|
|
|
|
|---|---|---|
| 检测头 |
|
|
| DFL / 框回归 |
|
|
| NMS / 后处理 |
|
|
| Stem 首层卷积 |
|
|
| 深度可分离卷积 |
|
|
论文里有个词特别传神:"fail silently"(静默失效)。
什么叫静默失效?不是报错,不是崩掉——是跑完了、loss 也降了、看起来挺正常,但精度就是上不去。你不知道是插错了层,还是数据有问题,还是学习率没调好,只能一遍遍试。
这才是真正耗时间的地方。报错不可怕,可怕的是"看起来没问题但结果就是差"。
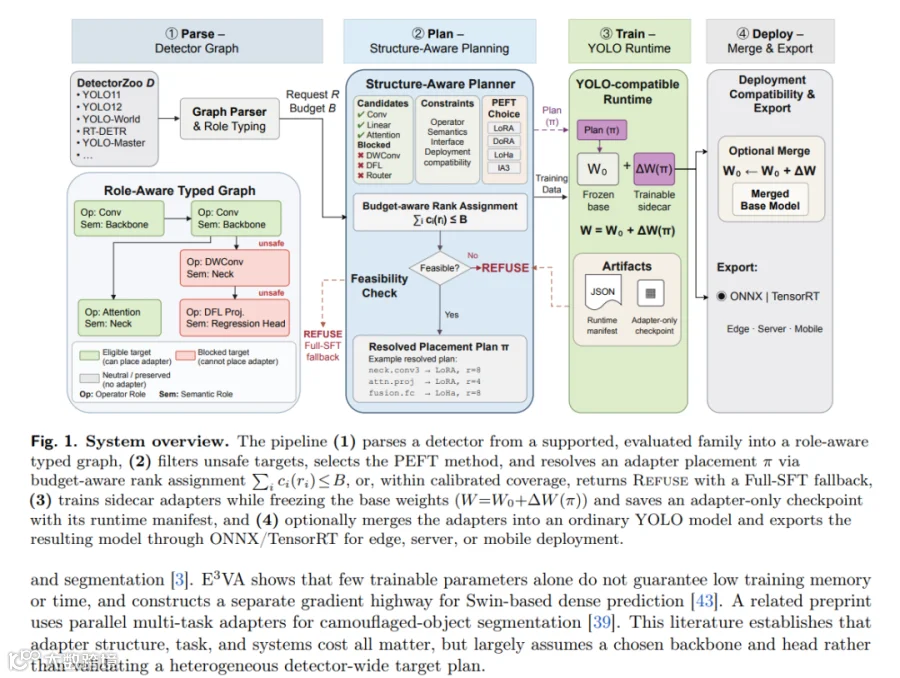
所以 YOLO-PEFT 的定位非常明确:它不是一种新的适配器结构,而是一套告诉你该往哪儿插的决策系统。
二、核心机制:把"插哪儿"变成一道可审计的规划题
YOLO-PEFT 的做法是:把适配器放置(adapter placement)建模成一个结构感知、可审计的约束规划问题。
输入三样东西:
-
一张检测器计算图(detector graph)——你的模型结构; -
一个PEFT 请求——你想用哪种适配器、多少 rank; -
一份资源预算——适配器参数上限是多少。
然后系统做四件事。这四步的设计我觉得比结果本身更有价值:
第一步:给每个算子判定"角色"
遍历计算图,给每个模块打上算子角色和语义角色。这一步是后续所有判断的基础——你得先知道这个模块是干什么的,才能判断能不能动它。
第二步:四类谓词逐条体检
对每个候选模块,跑四类显式检查:
|
|
|
|---|---|
| 算子合法性 |
|
| 检测语义 |
|
| 图接口 |
|
| 部署约束 |
|
第三步:排除谁,就写明理由
这是我觉得整篇论文最务实的一点:每一个被排除的模块,系统都会记录一个理由码(reason code)。
不是黑箱地给你一个结果,而是告诉你"第 15 层因为 XX 原因没被选中"。你可以检查、可以质疑、可以申诉。这也是标题里那个 "auditable(可审计)" 的含义。
第四步:该拒绝时就拒绝
如果所有候选配置都不满足约束,系统会在训练开始之前返回"Refuse(拒绝)",建议你改用全量微调。
这一点为什么重要?绝大多数论文的写法是"我们的方法在所有模型上都提升了"。但真实情况是——有些架构就是不适合 LoRA。
YOLO-PEFT 承认这一点,并且把"我不该上"做成了一个正式的输出分支。这是对工程负责的态度,比无脑吹自家的效果可信得多。
三、效果到底怎么样:三笔账分开算
3.1 精度账:比全量微调高出 7 个点
论文采用的是 VOC 的标准协议:VOC07+12 的 trainval 训练,VOC07 的 test 测试,指标为 mAP50-95。
|
|
Full-SFT |
RS-LoRA |
|
|---|---|---|---|
|
|
|
0.7138 | +0.0710 |
|
|
|
0.7307 | +0.0645 |
两个模型上,规划器选出的方案都明显超过全量微调,而且提升幅度相当一致。注意这里的关键是 "planner-selected(规划器选出的)"——不是随便插个 LoRA 就有这个效果,放置位置是决定性的。
3.2 显存账:峰值降 43.9%
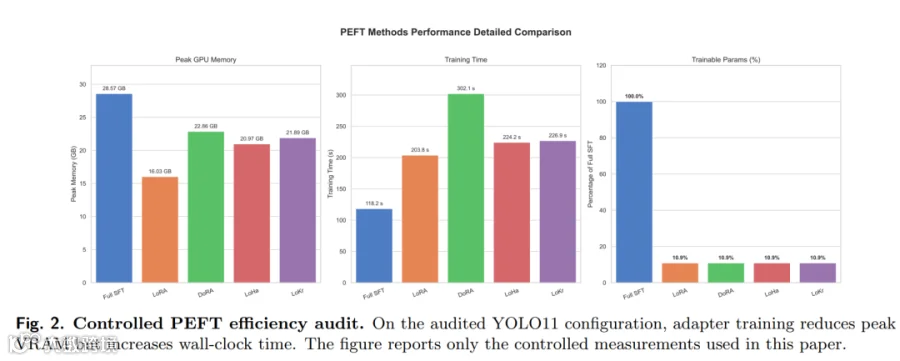
在一项受控的 YOLO11 审计中,LoRA 把峰值训练显存降低了 43.9%。
降 43.9% 意味着什么?假设原来全量微调要 16GB 峰值显存,现在大约 9GB 就够。一张 12GB 的 4070、甚至 8GB 的卡,就有机会训起来原本训不动的配置。
而且峰值显存降下来之后,你可以把原本用来"防炸显存"的余量换成更大的 batch 或更高的分辨率——这部分收益往往比显存本身更值钱。
3.3 时间账:这里是代价,别搞反了
同一份审计里,论文诚实报告了一个不利数字:训练时间是全量微调的 1.72 倍。
请务必记住:省显存 ≠ 省时间。
原因是适配器引入了额外的前向/反向计算图,加上梯度检查点(gradient checkpointing)会重算一部分激活值来换显存——典型的用时间换空间。
项目 README 也专门加了一句提醒:"Results depend on the model, adapter configuration, data, and hardware; training speedup is not guaranteed."
3.4 存储账:一套基座,N 个场景
这部分来自 YOLO-Master 仓库的实测(rank=8):
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| YOLO11x |
|
14.1 MB | 6.20% |
YOLO11x 上,部署 14.1 MB 的适配器替代 114.6 MB 的完整模型,存储省下约 87.7%。10 个任务只需 255.6 MB(1 个基座 + 10 个适配器),而传统做法是 1146 MB。
四、什么场景该用,什么场景别用
结合论文结论和仓库实测,我把适用性整理成下面这张表:
|
|
|
|
|---|---|---|
| 消费级显卡微调 |
|
|
| 单基座多场景 |
|
|
| 中小规模数据集 |
|
|
| 频繁迭代的线上模型 |
|
|
| 时间敏感的任务 |
|
|
| RT-DETR 等 Transformer 检测器 |
|
|
关于最后一行,值得单独说一句。RT-DETR-L 上,论文评测的七种 LoRA 系配置全部越过了预设的灾难性阈值,于是规划器给出的是经过校准的 "Refuse-to-Full-SFT" 决策——即"别用 LoRA,去做全量微调"。
这就是第三节第四步那个"拒绝"分支在真实实验中落地的结果。它真的会劝退。
五、训练步骤
下面这套命令全部来自 YOLO-Master 仓库的真实文件,按"先跑通、再上规划器、最后对齐论文"的顺序来。建议严格按阶段走,每阶段都有判据,别跳步。
阶段 0:装环境
conda create -n yolo_master python=3.11 -y
conda activate yolo_master

git clone https://github.com/Tencent/YOLO-Master
cd YOLO-Master

pip install -r requirements.txt
pip install -e .

# 可选:FlashAttention 加速训练(需要 CUDA)
pip install flash_attn判据:python -c "import ultralytics; print(ultralytics.__version__)" 能正常输出版本号。
阶段 1:准备数据与基线
先按 Ultralytics 标准的 YOLO 格式组织数据,写一个数据集 YAML。论文用的是 VOC07+12 trainval 训、VOC07 test 测的官方协议,你要对齐论文数字就得用同样的数据划分。
强烈建议先跑一次全量微调当基线。不然后面拿到 0.71 的分数,你不知道到底是 LoRA 的功劳,还是你的数据本来就容易出分。
# 全量微调基线
yolo train model=yolo11s.pt data=voc.yaml epochs=300 imgsz=640 batch=32判据:记录下 mAP50-95 和峰值显存(训练日志里会打印 GPU_mem),这两个数是你后面所有对比的锚点。
阶段 2:先跑一个普通 LoRA
直接用配置开启,不需要改模型结构——这是这套实现最省事的地方。
from ultralytics import YOLO

model = YOLO("yolo11s.pt")

results = model.train(
    data="voc.yaml",
    epochs=300,
    imgsz=640,
    batch=32,
    lora_r=16,                        # rank,仓库推荐 16
    lora_alpha=32,                    # alpha = 2 × r
    lora_dropout=0.1,
    lora_gradient_checkpointing=True,
)判据:训练日志里能看到可训练参数大幅下降(约 10% 量级),峰值显存相对阶段 1 明显降低。
阶段 3:打开论文主角——PEFT Planner
这一步才是 YOLO-PEFT 的核心。下面这条命令就是仓库复现脚本里给出的官方写法:
yolo train model=yolo11s.pt data=coco.yaml lora_r=16 lora_use_rslora=True \
  lora_planner_enabled=True lora_planner_backend=vpeft
三个开关的含义:
|
|
|
|---|---|
lora_planner_enabled=True |
|
lora_planner_backend=vpeft |
legacy,必须显式改成 vpeft 才是论文那套
|
lora_use_rslora=True |
|
最容易漏的一步:lora_planner_backend 的默认值是 legacy,不是 vpeft。论文的规划器是 opt-in(需显式开启) 的,为的是向后兼容。你要是不显式指定,跑的就不是论文那套东西,分数对不上别怪方法。
阶段 4:补齐论文默认的三个训练技巧
在 ultralytics/cfg/default.yaml 里,有几个参数被明确标注为 "PAPER DEFAULT",是论文方法的一部分,不是可选装饰:
lora_alpha_warmup: 3      # 前 3 个 epoch 线性预热 LoRA alpha(论文默认 3)
lora_layer_decay: 0.85    # 逐层学习率衰减(论文默认 0.85)
                          # 注释里写明:这是论文核心贡献之一,也是消融中
                          # 最强的单项增益
lora_lr_mult: 2.0         # LoRA 参数的学习率是基座的 2 倍
尤其 lora_layer_decay=0.85——配置项注释里直接写着 "layer-decay is a core paper contribution and strongest single addition in ablations"。要对齐论文效果,这三个别省。
阶段 5:按你的场景选 rank
仓库在 RTX 5070 Ti 上跑了 rank 矩阵,结论是反直觉的:
|
|
|
|
|
|---|---|---|---|
|
|
4 | 0.5232 |
|
|
|
|
|
|
|
|
|
|
|
|
|
16 | 0.1646 |
|
简单任务用小 rank,复杂任务用大 rank。脑瘤数据特征单一,rank 越大反而过拟合(0.5232 → 0.4989);VisDrone 满屏密集小目标,rank 从 4 提到 16,mAP50 提升 25.4%,而显存只多了不到 0.1 GB。
阶段 6:小数据集开 few-shot 模式
如果你的标注数据很少(几百张量级),可以开启专门的 few-shot 分支,它换了一套正则化策略:
lora_few_shot_mode=True               # 开启少样本增强正则
lora_few_shot_dropconnect=0.1         # 用 DropConnect(小数据上优于 dropout)
lora_few_shot_adaptive_rank=True      # 按数据稀缺程度自动调 rank

# 有教师模型时,可叠加知识蒸馏
lora_few_shot_teacher="yolo11x.pt"
lora_few_shot_distill_weight=0.5
注意 DropConnect 是这里的默认推荐——配置注释里写明,在数据量有限时它比 dropout 更有效。
阶段 7:验证、保存适配器、导出部署
from ultralytics import YOLO

# 1. 验证
model = YOLO("yolo11s.pt")
metrics = model.val(data="voc.yaml", save_json=True)
print(metrics.box.map)        # mAP50-95,和阶段 1 的基线比

# 2. 只保存 LoRA 适配器(YOLO11s 约 4.1MB)
model.save_lora_only("yolo11s_lora_r16")判据:适配器目录里有文件、体积在 MB 量级(不是百 MB),说明保存的是适配器而非完整模型。仓库默认 lora_save_adapters=True,输出目录名 lora_adapter。
阶段 8:核对论文数字
仓库把论文的声明数字冻结在了一个 JSON 里,并提供校验命令,防止 README 与论文漂移:
# 校验 README / default.yaml 与冻结声明是否一致
python scripts/reproduce_yolo_peft_paper.py --check-anchor

# 打印论文复现入口
python scripts/reproduce_yolo_peft_paper.py --protocol

# 汇总多轮实验做审计
python scripts/paper_experiment_audit.py --runs runs/*/runs.json --report reports/paper_audit.json需要说清楚的一点:这个脚本不会重跑论文的训练流程,它只校验仓库里的数字与冻结声明是否一致(锚文件里 status 写的是 claims_frozen)。真正的复现入口是 --protocol 列出的那几个验证脚本(YOLO11s / YOLO12s / RT-DETR-L 各一个)。
三个官方点名的坑
① 医学影像的通道问题。MRI/CT 是单通道灰度图,而 YOLO 默认按 3 通道 RGB 读。要么在数据管道里做通道对齐,要么用 ch=1 的自定义卷积配置,否则输入从头就错了。
② 遥感影像的尺度问题。航拍图尺度变化极端,务必开启内置的 Sparse SAHI 稀疏推理,或训练时设 rect: true。同时把骨干网的降维层和 MoE 专家的 MLP 一起放进 lora_target_modules,给空间局部特征足够的自由度。
③ 别碰未归一化的 stem 层。配置项 lora_skip_stem 默认就是 True,注释写得很直白:跳过 stem 是为了防止第一层卷积在 FP16 下出 NaN。除非你清楚自己在做什么,别改它。
六、写在最后
回头看 YOLO-PEFT 真正有价值的地方,我觉得不只是"LoRA 能省显存"这个结论——这个结论大家早就知道。
它真正解决的是那个没人愿意做的脏活:把"插哪儿"从玄学变成了有据可查的流程。每一处排除都有理由码,每一次决策都能追溯,该拒绝时明确拒绝。这让 PEFT 从"试试看"变成了"可以交付"。
机器学习算法AI大数据技术
搜索公众号添加: datanlp
长按图片,识别二维码
阅读过本文的人还看了以下文章:
【模型高效部署】tensorrtx 深度解读,yolov11高性能推理实战案例
实时语义分割ENet算法,提取书本/票据边缘
整理开源的中文大语言模型,以规模较小、可私有化部署、训练成本较低的模型为主
《大语言模型》PDF下载
动手学深度学习-(李沐)PyTorch版本
基于40万表格数据集TableBank,用MaskRCNN做表格检测
《基于深度学习的自然语言处理》中/英PDF
Deep Learning 中文版初版-周志华团队
【全套视频课】最全的目标检测算法系列讲解,通俗易懂!
《深度学习入门:基于Python的理论与实现》高清中文PDF+源码
python就业班学习视频,从入门到实战项目
2019最新《PyTorch自然语言处理》英、中文版PDF+源码
《21个项目玩转深度学习:基于TensorFlow的实践详解》完整版PDF+附书代码
《深度学习之pytorch》pdf+附书源码
《Python数据分析与挖掘实战》PDF+完整源码
不断更新资源
深度学习、机器学习、数据分析、python
搜索公众号添加: datayx
