

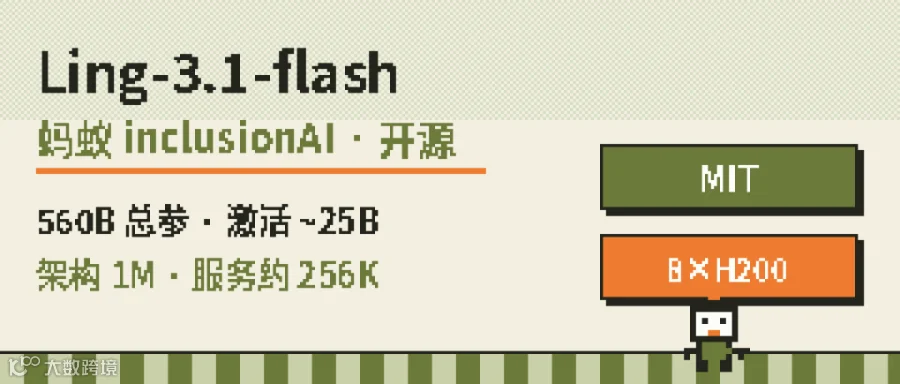
10 月 14 日,蚂蚁 inclusionAI 把 Ling-3.1-flash 开源了。官方 X 账号 @AntLingAGI 写得很直白:总参大约 560B,每个 token 大约激活 25B,上下文最高宣称到 1M;定位是把一份粗 brief 变成页面、移动 UI 或可交互原型,给团队接着改。权重在 Hugging Face:inclusionAI/Ling-3.1-flash,许可证 MIT。
下面按「能干嘛 → 对做应用的人意味着什么 → 冷水」拆。官方和模型卡自己报的数字,我会标出处,不当成第三方复现。另外先把话说死:开源不等于笔记本随便跑。
01
PART
它能干嘛
WHAT IT DOES

先看官方给它贴的标签。Ant Ling 开发者文档把 Ling-3.1-flash 写成新一代混合推理模型,面向日常办公、长周期软件开发和复杂 Agent。架构是 Hybrid-linear MoE:总参 560B、激活约 25B;模型卡还写了 63 层 KDA + 9 层 Gated MLA(约 7:1)、512 个路由专家、1 个共享专家、每次激活 8 个专家。相对同系列的 Ling-3.0-flash(文档表里是总参约 124B、激活约 5.1B),这一代是明显加厚容量、同时把激活抬到约 25B 的一代。同页还把 Ling-3.0-flash-VL(多模态、激活约 5.5B)和 Ling-2.6-1T(总参约 1T、激活约 63B)列在旁边——今天这篇只盯 3.1-flash 文本线,不把 VL 和 1T 混进同一套上手预期。
官方 X 演示叙事很「产品向」:给一份粗糙 brief,模型吐出页面、移动端界面或可交互原型,团队再审再改。文档里的用例也顺着这条线展开——办公协作、软件工程、专业咨询。它还点名在 Claude Code、Kilo Code、Qwen Code、Hermes Agent、OpenClaw 等框架里「体验不错」——这是厂商说法,写进来是为了让你知道他们押注的是 Agent / 长任务链路,不是单纯刷一道题榜。
560B
总参数量
~25B
每 token 激活
256K
官方服务窗
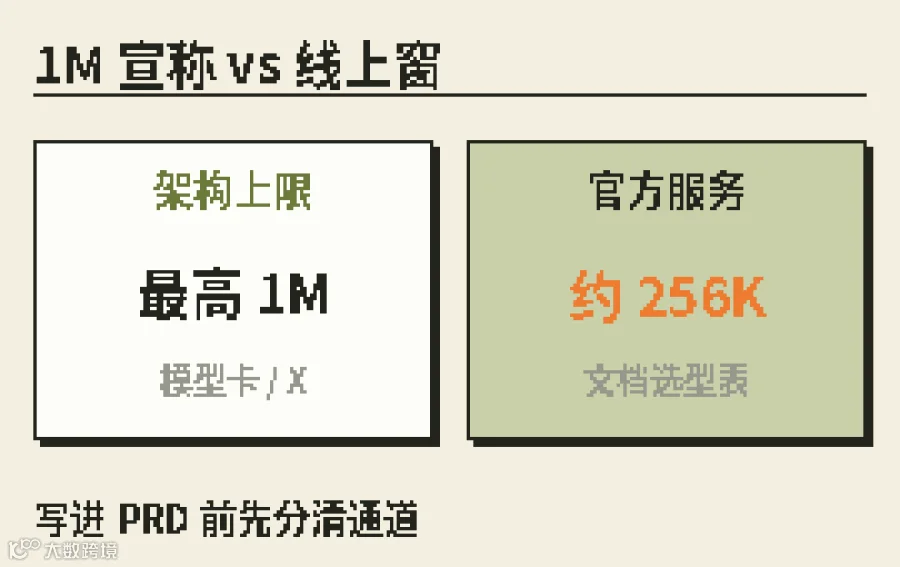
上下文这件事要拆开看。模型卡和 X 都写「最高到 1M」。开发者文档选型表把 Ling-3.1-flash 的 Context 写成 256K,正文又补了一句:架构上限 1M,官方服务当前暴露约 256K。两套数字并存。做应用的人真正该记的是:你线上能申请到的窗,以当前服务暴露为准;本地自托管才可能去碰架构上限——前提是你有显存和工程预算。
模型卡还列了一串自报评测名:GDPVal-AA V2.1、HealthBench Professional、FrontierSWE、Terminal-Bench 4.0,以及 SWE-bench Pro、Automationbench、MCP-Atlas、SkillsBench 等。我只记「官方认为自己强在办公、医疗、软件工程、终端工具用」这一方向,不把分数抄进你的采购 PPT。他们还提到自研 harness LingCode(基于开源 coding agent Pi),说在长时间、上百轮工具调用、反复压缩上下文的任务上有增益,并考虑未来开源——目前是「考虑」,不是已交付。
它想当的是「长周期工程 + Agent」助手,不是聊天里甩一句漂亮话就收工的那种。
02
PART
对做应用的人意味着什么
WHY IT MATTERS

上手大概就三条路,预期别混着定。
第一条:只想先摸手感。去 Hugging Face 看模型卡、许可证和分片清单;有官方 API / 第三方托管就先用服务端窗试 brief→页面 / 原型这种任务。MIT 意味着你可以自托管、二次分发,但「能下载」和「你的机器跑得动」是两回事。
第二条:要接进现网 Agent。官方推荐 day-0 镜像 lmsysorg/sglang:dev-ling-3.1-flash,示例是 8×H200、--tp 8 --ep 8,并带 MTP/NEXTN 投机解码;4×GB300 则改 --tp 4 --ep 4。文档还给了 vLLM 路线:拉指定分支、--tensor-parallel-size 8、--enable-expert-parallel,工具与推理解析器用 ling3。采样建议:temperature=1.0、top_p=0.95、top_k=20,并打开 enable_thinking。翻译成人话:默认你在机房级 GPU 上跑,不是消费级单卡。
第三条:人在 IDE 里带着它干活。若你已经在用 Claude Code / 同类 Agent 壳,官方叙事是「兼容这些框架」;验收仍应用你自己的仓库任务。长任务要盯三件事:工具调用是否稳定、上下文压缩后目标还在不在、中间结果出错时会不会自我纠正。
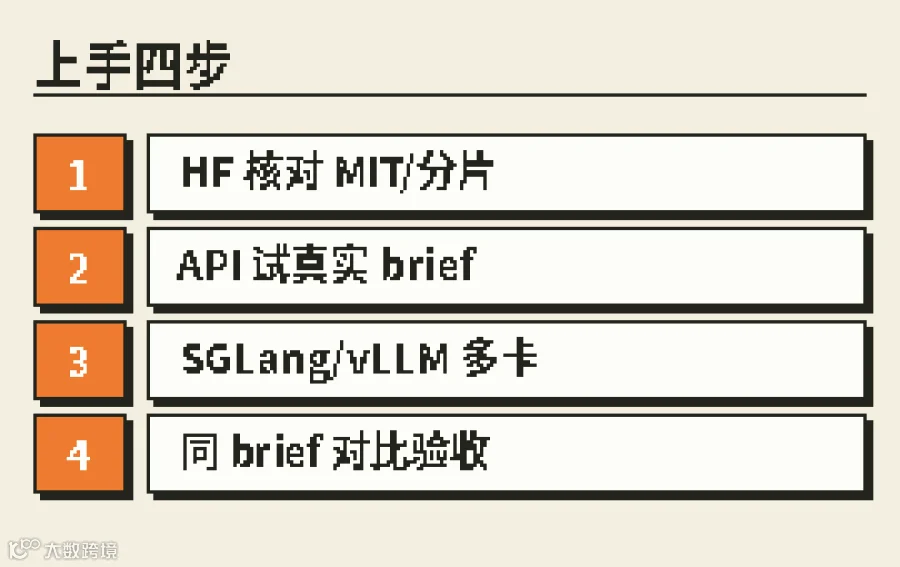
上手我建议按真实任务拆,别一上来全栈换模。① 选一个真实 brief,规定交付物;② 先走托管 API 或小规模评测,确认 thinking 与超时;③ 要自托管再上 SGLang/vLLM;④ 用同一套 brief 对比现用旗舰或 Ling-3.0-flash。
再补两件容易漏的。thinking 开关不是装饰——延迟敏感流水线别全程开。工具解析器名字是 ling3,迁移时别沿用别家 parser 硬套。评测集至少加三类:半页需求的前端草图、故意给错误反馈的小重构、要查文档再汇总的办公研究。
和本号最近写的两篇对照着看会更清楚。昨天 Gemini 4 Argon 是闭源旗舰放量:统一 1M 窗、付费 API、Free/Pro API 档用不了。今天这篇是开源 MoE:权重能下、许可宽松,但部署门槛在显存与工程。再往前 Step 5 也是「大总参、小激活」叙事;Ling-3.1-flash 同样走这条路,只是激活抬到约 25B,任务叙事更偏「brief→可交互产物」。
成本结构要诚实。自托管看卡时与电费;走官方服务以当前约 256K 窗做产品设计。还有一个产品决策:你到底是买「完成率」,还是买「每秒 token」。文档把 3.1-flash 推向长周期;把 3.0-flash 写成高 TPS。任务匹配不对,旗舰情绪很贵。
03
PART
冷水该泼哪
COLD WATER
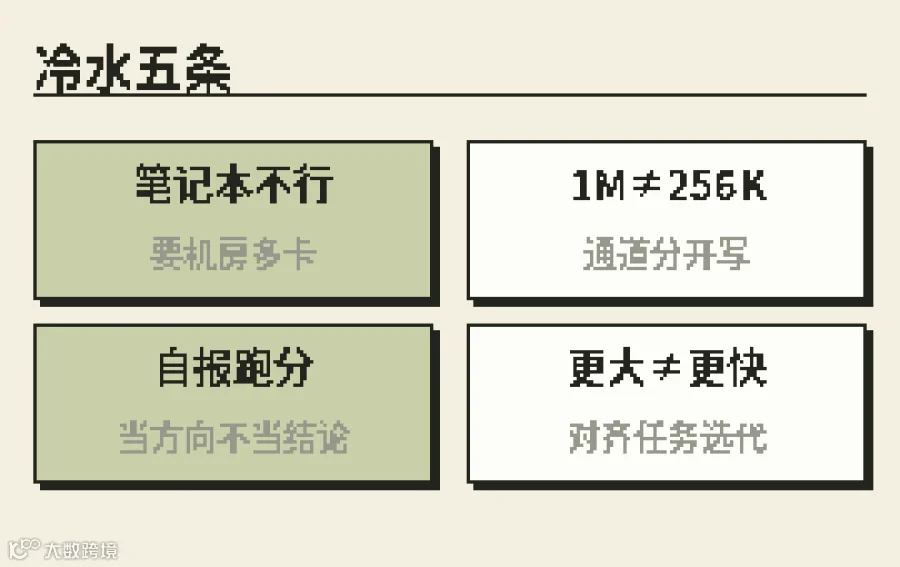
第一盆:开源了,笔记本跑不了。官方推理示例直接站在 8×H200 / 4×GB300 这类拓扑上。权重分片在 HF 上是几十份 safetensors,体量巨大。把它理解成「研究与机房可复现」,不是「下班回家单卡微调玩一玩」。
第二盆:1M 和 256K 不是一句话。架构宣称最高 1M;官方服务当前暴露约 256K。写进对外承诺前,先问清楚你用的是哪条通道。
第三盆:自报跑分先打折。模型卡上的一串榜单名,在同 harness、同提示词的独立复现出来之前,只当「厂商认为自己强在哪」。
第四盆:上一代对照别神话。激活从约 5.1B 到约 25B 会改变延迟与吞吐画像。别默认「更大一定更快更便宜」。
第五盆:许可宽松 ≠ 合规做完。MIT 对分发友好,对客 Agent 仍要过内容安全、日志、工具权限和不可逆动作人审。
第六盆:生态承诺要拆开读。「多框架体验好」是兼容性叙事;LingCode「考虑开源」是路线图语气。写进 OKR 的只能是你已经跑通的那条路。
装卡之前再确认三件事:是不是真需要 560B 级容量;窗是不是必须碰 1M;有没有人愿意当确认人。
CHECKLIST
HF 核对 MIT/分片 → 记下 560B/25B/服务端约 256K → API 试真实 brief → SGLang/vLLM 多卡 → 同 brief 对比验收 → 不可逆动作过人 → 对外文案分开写架构上限与服务窗。
照着做可以按这张单子:打开 HF 核对 MIT 与分片;读文档选型表,把 560B / 25B / 服务端约 256K 与「架构最高 1M」分开记;有 API 就先用真实 brief 试原型;自托管按官方多卡菜谱;采样按建议测一轮;用同一 brief 对比现用旗舰与 3.0-flash;对客链路工具权限最小化;对外文案别把 1M/256K 混用。
开源社区又多了一块「大容量、中等激活、冲着 Agent 干活」的拼图。能下权重、许可还算痛快,这点值得高兴;机房账单和线上窗的诚实数字,也要一起看完。brief 真能变成可点原型,我举双手;可要是有人把 8 卡菜谱说成笔记本福音、把 1M 说成你现在就能用的窗,这两盆冷水我还是要泼。
你已经在跑编码 Agent 的话,评论区说说:你更卡在上下文不够,还是卡在本机/机房根本跑不动大 MoE?
出处:@AntLingAGI(2026-10-14)、Hugging Face inclusionAI/Ling-3.1-flash(MIT)、Ant Ling 开发者文档 Models/Ling(服务窗约 256K / 架构最高 1M)。
往期 · 接着看
Google放量Gemini 4 Argon:入门价每百万输入2美元,Free档用不了
Step 5:600B 只激活 27B
Drex 1.5开源:9B可下载,自测58.08,24GB显卡能跑
工具会用还不够,进「AI商业实战」从项目练到接单。【长按开启 AI 实战交流】

https://t.zsxq.com/26ESo
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING