


编者摘要:TypeSafe AI 新出的 Jev 是不写长文本、只做打分和是非判断的 AI,能批量并行处理问题,价格很低。作者把它插到 RAG 检索流程里做了实测。
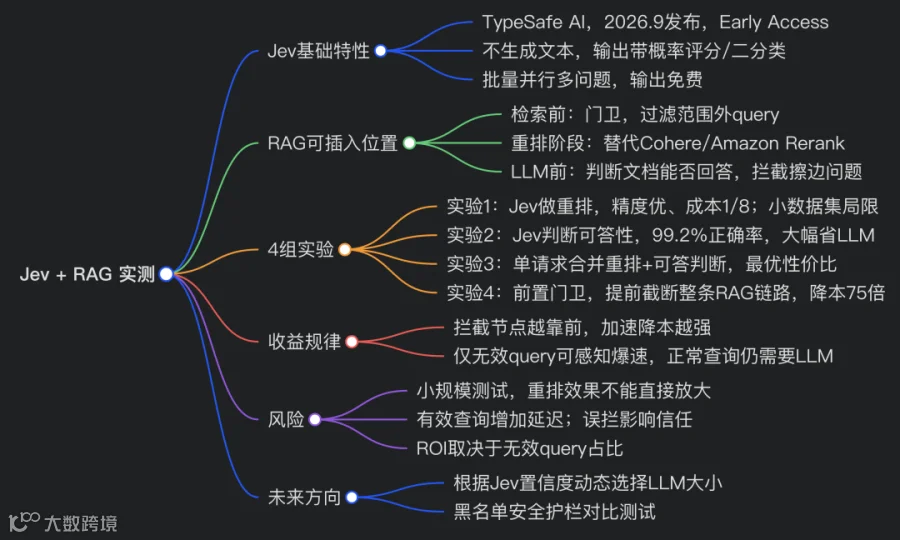
RAG 常规流程是用户提问→向量检索→重排→大模型出答案。测试了三处嵌入点:检索前当 “门卫”、替换重排器、大模型调用前判断能不能回答。
Jev 做重排时,打分精度不输商用重排工具,成本只要 Cohere 的 1/8,缺点是本次测试数据集偏小,结果不能直接套用到海量文档场景。它还能识别 “话题看着匹配,但缺关键信息” 的擦边问题,提前判定没法回答,直接跳过昂贵的大模型生成,节省大量耗时和费用。 最划算的用法是一次请求同时完成重排 + 可答判断。而放在最前面当门卫效果最强,遇到无关提问直接终止整条检索链路。
不过要注意:正常能回答的问题,会多一点延迟;一旦误把有效问题拦掉,用户体验会变差。这套方案值不值得上,要看业务里无效、擦边提问占比多少,无效问题越多,省钱提速效果越明显。

10 个关键问题问与答
-
Q:Jev 和普通 LLM 最大区别是什么? A:Jev不生成自然文本,专门做带概率的评分、二分类、多选;支持同一个 API 并行批量处理多个独立问题;输出免费,仅收输入 token 费。 -
Q:Jev 在 RAG 里最适合放哪个环节? A:收益排序:检索前门卫 > LLM 前可答性判断 > 重排替换;拦截越早,节省资源越多。 -
Q:为什么传统重排器很难识别 “擦边问题”? A:训练预设 query 一定存在答案,擅长相关性排序,但很难识别「话题匹配,但文档缺少回答所需关键信息」的场景。 -
Q:Jev 一次性同时做重排 + 可回答判断,原理是什么? A:对每个 chunk 并行发起相关性打分 + 整体文档集是否能回答问题两个任务,一次 API 拿到全部结果,省去多次模型调用。 -
Q:前置门卫写范围描述有什么坑? A:只写简短领域名词容易误拦;需要完整描述业务场景,不要让模型自行推断边界;对话追问类 query 建议跳过门卫。 -
Q:Jev 重排延迟比 Cohere 高,为什么还值得用? A:延迟小幅增加,但成本直接降到 1/8;适合成本敏感、对重排延迟不极致苛刻的场景。 -
Q:什么业务场景不适合上这套方案? A:几乎没有无效 / 擦边 query,全部流量都必须调用 LLM 生成;此时 Jev 只会增加额外延迟与少量成本,没有收益。 -
Q:实验 Recall 指标很好,为什么作者说重排结果不可信? A:测试库很小,向量检索阶段已经把包含答案的 chunk 放到 Top5,重排器没有机会区分难样本,无法证明海量文档场景性能。 -
Q:Jev 判断 “无法回答” 的盈亏平衡点怎么算? A:千次查询只要拦截 37 个无效 query,省下的 LLM 费用覆盖 Jev 调用成本;擦边问题越多,收益越高。 -
Q:这套架构会带来什么产品风险? A:误拦用户有效提问;阈值、prompt 设计错误会带来严重体验问题,上线前需要大量业务数据做阈值调优。
附录 《把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证》
原文作者:kikuziro(Qiita),TypeSafe AI Jev 模型在 RAG 链路多节点的实测,Jev 是不生成文本、只输出带概率的分类 / 打分 / 多选结果的专用模型(2026.9.15 发布,Early Access) Jev 核心规格:响应 70~500ms;输入 $0.042 / 百万 token,输出免费;支持单请求批量并行多问题;适合 yes/no、选项、分级评分类任务。
一、实验背景与核心思路
标准 RAG 链路:用户提问 → 向量检索 → 重排 → LLM 生成答案作者在链路3 个位置插入 Jev做替代 / 前置过滤:
-
检索前:门卫,拦截不在业务范围内的提问,直接跳过后续 Embedding、检索、重排、LLM -
重排阶段:替代 Cohere/Amazon 专用重排器,对检索返回 top20 chunk 打分排序 -
LLM 调用前:判断「现有文档片段能不能回答该问题」,无法回答就直接返回,跳过 LLM 生成
测试数据集
自建企业内部文档库:人事 / 财务 / 总务 / IT / 安全卫生 5 领域,40 文档、400 个 chunk; 问题分为三类:可回答 60 条、擦边 40 条(话题匹配但缺少关键答案)、完全无关 20 条; 向量检索固定取 Top20 chunk,人工 + Claude Opus5 双重校验标签。 测试基线:DynamoDB 向量检索、Amazon Titan Embedding,对比 Cohere Rerank3.5、Amazon Rerank1.0、Claude Haiku4.5。
二、4 组核心实验结果
实验 1:Jev 作为重排器,替代传统 Rerank
方案:一次 Jev 请求并行 20 条分级评分,对每个 chunk 打 0~3 相关度分 | 方法 | Recall@1|Recall@5|nDCG@5 | 延迟 | 1000 次查询成本 | | ---- | ---- | ---- | ---- | ---- | ---- | | 无重排 | 0.800|1.000|0.814|-|-| |Cohere Rerank3.5|0.950|1.000|0.884|198ms|$2.00| |Amazon Rerank1.0|0.850|0.967|0.819|337ms|$1.00| |Claude Haiku4.5|1.000|1.000|0.960|981ms|$2.73| |Jev|0.983|1.000|0.965|290ms|**$0.25**|
✅ Jev 排序指标最优,成本仅 Cohere 的 1/8; ⚠️ 局限:本次数据集偏小,向量检索阶段答案已经全部落在 Top5,重排器的价值没有真正考验出来,不能直接认定大规模场景下精度稳定。
实验 2:LLM 前置,Jev 判断「文档能不能回答问题」
输入:Cohere 重排后的 Top5 chunk,输出 yes/no 判定,用来拦截擦边问题,避免调用 LLM | 方法 | 判断正确率 | 擦边漏放率 | 可回答误拦率 | 额外延迟 | 1000 次查询额外成本 | | ---- | ---- | ---- | ---- | ---- | ---- | |Cohere 分数阈值 | 65.0%|25.0%|53.3%|0ms|$0| |Amazon Rerank 阈值 | 65.8%|95.0%|3.3%|0ms|$0| |Claude Haiku4.5|98.3%|2.5%|1.7%|584ms|$1.04| |Jev|99.2%|0.0%|1.7%|263ms|**$0.05**|
核心收益:一旦判定「无法回答」,直接砍掉昂贵、高延迟的 LLM 生成环节
-
无拦截:1459ms、$1.37 / 千次;Jev 拦截:263ms、$0.05 / 千次 -
盈亏线:每 1000 个查询只要拦住 37 个无效问题,Jev 的调用成本就能回本 -
缺点:能回答的正常查询,会额外增加 263ms 延迟;需要根据业务无效 query 占比权衡
推测传统重排器短板:训练数据默认「一定存在答案」,很难识别话题匹配但缺少关键信息的擦边问题。
实验 3:合并任务 — Jev 一次请求同时完成【重排 + 是否可回答判断】
利用 Jev 并行多问题能力,单次 API 同时做 chunk 相关度打分 + 整组文档是否可回答的 yes/no 判断
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0.960 | 99.2% |
|
$0.34 |
✅ 亮点:省去独立重排器调用,排序精度更高、判断精度不变;速度是方案②的 60%,成本仅 1/6。
实验 4:检索前「门卫」,Jev 提前过滤范围外提问
在 Embedding、向量检索之前,先用 Jev 判定用户 query 是否属于业务范围;范围外直接返回,跳过整条 RAG 链路
|
|
|
|
|---|---|---|
|
|
|
|
| Jev 前置门卫 |
|
$0.044 |
-
精度:100 个有效提问错拦 2 个;20 个无关 query 拦住 19 个;无意义乱输入全部识别为 unclear -
关键踩坑:只写简短关键词(人事 / 财务…)会大量误拦;必须完整描述业务场景,不要靠模型猜意图,白名单描述写得越详细,误判越少 -
补充:对话接续类提问(“详细说说”)容易被判定 unclear,建议对话上下文场景直接跳过门卫。
三、速度 & 降本总览
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
核心规律:拦截节点越靠前,降本加速效果越强;只有超纲 / 范围外 query 才能感受到 “爆速”,正常需要 LLM 生成的查询,依然要等待 LLM 输出,Jev 无法消除这部分延迟。
四、结论、风险与后续方向
✅ 结论
-
Jev 适合承接 RAG 里分类、打分、yes/no 判定、批量并行评估这类非生成任务,可以替代传统重排器、LLM 做事实可用性判断、前置范围过滤,显著降低 token 成本。 -
合并重排 + 可答性判断的单请求方案,是性价比最高的组合。 -
前置门卫是降本收益最大的方案,直接砍掉 Embedding、向量检索、重排、LLM 整套链路。
⚠️ 风险与局限
-
小数据集验证,重排效果不能直接外推到大规模知识库,上线前必须真实业务数据复测。 -
正常可回答的查询会增加少量延迟;误拦有效提问会严重伤害产品可信度,阈值 /prompt 设计必须谨慎。 -
投入产出高度依赖业务流量结构:只有无效、擦边问题占比足够高,才有经济价值。
🔭 后续验证方向
-
LLM 动态选型:Jev 筛选高纯度 chunk 后,可用更小模型替代大模型;基于 Jev 置信度,动态分流 Sonnet/Haiku,进一步优化成本。 -
安全护栏:拓展黑名单式内容过滤,对比 Bedrock Guardrails 的效果。