


背景
在模型选型与部署优化工作中,传统方案高度依赖真机压测:搭建环境、拉起服务、调试并行策略、运行Benchmark。整套流程一轮测试往往需要数天时间,并且要持续占用昂贵的物理集群资源。若需要对比不同硬件型号、并行配置的差异,所有操作只能重新执行,迭代效率很低。
针对这一行业瓶颈,昇腾推出仿真建模工具MindStudio-Modeling,一个全系统性能仿真与分析工具。无需真实NPU设备,即可预估模型在目标硬件上的执行表现,定位瓶颈,自动推荐最优部署配置。
概览
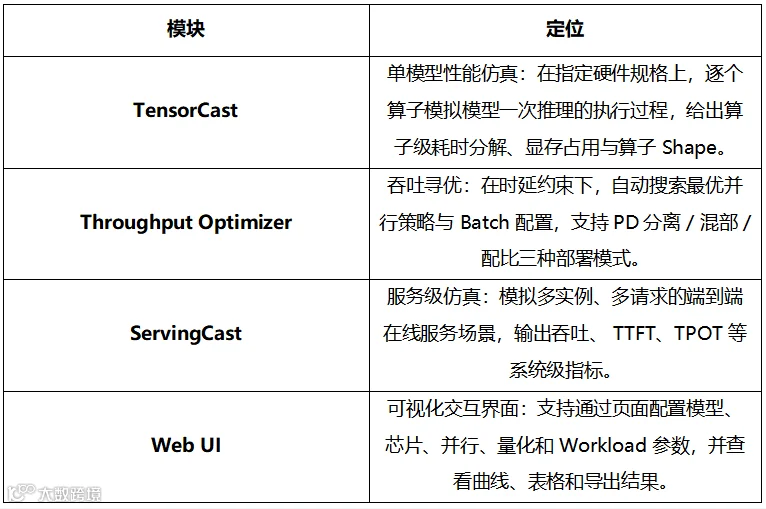
MindStudio-Modeling由多个功能模块协作,完成“从算子到服务”的全链路建模:
原理
MindStudio-Modeling的建模思路,本质是把“真机压测的隐性经验”固化成了可计算的性能模型:
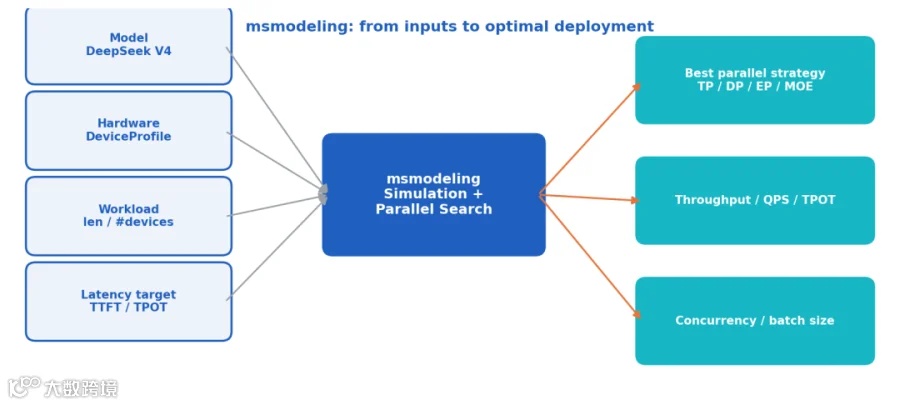
上图:msmodeling 以「模型 + 硬件 + 负载 + 时延目标」为输入,输出最优并行策略(TP/DP/EP/MpE)、吞吐 / QPS / TPOT、以及并发与 Batch Size 等部署指标。
硬件抽象(DeviceProfile):把一款NPU的算力(各精度 MMA / 向量算力)、显存容量与带宽、互联拓扑(卡间 / 节点间带宽、时延、通信效率)抽象成一个结构化Profile配置。更换硬件设备时,仅需替换对应硬件Profile配置,无需重新适配整套建模逻辑。
算子性能模型(PerformanceModel):
解析模型(AnalyticPerformanceModel)——基于 Roofline,按算子的计算量 / 访存量推算执行时间,无需任何实测数据,覆盖所有已支持模型;
实测模型(EmpiricalPerformanceModel)——查询算子实测Profiling数据库(由真实NPU profiling采集、经 op_mapping对齐后入库),命中即用实测数据、未命中回退解析模型,更贴近真机。当前仓库已内置面向Atlas 800 A3的算子实测库,校准数据覆盖DeepSeek / Qwen / GLM等模型。本文案例未接入Profiling数据库,采用的是解析模型。
并行与服务寻优(Throughput Optimizer):自动枚举TP / DP / EP / MOE-TP等并行策略组合,叠加量化、MTP、PD分离等特性,在给定时延约束(TTFT / TPOT)下,搜索出吞吐最优的部署方案。
一句话:给定「模型+硬件+负载+时延目标」,MindStudio-Modeling在一台普通CPU服务器上几分钟就能算出最优并行策略和对应吞吐。
案例:
DeepSeek-V4-Pro模型仿真建模
与系统自动吞吐寻优实践
基于MindStudio-Modeling工具,对DeepSeek-V4-Pro模型(https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro)开展一轮系统化吞吐性能寻优实验,全面评估其在昇腾950系列产品上的部署潜力。本案例以ATLAS_950_486T_96G和ATLAS_950_486T_144G两种设备为例,对比在486T算力下,显存分别为96G和144G两档设备的建模结果。
第一步:环境准备
按官方指南安装工具:详见
https://gitcode.com/Ascend/msmodeling/blob/master/docs/zh/install_guide/msmodeling_install_guide.md。
第二步:命令行寻优
将DeepSeek-V4-Pro部署在Atlas 950 SuperPod(64卡、64k输入、TPOT≤50ms)上寻优,翻译成一行命令:
python3 -m cli.inference.throughput_optimizer deepseek-ai/DeepSeek-V4-Pro \--compile \--quantize-linear-action MXFP4 \--quantize-non-expert-linear-action FP8 \--quantize-attention-action FP8 \--disagg --num-mtp-tokens 4 \--mtp-acceptance-rates 0.9 0.7 0.5 0.2 \--jobs 8 \--device ATLAS_950_486T_144G --num-devices 64 \--input-length 64000 --output-length 1024 \--tpot-limit 50 \--tp-sizes 1 2 4 8 16
各参数含义可参考文档:
https://gitcode.com/Ascend/msmodeling/blob/master/docs/zh/user_guide/msmodeling_tensor_cast_user_guide.md#41-%E6%96%87%E6%9C%AC%E7%94%9F%E6%88%90(量化配置和DeepSeek V4 模型真实量化类型一一对应):
想覆盖别的场景,只需把命令里的--device、--num-devices、--input-length、--tpot-limit 等进行替换即可,无需重搭环境、更无需物理设备。
第三步:结果分析
寻优结束后,Throughput Optimizer会直接在命令行打印输入配置、全局最优配置,以及Top-5并行策略明细。上面这条命令的真实输出如下:
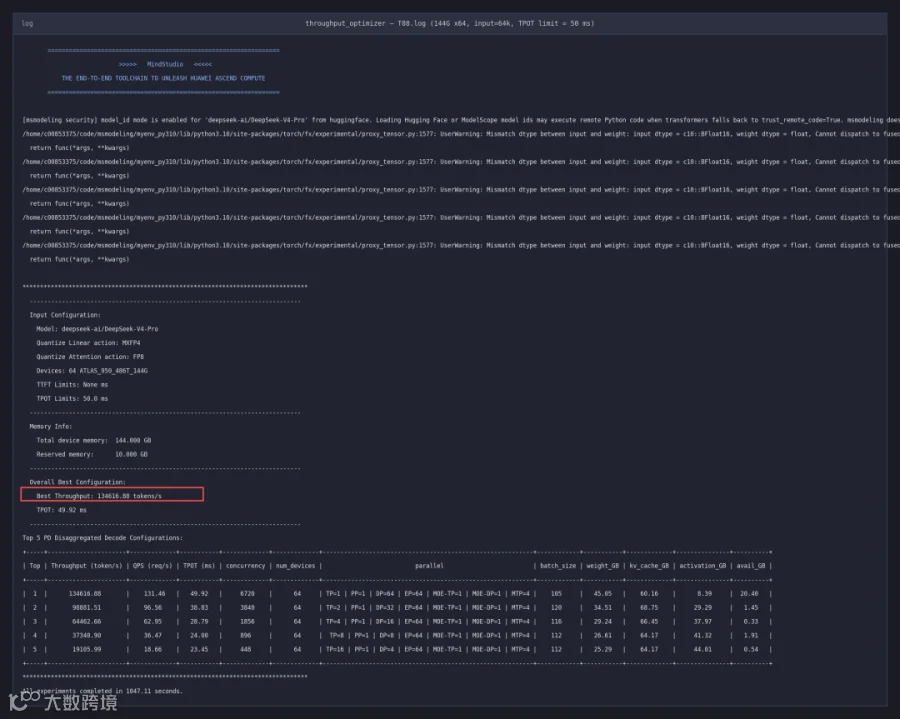
上图:Throughput Optimizer 对 DeepSeek-V4-Pro 的真实命令行输出——在 TPOT≤50ms 约束下,全局最优吞吐 134,617 token/s(策略为 TP=1 / DP=64 / EP=64),并列出 Top-5 策略的吞吐 / QPS / TPOT / 并发 / Batch Size;整个场景在 CPU 服务器上约 1047 秒完成。
从寻优结果里读出的四点优化发现
发现一:时延-吞吐的权衡可量化。 同一组硬件(96G × 64 卡、输入10k)下,仅改变TPOT约束,寻优给出的最优吞吐从约1.0 万一路涨到14万token/s——TPOT从10ms放宽到50ms,吞吐提升约14.5倍。
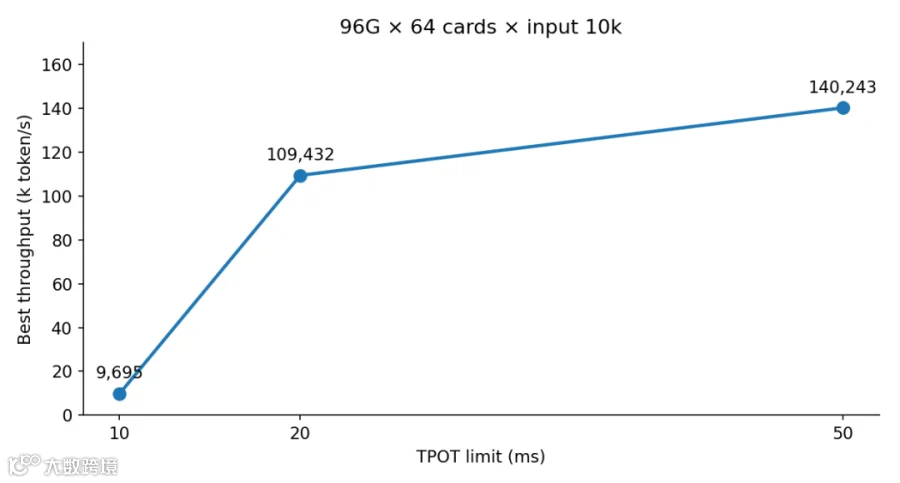
上图:同一硬件/ 负载下,TPOT=10 / 20 / 50ms 寻优的日志显示全局最优吞吐依次为9,695 / 109,432 / 140,243 token/s。
发现二:硬件选型有据可依。 两种型号片上内存带宽同为4.0 TB/s,差距主要在显存容量。短上下文(10k)下两边最优吞吐持平;拉长到64k / 128k后,144G能撑起更大并发,吞吐明显更高。

上图:64卡、TPOT≤50ms 下,96G与144G在不同输入长度的最优吞吐对比(数据来自真实仿真)。
发现三:并行策略自动收敛。 在多数Decode场景下,寻优器推荐TP=1+大DP/EP;但在更紧的TPOT约束下会改切更大TP(例如10k输入、TPOT≤10ms时最优为TP=4),省去了人工逐一试错TP切分的成本。
发现四:规模化对比零成本。 几十个“硬件 × 卡数 × 负载 × 时延”组合,全部在CPU上批量算完,单场景约18分钟。换成真机,这是数周、数台集群的开销。而且结果可复现、可追加——后续补充新场景只需追加用例重跑,自动并入汇总表,无需重新占用硬件。
小结
MindStudio-Modeling 把模型部署评估,从“必须有卡 + 真机压测 + 人工调参”,升级为“一行命令 + 仿真建模 + 自动寻优”。
对于昇腾开发者,性能评估不再卡在“有没有卡”上。从模型到结论,一行命令,几分钟出结果。
后续MindStudio-Modeling还会支持更多硬件配置、更多模型与服务化优化场景,敬请期待!
MindStudio-Modeling GitCode开源社区:
https://gitcode.com/Ascend/msmodeling
MindStudio-Modeling安装指南:
https://gitcode.com/Ascend/msmodeling/blob/master/docs/zh/install_guide/msmodeling_install_guide.md
扫描二维码,
加入MindStudio开源社区交流群

扫描二维码,
直达msModeling开源社区
