


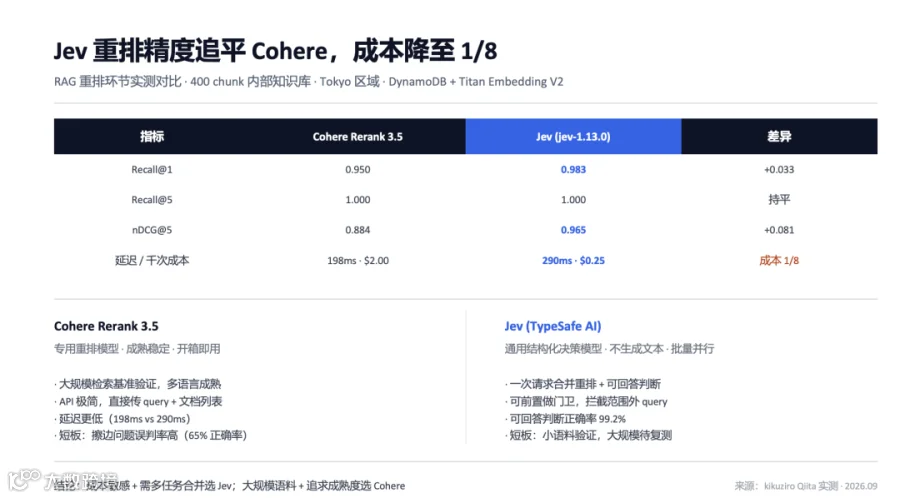
基础定位
- Cohere Rerank3.5
专用重排模型,原生设计就是做 query 与 chunk 相关性打分排序,开箱即用 Rerank 接口,主打检索排序任务,多语言能力成熟。 - Jev
通用结构化决策模型(非专门为重排训练),不生成文本;通过 Score分级评分,一次 API 并行批量对多个 chunk 打分。重排只是它的能力之一,还能同时做 yes/no 判断、范围分类。
实测指标(本次企业内部文档小数据集)
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
能力边界对比
✅ Cohere Rerank3.5 优势
- 成熟检索专用模型
,大量公开 BEIR、企业检索基准验证,大规模知识库可信度更强; -
原生 API 极简:直接传入 query + 文档列表,自动返回相关性分数,开发成本低; -
多语言、半结构化 JSON / 表格支持好,企业 RAG 落地案例多; -
分数是纯粹相关性分数,模型训练目标就是语义相关度。
❌ Cohere 短板
-
很难识别擦边问题:话题匹配、但是文档缺少关键答案,容易放行无效片段;训练隐含假设「文档一定包含答案」; - 单一任务
一次调用只能做重排,不能顺便做 “文档是否能回答问题” 判断; -
价格更高; -
分数值域没有统一校准,阈值要单独针对数据集调参。
✅ Jev 优势
- 一次请求做多件事
并行同时完成:chunk 相关性打分(重排)+ 是否可回答 yes/no 判断,省去额外 API 调用; - 成本极低
,输入 $0.042 / 百万 token,输出免费; -
概率高度可校准:返回的概率值可以直接作为阈值,用来过滤无效 chunk、拦截擦边 query; -
可以前置做 “门卫过滤”,在向量检索之前拦截无关提问,这是 Cohere 重排器做不了的; -
在本次测试里,排序指标 nDCG、Recall@1 优于 Cohere。
❌ Jev 短板
- 不是专门为重排训练
本次是小数据集测试,作者明确提示大规模真实知识库下重排性能不一定能维持,需要单独复测; -
延迟比 Cohere Rerank3.5 更高; -
需要自己定义评分标准(Score 档位说明),prompt 设计门槛更高,写得不好会掉精度; -
Early Access 阶段,生态、生产落地案例少,多语言检索能力缺少大规模验证; -
正常可回答 query 会增加额外延迟。
适用场景推荐
优先选 Cohere Rerank3.5
-
大规模公开 / 多语言知识库,看重成熟度,不想做复杂 prompt 工程; -
只需要单纯重排,不需要附加 “判断文档能不能回答”; -
对重排延迟要求极致敏感。
优先选 Jev
-
希望合并重排 + 可回答性判断,减少 API 调用; -
业务擦边、无效提问占比高,需要提前拦截无效请求,降低整体 LLM 成本; -
成本压力大,愿意做 prompt 和阈值调优; -
需要整套 RAG 前置门卫,过滤业务范围外提问。
结论
小数据集实测:Jev 排序精度更好、成本大幅更低,但延迟略高。 最大差异不是排序本身,而是任务复用:Cohere 只能做重排;Jev 可以在一次请求内,同时完成重排 + 判断文档能不能回答,还可以兼任前置门卫,实现整条 RAG 链路降本。 ⚠️ 关键风险:Jev 重排效果在大语料上未验证;Cohere 经过大量检索基准验证,稳定性更有保障。
Q&A 补充
Q1:Jev 能不能直接替换 Cohere 上线? A:小样本表现好,但不能直接替换,必须拿真实业务数据做 A/B 测试,重点测难样本。
Q2:Cohere 能不能做 “文档能不能回答问题” 的判断? A:可以靠分数阈值判断,但正确率很差(本次仅 65%),擦边问题大量漏放。
Q3:Jev 合并任务后收益是什么? A:不再需要单独调用 Cohere + 单独调用模型判断可答性;一次 Jev 调用搞定两件事,整体延迟和成本显著优于 “Cohere+Jev” 串联架构。