
发表平台:bioRxiv(预印本26-09-03)
研究领域:虚拟细胞 / 单细胞扰动预测 / 细胞群体建模 / 药物与细胞因子筛选
ML/DL方法:层次化集合编码器 + DeepSets + 条件DiT + JiT端点预测 + MSE-MMD联合重建 + BioNeMo训练系统
文章创新:
提出SCALE群体级扰动预测框架,以分别测量的对照和处理细胞群体为训练端点,无需真实的细胞前后配对,直接学习给定扰动及实验背景下的处理群体表达状态。
通过细胞内基因注意力与细胞间DeepSets聚合,构建兼顾单细胞信息和群体背景的潜在表示;结合条件输运与直接端点监督,使预测目标与实验实际能够提供的终点数据相匹配。
在遗传、药物、发育和免疫扰动任务中,联合评价表达误差、响应方向、差异基因及群体结构,并通过去除细胞系和平均处理效应,检验模型是否真正保留扰动特异性。
将预测用于细胞因子候选选择,并在三位供体的PBMC实验中验证不同候选的免疫激活与炎症分泌差异,展示虚拟细胞模型辅助实验设计的应用价值。
1
研究背景
虚拟细胞研究希望在实验之前预测基因、药物或细胞因子会如何改变细胞状态,为靶点研究、药物筛选和干预方案设计提供依据。然而,单细胞测序通常会破坏被测细胞,研究者实际获得的是一组对照细胞和另一组处理细胞,无法知道某个细胞在处理前后的真实对应关系。这意味着,实验直接提供的是两个细胞群体的状态,而不是每个细胞的变化轨迹。
不少扰动预测方法仍采用“一个对照细胞预测一个处理细胞”的训练方式,需要通过随机抽样或匹配算法构造细胞对。这样做能够提供较直接的监督信号,但训练目标也会受到配对规则影响。与此同时,如果模型主要优化平均表达,它可能把多种扰动压缩成一个相似的平均响应:整体误差看起来较小,真正用于区分靶点、响应基因和细胞亚状态的信息却被削弱。
因此,SCALE关注两个问题:缺少真实细胞配对时,能否直接学习有用的群体终点预测;采用群体建模后,能否继续保留不同扰动之间的特异性差异。前者涉及任务定义,后者涉及监督信号与评价标准。仅仅让两个群体的均值接近,并不足以说明模型已经学会了具体干预的生物学效应。
针对这一挑战,上海人工智能实验室联合上海大学、复旦大学等机构提出SCALE,即Scalable Conditional Atlas-Level Endpoint Transport。模型先把高维、稀疏的表达谱转换为集合感知的潜在表示,再根据扰动与实验背景预测处理后的群体端点。其重点是恢复响应方向、关键基因及部分群体差异,并检验这些信息能否帮助研究者选择具有不同实验结果的候选干预。
2
算法结构
1.层次化集合编码
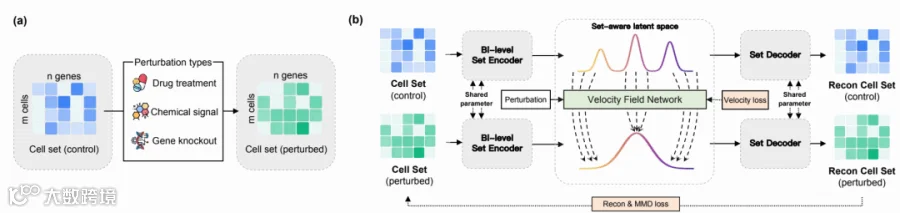
SCALE将一次实验中的细胞视为无序集合。编码器首先对每个细胞独立使用共享的基因编码模块,通过LLaMA风格或基础注意力建模细胞内部的基因关系,得到细胞级表示。这一阶段共享参数,但不同细胞之间尚不交换信息。
随后,DeepSets模块对细胞表示进行变换和平均聚合,形成不依赖细胞排列顺序的群体摘要,再将摘要反馈给每个细胞,细化其潜在表示。因此,一个细胞既保留自身的表达特征,也能够利用所在群体的背景。重新排列输入细胞时,群体摘要不变,细胞表示只随输入顺序相应排列,模型不会把无意义的细胞排序当作生物学信息。
对照和处理群体使用相同的编码器与解码器。潜在空间通过MSE与最大均值差异(MMD)联合训练:前者约束单细胞表达重建,后者比较重建群体与真实群体的分布。这里的重建是将一个细胞还原为自身表达,不需要把对照细胞与处理细胞配成真实的前后样本。MMD为群体结构提供额外约束,但有限维表示并不能保证保留所有可能的分布差异。
2.条件输运与端点监督

训练时,模型在对照和处理群体的潜在表示之间构造线性插值,抽取一个插值位置,并结合扰动、细胞背景和插值参数输入条件输运网络。最终配置采用受JiT启发的“x-pred/x-loss”:直接预测处理端点,并用处理端点的平方误差进行监督。相应的潜在表示再由解码器还原为处理群体的表达谱。
端点监督同时对齐了相对于对照的变化误差,其关系可以写为:

式中下标0和1分别表示对照和处理群体,帽号表示预测。对照潜在表示作为共同参照,从预测和真实处理端点中同时减去。因此,在这一坐标关系下,端点损失也衡量了变化量误差,无需再为此添加一个独立的变化量目标。它体现的是监督目标与对照背景的对齐,并不自动保证所有扰动信号都能被恢复。
需要区分,插值参数是训练工具,不是生物学时间;两个抽样集合中同一行的细胞也不是实验观测到的真实前后配对。论文没有通过这条插值路径重建分子事件发生的先后顺序。其最终输出是在给定对照集合和条件下的确定性群体预测。
3.扰动与实验背景的条件编码
SCALE根据数据类型分别编码条件信息,再把它们投影到统一宽度的条件token。PBMC和Replogle任务中的细胞类型、扰动身份、供体、细胞系及批次使用可学习的类别嵌入。Tahoe药物分支则结合2,048维分子指纹与连续浓度编码,并通过特征调制让剂量改变药物表示,保留结构相似性与剂量依赖信息。
发育任务使用连续的基因靶点特征表示,同时编码离散发育阶段与受精后小时数,再构建基因和时间的交互表示。这样,即使某个测试基因没有在训练中作为扰动出现,也能通过其特征进入条件网络,而不完全依赖该基因专属、已训练好的标签嵌入。
不同条件token通过可学习的种子注意力进行融合,再与插值位置编码共同注入每个输运模块。细胞维度不加入位置编码,从而保持集合建模所需的顺序等变性。这里采用的是可适配多类任务的统一框架,各实验仍具有各自的数据划分和条件设计。
4.训练先验校正与大规模计算
最终预测还包含先验变化量居中校正(prior-delta centering,PDC)。该步骤利用训练集估计的处理效应,对同一预测群体中的所有细胞施加相同的平移,使群体均值向训练支持的参考响应靠近,同时保留每个细胞相对群体均值的偏差。
若训练中存在相同背景与扰动的效应,优先使用该信息;否则依次参考其他背景中的同一扰动、整体训练效应或零变化。校正权重及回退规则在验证集上选择,再固定用于测试,测试响应不参与构建先验。因此,最终结果应结合潜在输运、解码和训练先验校正共同理解。
计算层面,作者将稀疏表达矩阵按实验条件存储为LMDB分片,独立提取匹配对照,并结合BioNeMo与批次感知采样组织训练。在论文所报告的系统比较中,SCALE-184M的迭代速率为1.9259次/秒,STATE-280M为0.1540次/秒,相差12.51倍;按处理细胞数归一化后,吞吐量分别为27,818.20和21,584.40个细胞/秒,相差1.29倍。由于两套采样方案每个epoch处理的细胞数不同,细胞吞吐量更适合比较实际工作量,这些结果也反映完整系统的差异。
3
实验评估
1.多数据集基准与评价指标
论文首先在Replogle-Nadig、PBMC细胞因子图谱和Tahoe-100M上进行七指标比较,并进一步扩展至sci-Plex药物、ZSCAPE发育和Kang IFN-β任务。主要指标包括表达误差MSE、MAE,扰动变化相关性PDCorr,差异基因重叠与精确度,以及表达变化排序和上下调方向一致性。
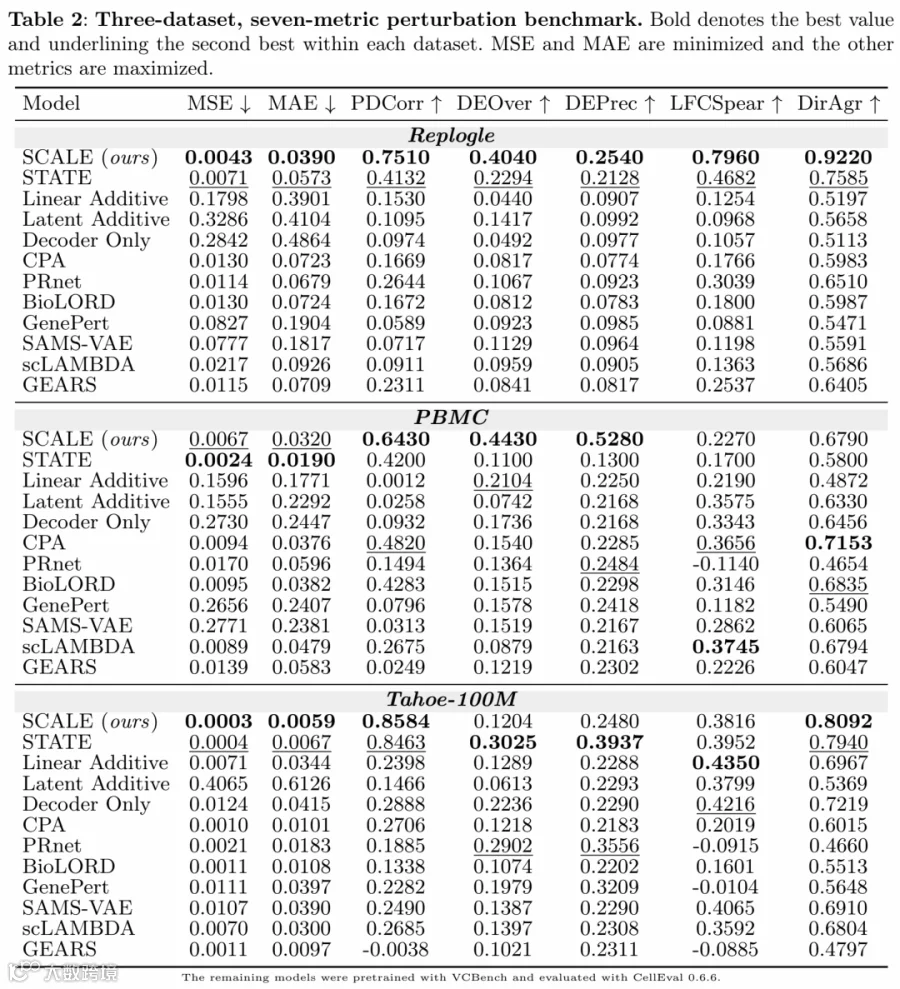
在Replogle上,SCALE在七项指标中均取得最高或最低误差结果,PDCorr为0.7510,STATE为0.4132;差异基因重叠为0.4040和0.2294。在PBMC上,SCALE的PDCorr、差异基因重叠和精确度领先,但STATE的MSE与MAE更低,其他方法在表达变化排序或方向指标上也有优势。在Tahoe-100M上,SCALE在MSE、MAE、PDCorr和方向一致性上领先,而STATE的差异基因重叠和精确度更高。
这些结果显示,SCALE的增益具有任务和指标依赖性。原论文表2结合了公开或本地复现的CellEval结果,以及经CellEval 0.6.6重新评价的VCBench预测;各行并非完全相同的预测流程与条件覆盖。因此,表中排名应结合各项任务和结果来源解读。
2.CRISPR扰动特异性
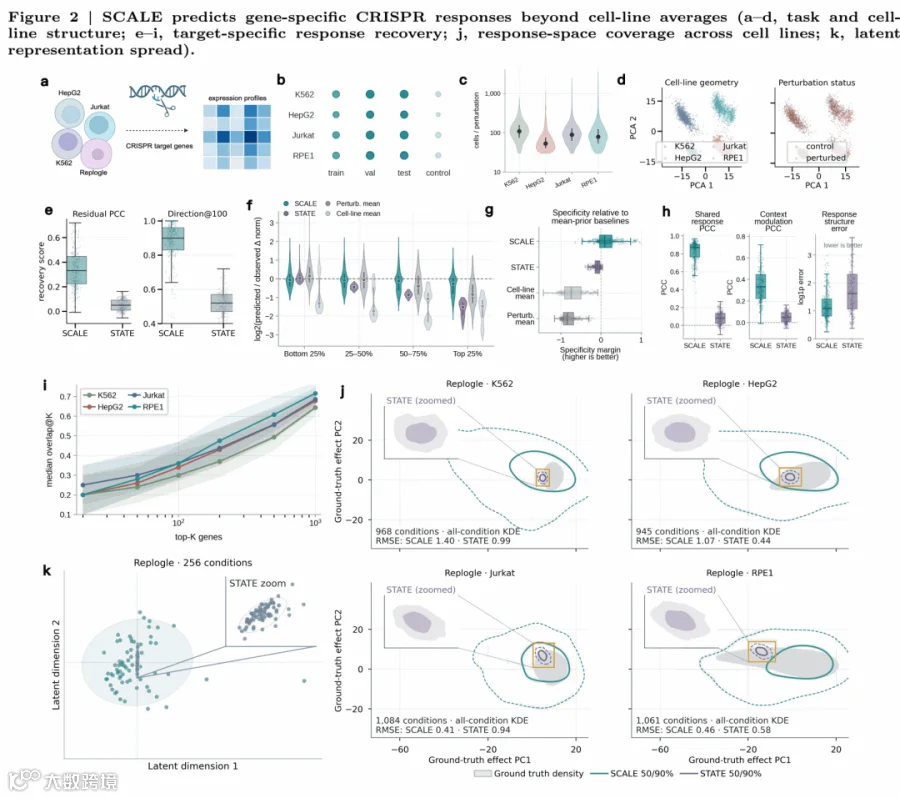
Replogle分析包含K562、HepG2、Jurkat和RPE1四种细胞系,共643,413个细胞、5,763个细胞系特异的扰动标签。这里不同细胞系之间的表达差异远大于单个CRISPR扰动效应,模型容易通过学习细胞系均值获得较低误差。
作者因此去除细胞系和平均处理效应,再比较剩余的靶点特异响应。SCALE的残差相关性中位数为0.33,STATE为0.05;前100个主要响应基因的方向准确度分别为0.88和0.57。在与细胞系均值、处理均值两类基线的比较中,SCALE的靶点特异评分中位数超过两者。
对至少在三种细胞系中测量的738个靶点,SCALE还较好恢复了跨细胞系共享响应及其背景特异偏移。共享响应相关性中位数为0.871,STATE为0.082;背景调制相关性分别为0.332和0.049。响应与潜在空间投影也呈现更分散的条件表示,与基因级分析共同支持模型保留了不同扰动之间的差异。低维投影本身仍只是描述性证据,不能单独证明完整群体分布已被恢复。
3.药物背景、组合与剂量泛化
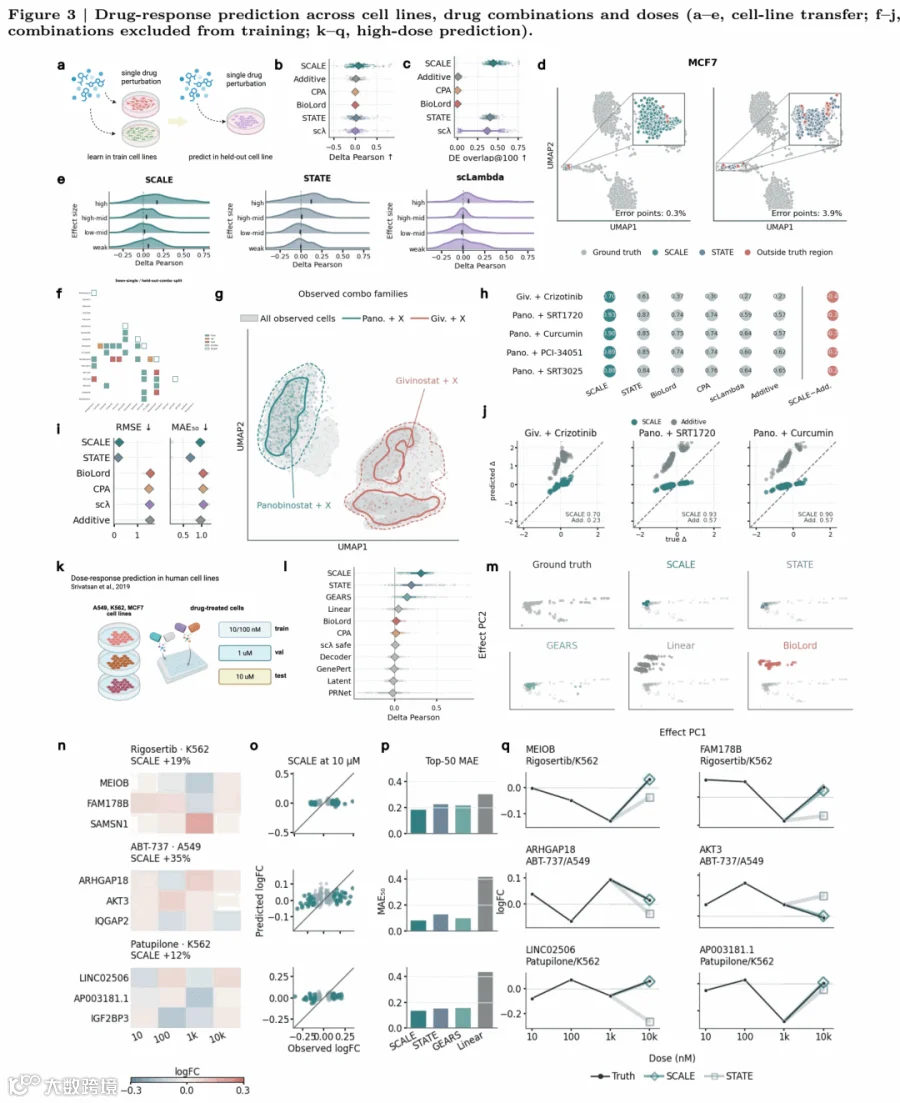
sci-Plex实验分别检验细胞背景变化、未见药物组合和高剂量外推。在留出细胞系的单药迁移中,SCALE在2,244个匹配条件上取得最高的Pearson变化相关性中位数,并具有最高的前100个差异基因重叠。在展示的MCF7响应投影中,落到观测响应区域外的预测占比为0.3%,STATE为3.9%。
对五组训练中未出现的药物配对,SCALE的Pearson变化相关性为0.70至0.93,均高于其他比较模型;相对两个单药效应直接相加的基线,增益为0.23至0.46。不过,STATE在其中四组的RMSE更低。这说明SCALE更好保留了组合响应的相对模式,而精确数值误差仍存在权衡,结果尚不能直接解释为药物协同效应。
剂量实验只用10和100 nM训练,以1 μM验证,在10 μM测试。测试剂量为最高训练剂量的100倍。SCALE取得最高的平均Pearson变化相关性;在561个匹配条件中,相比STATE,其前50个响应基因的平均绝对误差在94%的条件上更低,排序相关性在72%的条件上更高,方向准确度在68%的条件上更高。部分案例还显示模型能够跟随高剂量下的方向反转或向基线回归。
4.发育场景中的未见基因

ZSCAPE包含28类遗传扰动,覆盖受精后18、24、36、48和72小时的多个细胞类型。未见基因测试将该基因在全部阶段的扰动样本完全留出;另一组明确划分使用19个基因训练、3个验证、6个测试。模型见过相应发育阶段,但没有见过测试基因的扰动响应。
SCALE在未见基因划分中取得最低的归一化E-distance,并在六个测试基因的响应相关性、变化方向及差异基因精确度和召回率上呈现较强的综合表现。在724个相邻阶段变化比较中,其方向准确度较STATE总体提高10.5个百分点;低维响应区域外的预测占比为6.7%,STATE为29.4%。
与此同时,准确度与每个基因、细胞类型和阶段组合中的处理细胞数量密切相关,且不同阶段的性能呈非单调变化。这说明数据覆盖仍是重要约束。上述验证范围限于已测阶段和已观测细胞类型,不能外推为对缺失发育阶段的完整模拟。
5.免疫背景迁移与患者留出
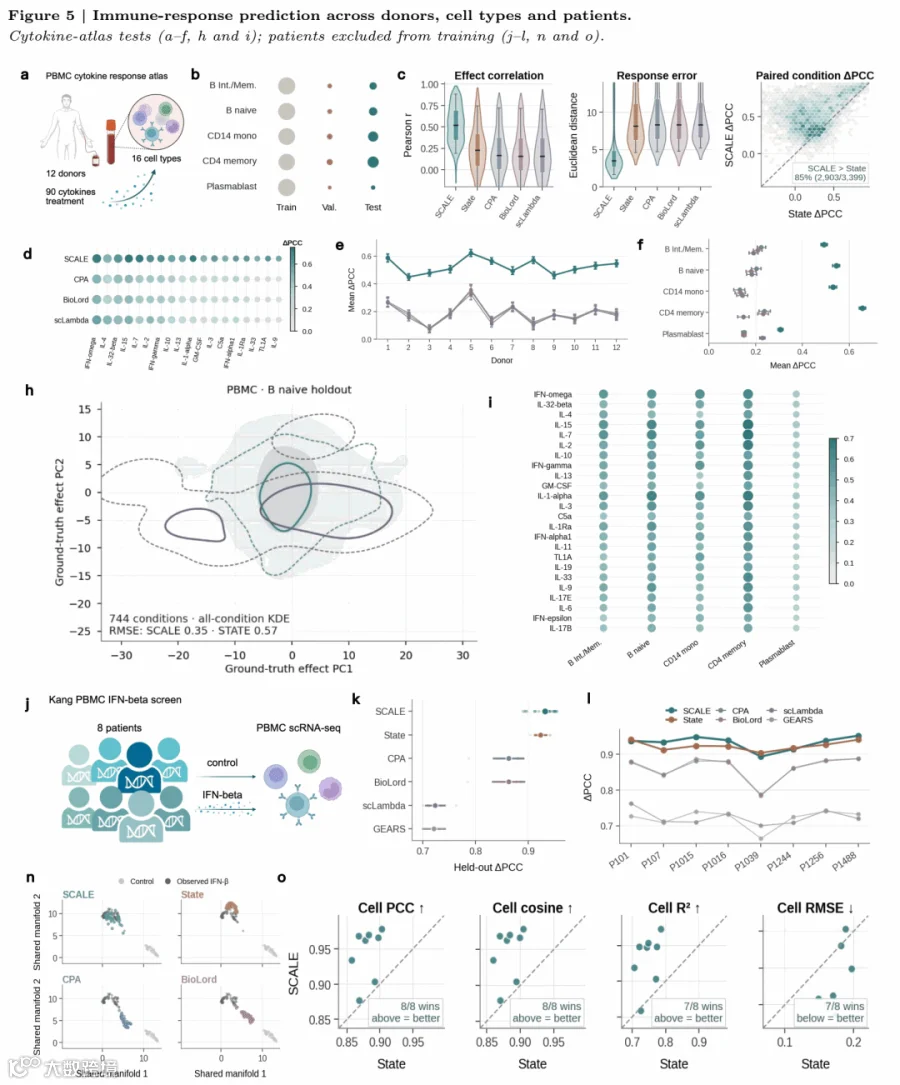
PBMC图谱覆盖12位供体、90种细胞因子和16类主要细胞。针对部分已测供体的条件补全,SCALE的平均Pearson变化相关性为0.525,在85%的配对条件上超过STATE。进一步留出五类细胞类型时,SCALE均取得最高平均相关性,但结果从CD4记忆T细胞的0.657到浆母细胞的0.306不等,表明迁移难度具有细胞类型依赖性。
真正的患者整体留出在独立的Kang IFN-β队列内进行。每次完全留出一位患者的对照和刺激样本测试,另一位验证,其余六位训练;它不属于PBMC图谱模型到Kang队列的直接迁移。在56组测试与验证患者组合中,SCALE平均变化相关性为0.932,STATE为0.924,并在八位患者中的六位取得更高患者均值。这一提升支持更一致的队列内预测,但幅度较小,也不能据此推导个体化临床干预能力。
6.从预测筛选到PBMC实验

作者进一步构建SCALE-CytoTI,将预测表达响应转换为两类计算表型:一类综合效应细胞激活、抗原呈递细胞启动和免疫抑制程序,描述预测抗肿瘤活性;另一类依据单核细胞与树突状细胞的炎症相关程序,描述预测炎症反应。候选选择在实验结果获得之前完成,覆盖两项评分高低组合形成的四个象限。
四个候选分别为IL-12、IL-15、IL-32β和IL-10。研究使用三位独立供体的PBMC,在PBS及四种细胞因子条件下处理48小时,每个供体与条件设置三次技术重复,共45个培养孔。技术重复合并后,以供体作为生物学重复,实际样本量为3。
流式实验显示,IL-12和IL-15更明显激活CD8 T细胞与NK细胞,IL-15的NK细胞CD69响应最强,而IL-32β与IL-10激活较弱。上清中的IL-6、TNF-α、CXCL8和CCL2呈现另一种排序:IL-32β分泌最强,其次为IL-15、IL-12和IL-10。因此,细胞因子可以具有较强炎症反应,却没有相应强度的效应细胞激活。
经过模型与实验各自的稳健尺度标准化,四个候选保持了预测的活性与炎症象限,以及相应的相对排序。该结果支持模型用于选择不同免疫响应类型的实验,而非证明预测分数与实验读数具有相同数值尺度。实验实际验证的是离体PBMC的CD69激活和四种分子分泌,没有直接验证肿瘤杀伤、完整抗原呈递程序或体内毒性。
7.消融与模型规模
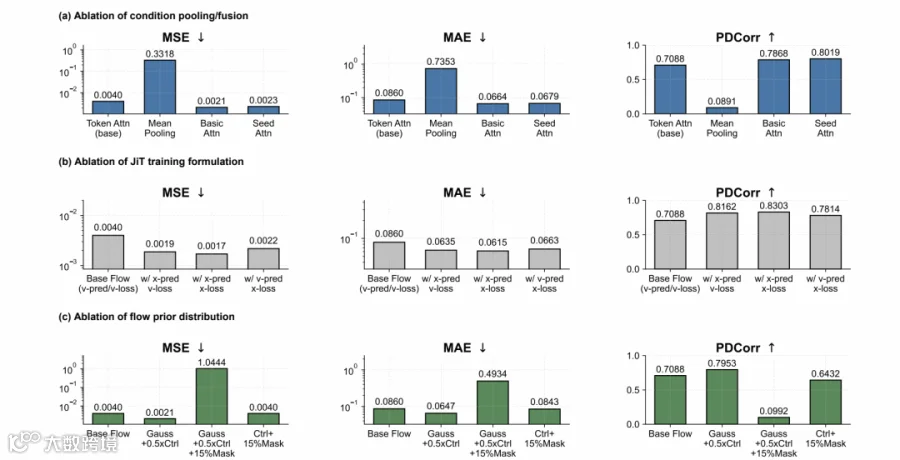
184M模型的消融显示,条件融合方式对扰动信号十分重要。把条件token直接平均后,PDCorr从基础配置的0.7088下降到0.0891;基础注意力和种子注意力分别达到0.7868和0.8019。在JiT参数化比较中,直接端点预测与端点损失组合表现最好,PDCorr为0.8303,高于基础流配置的0.7088。
起始分布也影响优化:高斯噪声与半权重对照表示混合后,PDCorr提高到0.7953,而进一步随机遮盖15%的潜在信息会明显损害性能。这些是分别改变设计项的消融,不能把各项增益简单相加。
模型扩容也没有自动带来更高准确度。在另一套完整h5ad文件的严格CellEval流程下,184M模型在Tahoe测试上的PDCorr为0.9526,280M为0.9502,差异基因指标也未显示扩容收益。这组结果属于独立的缩放比较,不能与主表2的数值直接混合;它说明在当前数据和训练设置下,条件设计与监督方式比单纯增加参数更关键。
4
总结与讨论
SCALE的主要贡献是让扰动预测的建模对象更接近实验实际观测到的信息:输入一个对照细胞群体,结合扰动和背景,预测处理后的群体端点。层次化集合编码保留细胞与群体两个层面的信息,条件端点监督把学习目标与测量终点对齐,训练先验校正进一步约束群体均值。基因级、方向性和残差分析则帮助区分真实的扰动预测增益与背景均值带来的表面准确度。
实验提示,群体级建模可以在缺少真实细胞配对的情况下保留有用的扰动特异性,并支持药物、发育和免疫场景中的部分泛化。细胞因子筛选与PBMC验证进一步把预测差异连接到可观测的功能读数,展示了模型用于实验优先级排序的价值。
其能力仍受训练支持、样本数量和条件覆盖限制。不同数据集及指标之间存在性能权衡,群体摘要的顺序不变性不等于对稀有细胞缺失或分布偏移天然稳健;有限维潜在空间和低维投影也不能保证完整分布恢复。缺少时间序列与谱系追踪时,端点预测无法揭示真实的细胞演化机制。三位供体、四种细胞因子的实验结论,同样应限定在本研究观测到的离体响应范围内。
基于文章中所使用的先进技术,包括深度学习,联川生物为您提供最前沿的生物分析解决方案。联川生物的专业团队将这些先进技术与丰富的经验相结合,为您提供高效、精准的服务。无论您的需求是基础研究还是临床诊断,我们都能够为您提供量身定制的解决方案。选择联川生物,让您的研究获得最新科技的支持,开创更广阔的科学道路。
参考文献:
Chen S, Yu L, Lin X, et al. *SCALE: Scalable Conditional Atlas-Level Endpoint Transport for virtual cell perturbation prediction*. bioRxiv. 2026. DOI: 10.64898/2026.03.17.712536