

智猩猩AI整理
论文二作投稿
DeepSeek 联合清华把 sandbox 的并发规模推到了数十万量级,另一个问题也随之浮现:
在单个 sandbox 内部,环境本身还能不能更“密”?
近期,来自 A*STAR、香港科技大学、新加坡国立大学、南洋理工大学等机构的港新研究团队提出 CUA-Sandbox,从系统层面给出了答案。
DeepSeek 主要在扩大 sandbox 的规模,这项工作则重新定义了单个 sandbox 内部的环境密度:环境隔离的单位不再是“整套运行时”,而是“可变状态”。
在 WebArena、VisualWebArena 和 OSWorld 上,任务成功率与 Docker 持平或更高,rollout 吞吐提升 2.22–6.20 倍,内存最多节省9.2 倍,存储最多节省504 倍。
01
Agentic RL 的瓶颈正在转向环境
Computer-use agent(CUA)通过与人相同的界面操作网页、应用和操作系统,任务范围已从网页扩展到桌面、移动端,乃至跨应用的长程工作流。
训练这类智能体越来越依赖强化学习:智能体需要在真实可执行的软件环境中反复交互,才能持续改进。
环境供给因此成为基础设施问题。
近期 DeepSeek 与清华大学发布的 DSec 系统,峰值并发超过38 万个 sandbox,日均创建约 300 万个,并与 RL 框架深度协同设计。
训练的瓶颈,正在从“模型会不会想”转向“环境供不供得起”。
不过,DSec 解决的主要是集群层面的调度与供给:如何同时拉起足够多的 sandbox。
在每个 sandbox 的内部,环境的组织方式基本沿用了传统做法。CUA-Sandbox 关注的正是这一层:同样的资源,能否承载更多相互独立的环境。
02
环境之间真正需要隔离的是什么?
每条 rollout 都会修改文件、会话、数据库或应用状态,因此并行轨迹需要相互独立的可变环境。
目前常见的做法,是为每个环境启动一整套容器、虚拟机或应用栈。
即便两条轨迹之间只差 agent 动作带来的少量状态,同样的软件也要重复初始化一次。
内存和生命周期开销随环境数量线性增长,固定资源预算下能收集的经验也随之受限。
已有工作从不同方向降低成本。
世界模型和代码生成环境提供了更廉价的经验,但保真度受限于它们所能刻画的动态;
容器和 microVM 保留了真实执行,近期工作也在压缩启动与 checkpoint 开销,但“一个环境对应一套初始化好的运行时”这一前提始终没有改变。
研究团队由此提出一个更底层的问题:一个独立的 computer-use 环境,是否必须拥有一套独立的执行运行时?
他们的观察是:应用代码和已初始化的服务可以在 rollout 之间共享,真正需要分叉的只有可变状态。

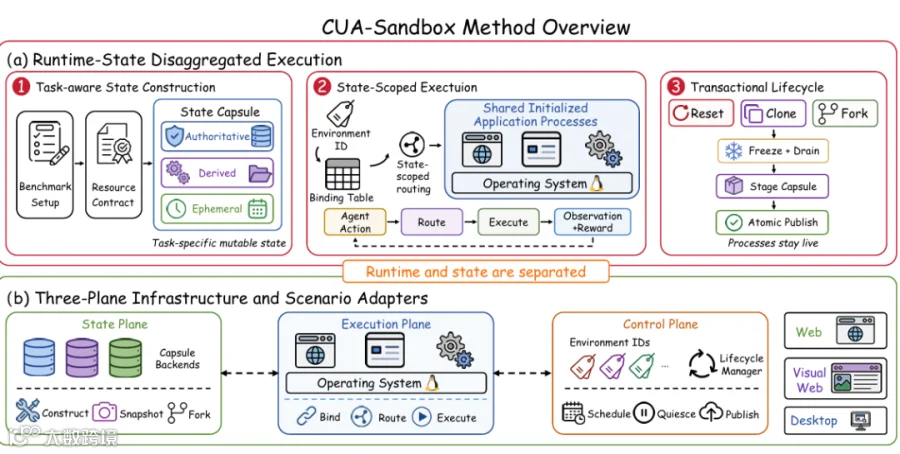
图1|(a) 传统 sandbox 为每个 rollout 分配完整的运行时与状态;(b) CUA-Sandbox 共享已初始化的进程,每个环境只持有私有的状态胶囊
03
状态即隔离单元
CUA-Sandbox 让多个逻辑环境共享同一套常驻的应用运行时,每个环境只持有自己的私有状态胶囊(state capsule)。系统分为三个层面:
执行平面:浏览器、Web 服务、数据库、桌面等运行时常驻并共享;
状态平面:每个逻辑环境对应一个状态胶囊,系统根据 environment ID 和 binding table 把动作路由到正确的胶囊,再产生 observation 与 reward;
控制平面:reset、snapshot、clone、fork 均以事务化方式执行。
(一)识别可变状态
方法的第一步,是找出决定后续 observation 和 reward 的可变资源。
研究团队为每类任务定义了一份资源契约(resource contract),由任务初始化流程、评测器依赖和应用状态规范共同构建,列出任务需要的数据库、用户文件、浏览器 profile、服务状态和界面资源,并为每种资源指定后端适配器与生命周期策略。
例如,两条 Shopping rollout 可以共用同一个应用服务器,同时各自访问独立的数据库和会话状态。
没有细粒度适配器的资源会退回到粗粒度的私有后端,以更大的私有边界换取正确性。
(二)构建状态胶囊
研究团队按照状态需要被保存的方式,把它分为三类:
权威状态(authoritative),如数据库和用户创建的文件:在不可变的基础数据之上,以写时复制(CoW)的私有增量形式保存;
派生状态(derived),如缓存和搜索索引:使用私有命名空间,在重建比复制更便宜时按需重建;
临时状态(ephemeral),如临时 IPC 端点和显示资源:在胶囊激活时重新创建。
三类状态的后端各不相同,但都属于同一个逻辑环境。
每个胶囊带有环境标识、代际编号(generation)和一份 manifest,记录各组件的版本与依赖。
只有当所有必需组件都准备就绪,manifest 才会提交,从而保证数据库分支、文件 overlay 和应用 profile 作为同一代状态一起推进。
(三)按状态执行
每个动作在执行时都携带环境标识,控制平面先解析该环境当前的绑定,并获取一个代际租约(generation lease)。
对权威资源而言,读操作看到的是“基础数据 + 本环境私有分支”的组合视图,写操作则只落在私有分支上。
派生服务和临时接口通过各环境独立的命名空间与端点选择。
该动作引发的请求、回调和后台任务都继承同一上下文,observation 和评测器读取的也是同一代状态。
研究团队强调,共享进程本身并不等于隔离。
运行时共享要求三个条件同时成立:
资源绑定完整、各环境的可写状态互不相交、一次操作始终处于同一代状态。
只有在每一项契约资源都完成绑定之后,执行上下文才会被标记为就绪。
绑定粒度则随应用而定:
Web 服务可以按请求选择私有状态,浏览器和桌面交互则需要会话级的 profile、配置、显示和消息总线端点。
无论哪种情况,agent 看到的仍是原始的交互接口。
(四)事务化的生命周期
reset、clone、fork 等操作都会改变环境的状态,如果在请求执行到一半时切换,就可能出现前后两代状态混用的情况。
为此,状态切换遵循 freeze → drain → stage → 原子发布的流程:
先冻结路由、拒绝新请求,再排空在途请求,然后准备好后继胶囊,最后把新的代际编号和 manifest 一起原子地发布。
代际租约保证仍在执行的工作只绑定在旧版本上,切换之后的过期请求会被拒绝。
(五)运行时复用
由于状态和运行时被解耦,已物化的胶囊数量不必等于同时活跃的执行上下文数量。
系统维护逻辑环境,按需分配物理执行槽位,不活跃的环境只以胶囊形式保留。
重新绑定一个槽位时,系统先让当前上下文静默,挂载目标胶囊,重建临时资源并更新路由,通过就绪检查后再交付使用。
槽位本身没有固定的环境身份,N 个逻辑环境因此可以复用 Q 个物理槽位。
对于无法安全共享的资源,系统退回私有后端,原有的软件接口和评测器保持不变。
04
实验:效果持平,
效率大幅提升
研究团队在 WebArena、VisualWebArena 和 OSWorld 上进行了三类实验:配对推理、匹配的智能体后训练,以及系统开销测量。
三个 benchmark 均使用原始的任务接口和官方评测器,对照组为各 benchmark 官方的 Docker 环境。
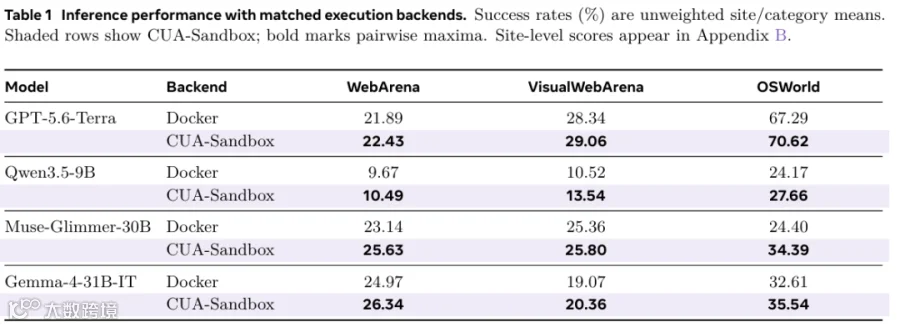
推理实验覆盖 GPT-5.6-Terra、Qwen3.5-9B、Muse-Glimmer-30B 和 Gemma-4-31B-IT 四个模型。
每一组对比都使用相同的模型、prompt、解码设置、交互步数上限、任务接口和评测器,使执行后端成为唯一的主要变量。
后训练实验以 Qwen3.8-27B 为教师模型、Qwen3.5-4B 为学生模型:
两种后端下分别独立收集教师的成功轨迹构建 SFT 数据,随后在与轨迹收集相同的后端上进行 on-policy RL。
(一)推理:更换执行后端不影响成功率
在 4 个模型、3 个 benchmark 共 12 组对比中,CUA-Sandbox 的成功率均不低于 Docker。例如,GPT-5.6-Terra 在 OSWorld 上从 67.29% 提升到 70.62%。
表1|相同执行配置下的推理成功率(%),阴影行为 CUA-Sandbox
(二)训练:SFT 与 RL 的收益得以保留
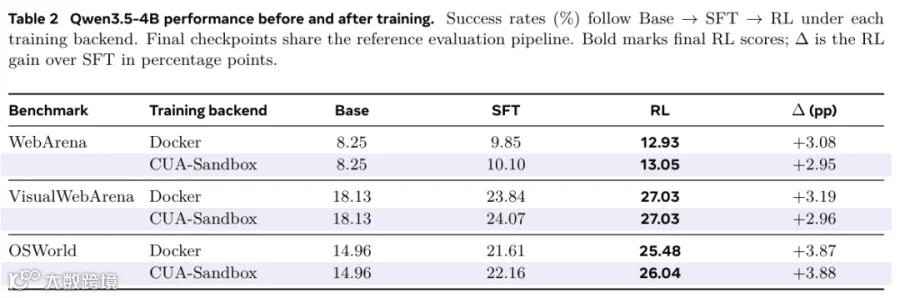
以 Qwen3.5-4B 依次进行 Base → SFT → RL 训练,两种后端带来的 RL 增益几乎一致(WebArena 上为 +3.08 与 +2.95 个百分点,OSWorld 上为 +3.87 与 +3.88 个百分点),CUA-Sandbox 的最终分数持平或略高。
资源的节省并没有以牺牲训练效果为代价。
表2|Qwen3.5-4B 训练前后的成功率(%),Δ 为 RL 相对 SFT 的提升
(三)效率:吞吐、内存与存储全面改善
在 8 个并发环境的设置下:
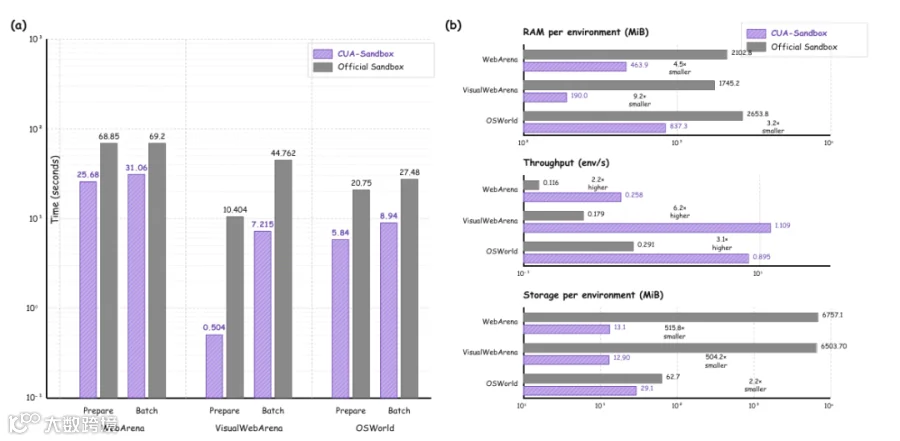
吞吐提升 2.22–6.20 倍:VisualWebArena 上,环境准备时间从 10.404 秒降至 0.504 秒,batch 耗时从 44.762 秒降至 7.215 秒,吞吐从 0.179 提升到 1.109 envs/s;
内存最多节省 9.2 倍:OSWorld 单环境内存从 2,653.8 MiB 降至 837.3 MiB;
存储最多节省 504 倍:Web 环境从 6,503.70 MiB 降至 12.90 MiB。
细分到具体站点和生命周期操作:
VisualWebArena Shopping 的 create 加速 15.17 倍,fork 加速 17.84 倍;
Reddit 的存储节省达 9,535 倍,GitLab 的内存节省达 51.2 倍。
表3|传统环境开销与 CUA-Sandbox 开销之比(×),越大越好

(四)消融实验:拆分各组件的贡献
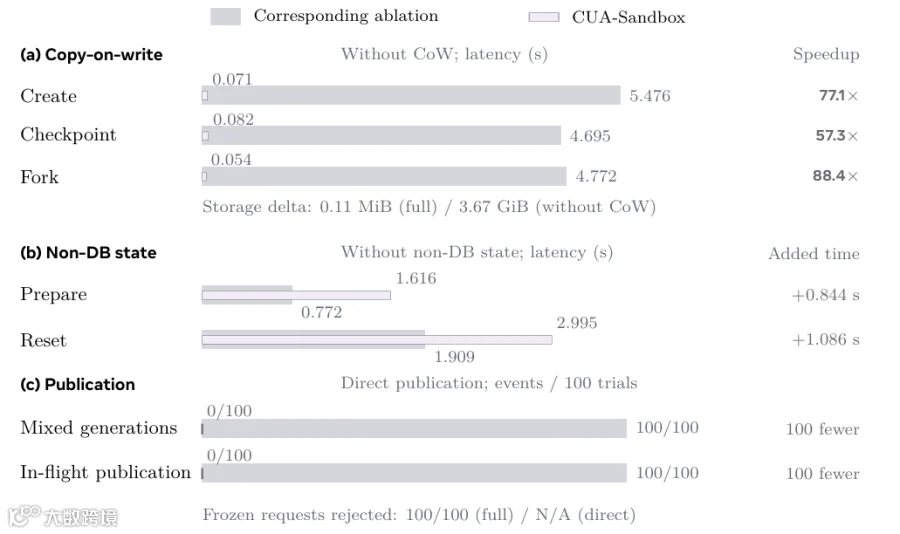
研究团队依次去掉写时复制、非数据库状态管理和事务化发布,分别考察它们对开销与正确性的影响:
写时复制:在 3.6 GB 的 Shopping 胶囊上,去掉 CoW 后,create 从 0.071 秒升至 5.476 秒(77.1 倍),checkpoint 从 0.082 秒升至 4.695 秒(57.3 倍),fork 从 0.054 秒升至 4.772 秒(88.4 倍),存储增量从 0.11 MiB 增至 3.67 GiB。CoW 省掉的主要是状态物化的开销。
非数据库状态管理:在 WebArena task 21 上,纳入非数据库状态使准备时间增加 0.844 秒、reset 增加 1.086 秒,4 个 HTTP 就绪探针均返回 200。这是覆盖数据库之外资源所需付出的代价。
事务化发布:在 100 次压力测试中,直接发布每一次都出现了混代执行和在途请求期间发布;完整协议下两类问题均为 0 次,并拒绝了路由冻结期间发出的全部 100 个请求。状态复用必须配合协调一致的状态切换。
附录中针对 8 个逻辑环境的进一步消融显示:
官方 Docker 的运行时内存为 15,560 MiB;仅引入 CoW、保持独立运行时,只降至 13,882 MiB;同时共享运行时,则降至 3,261 MiB。
可见内存节省主要来自运行时共享,而 CoW 主要降低存储和生命周期开销(可写存储从 52.99 GiB 降至 23.19 GiB)。
需要指出的是,上述主实验均在 8 个并发环境下测量。
附录补充了 4 个和 16 个并发环境的结果,趋势一致:
16 个并发环境下,WebArena 上 CUA-Sandbox 的吞吐为 0.324 envs/s,Docker 为 0.132;单环境内存为 436.1 MiB,Docker 为 2,082.6 MiB。
VisualWebArena 上的吞吐为 0.732 envs/s,Docker 为 0.208。并发从 4 增加到 16 时,CUA-Sandbox 的单环境内存基本保持稳定(WebArena 从 492.9 MiB 降至 436.1 MiB),共享运行时带来的节省没有随并发增长而被稀释。
论文还给出了一个资源模型来解释收益来源。
内存方面,节省来自两部分:一是共享运行时、避免重复初始化;二是部分轨迹不活跃时,只需保留胶囊而不必占用执行槽位。
存储方面,节省来自已初始化的可写状态,而非重复的只读镜像。
生命周期操作虽然省去了重建整套运行时,但仍需付出静默、状态准备、重新绑定和就绪检查的开销,延迟取决于具体后端和私有状态的大小。
05
当 fork 的成本趋近于复制一份状态
研究团队在结论中归纳了这一设计的取舍:写时复制避免了状态物化,非数据库适配器带来可测量但有限的额外开销,事务化发布则保证了生命周期的一致性。
方法的前提是资源契约和绑定覆盖足够完整;在无法确认可以安全共享的地方,系统保留私有后端,正确性优先。
更大规模的并发扫描、更多样的写入模式和更长的轨迹,是下一步需要刻画的共享边界。
CUA-Sandbox 的意义也不止于节省资源。
当 fork 一个环境的成本趋近于复制一份状态,一些过去因环境过重而难以落地的训练范式有了新的可能,例如从任意中间状态分叉多条轨迹、树搜索式 rollout,以及低成本的回退与重试。
集群级调度解决的是“环境跑不跑得起”,状态级隔离决定的是“环境能便宜到什么程度”。
两者结合,才构成 agentic RL 真正的 scaling 基础。
END
关注+星标,获取AI前沿进展与开源一线动态