


-
JEV-9B 把"快思考"和"慢思考"装进了同一套模型权重,它是什么、为什么这可能是智能体的正确形态; -
我们把它完整部署到了 H700 端侧设备(16GB 显存)上,全过程的坑和最终可行的配置都在这; -
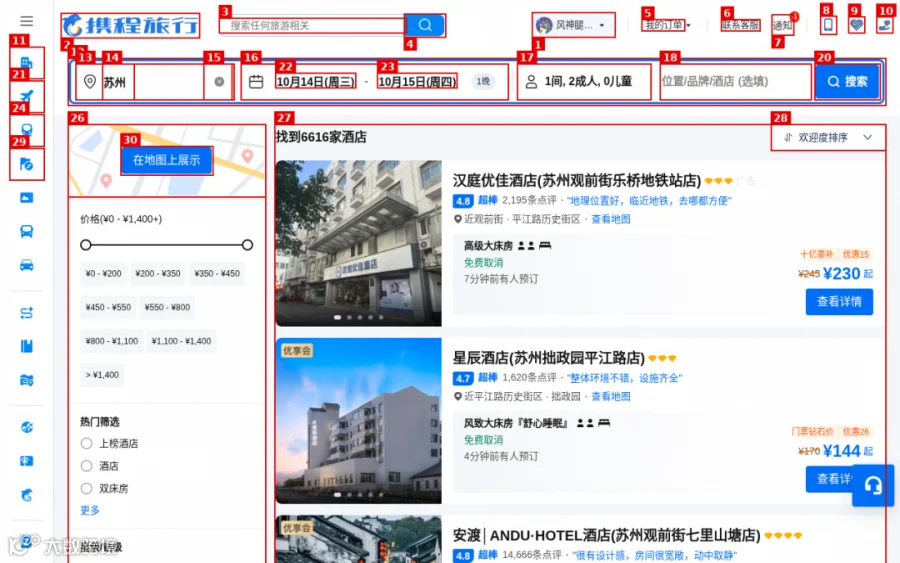
我们让它在真实互联网完成了一次完整复杂任务——B站搜攻略、地图查路线、携程比酒店、自动写成旅游攻略,三站全绿,全程录屏。
所有数据均为本机真实运行结果,附截图与录屏存证;官方自报数据与我们的实测数据分开标注。
〇、先说结论
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
一、JEV-9B 是什么:一个模型里的"快思考"和"慢思考"
1.1 先看它解决的问题
现在主流的 GUI 智能体(让 AI 操作软件界面)工作流程大概是这样:截图 → 大模型生成一大段推理链("我看到屏幕上有……我应该先……因为……")→ 输出动作 → 再截图 → 再思考。每一步都要生成几百上千个 token,慢、贵、而且容易一本正经地胡说八道。
这很像人:你不可能每按一个电梯按钮都写一篇小作文。人脑靠的是直觉反射+深思熟虑两套系统的配合——这就是卡尼曼《思考,快与慢》里的 System 1 和 System 2。
JEV-9B(AutoTrust AI 发布,Apache-2.0 开源)做的事情,就是把这两套系统装进同一套模型权重里。
1.2 它是怎么做到的

如图1,JEV-9B 的骨干是一个多模态的 Qwen3.5-9B(负责看图和语言理解)
在此之上有一个关键设计:
-
System 1(快思考):一个仅 40.2M 参数的 LoRA 适配器(约为骨干的 0.5%)外加一个 24 槽"决策头"。给它一张截图、一句任务描述、一组候选动作,它单次前向传播就直接输出每个候选动作的概率分布,比如 P(点击元素3)=0.94, P(任务完成)=0.02。不生成任何文字,没有推理链,官方数据在 B200 上单次决策约 0.2 秒。 -
System 2(慢思考):把 LoRA 摘掉,它就是那个原装的、逐 bit 一致的 Qwen3.5-9B,正常推理、写作、拆解任务。
两套系统按请求路由:需要快速判断"点哪个"时走 System 1,需要写攻略、解释异常、拆解复杂任务时切到 System 2。一份显存开销,两种思考模式——这正是端侧设备最需要的形态。
官方模型卡数据(自报、未经独立复现):System 1 蒸馏自闭源教师模型(声称 KL 散度 ≈0.019),训练约 3 GPU·小时(1 张 B200);图像判断基准 VL-RewardBench 74.3%;官方 computer use demo 在 60 个 3~7 步任务上 95% 成功率。
1.3 我们怎么测
测试平台是 H700 端侧设备(16GB 显存,30GB 内存)。我们设计了两级测试:
-
复现官方 demo:官方发布了一个"无头浏览器点网页"的演示,先小规模复现,验证模型本身能力; -
真实互联网挑战:让模型操作真实浏览器完成一个完整的复杂任务——"调研南京苏州旅游:B站搜攻略视频 → 地图查南京到苏州驾车路线 → 携程搜苏州酒店比价 → 汇总输出完整旅游攻略"。全程无人干预,模型每一步"看截图、选动作",动作执行与结果校验由确定性代码完成。
二、部署实录:把 14GB 模型塞进 H700 的 16GB 显存
这部分写给想复现的工程师。一句话:能跑,但每一 GB 都要算计。
2.1 关键选型
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2.2 三个真实的坑
坑一:驱动。所有支持 Qwen3.5 架构的 vLLM 版本都绑定 PyTorch 2.13 / CUDA 13,而设备原驱动只支持 CUDA 12.8,PyTorch 官方的 cu128 wheel 最高只到 torch 2.11——版本矩阵两头堵死,只能升级驱动到 580.178。好在 GPU 不承担显示输出,热切换内核模块成功,没重启。
坑二:显存差 0.89GB。FP8 权重加载后占 12.95GiB,加上运行时开销,KV cache 余量算出来是-0.89GiB——负数。最终生效的配置:
--gpu-memory-utilization 0.95# 显存预算顶格--cpu-offload-gb 2# 2GB 权重卸载到内存(关键)--kv-cache-dtype fp8# KV cache 也量化--max-model-len 4096# 上下文砍到 4K--max-num-seqs 1# 单并发
代价:每次启动约 34 分钟(含 CUDA graph 捕获),单并发,单步决策 210 秒。官方 0.2s/决策是 B200 的世界,端侧就是端侧的样子——但对"盯界面做判断"这类任务,这个延迟完全可用。
坑三:模型认识的网页和我们认识的不一样。这是实测部分的核心,下面展开。
部署脚本与冒烟测试脚本已固化:起服务后先打一发
/v1/decide冒烟——给一张带编号框的对话框截图,返回合法概率分布即通过。
三、实测:从演示环境到真实互联网
3.1 先交代清楚:测什么、怎么测、怎么算过
在进入过程之前,先把测试设计交代明白。
智能体每一步是怎么跑的?整个系统是一个五步闭环(见下图):给当前网页截图 → 给所有可交互元素画编号框 → JEV System 1 从候选动作中选出一步(输出概率)→ Playwright 真实执行点击/输入 → 校验器核对页面状态,不通过就打回重来。每一步的截图、动作、概率全部落盘,浏览器全程录屏。
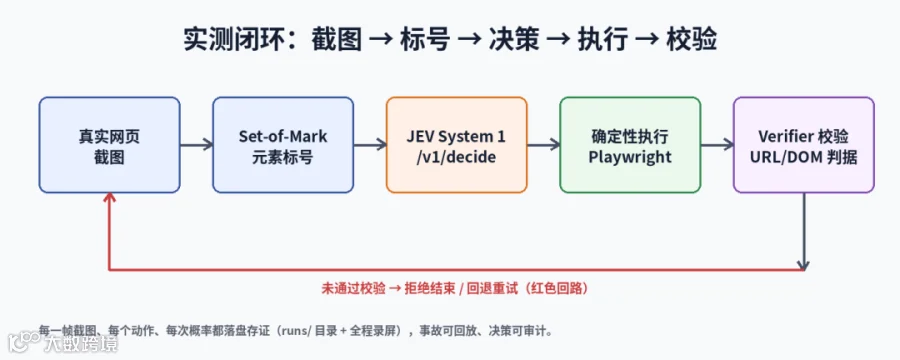
模型和工程各管什么?模型只做一件事:看截图、从候选里选动作——它不能执行任意代码、不能直接碰鼠标。动作执行、结果校验、安全边界全部由确定性代码负责。这是我们架构的底线,后面第四节还会回来谈它的安全含义。
测试任务分两级:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
② 地图:查询南京→苏州驾车路线 ③ 携程:搜索苏州酒店并浏览价格 ④ 汇总:基于采集信息生成完整旅游攻略 |
② 路线结果出现(里程/时长) ③ 进入酒店列表页(URL 校验) ④ 攻略生成且数据来源可溯 |
特别说明:第二关的全部素材(视频标题、路线里程、酒店价格)都必须来自页面真实采集,不允许模型"凭记忆"编造——攻略里每个数字都要能对应到某一步的截图。
3.2 第一关:复现官方 demo —— 模型的"条件反射"是真的
官方 demo 的机制:无头 Chromium 打开一个网页,给每个可点元素画上红色编号框(Set-of-Mark),截图给 JEV,让它从"点击元素1 / 点击元素2 / … / 任务完成"中选一个,循环直到任务完成。
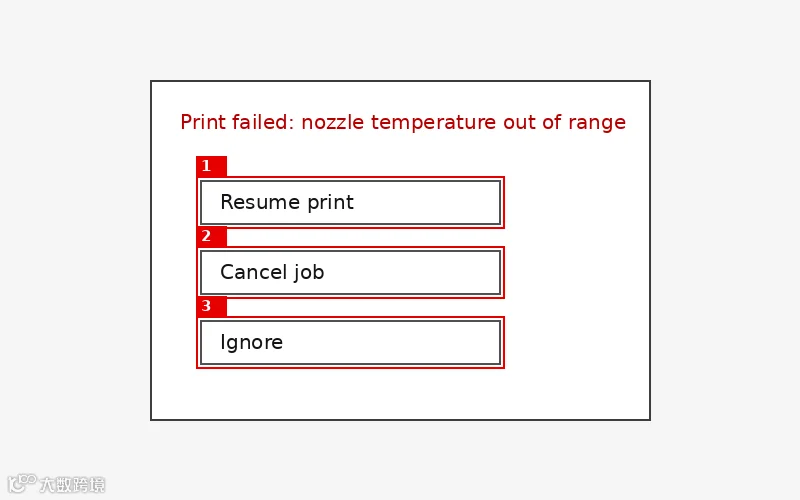
我们复现了官方 demo(购物/邮件/设置三类任务):
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
趋势与官方口径完全一致:带文字时接近满分,纯读图时能力腰斩。这组数字很重要——它说明 System 1 的强项是"在给定候选中做快速概率判断",而不是"裸眼看图自由发挥"。后面真实网站的所有工程设计,都是在为这个数字负责。
录屏:assets/video_toy_demo.mp4(买一件黄色 S 码 T 恤,7 步完成,含选颜色、选尺码——色块没有文字,纯靠看图选对的)。
3.3 第二关:真实互联网 —— 九次翻车与三次成功
然后我们把模型扔进了真实互联网。完整任务链:B站搜"南京苏州旅游攻略" → 地图查南京→苏州驾车路线 → 携程搜苏州酒店比价 → 汇总成攻略。
先上最终结果——最后一次完整运行的校验记录:
✅ bilibili | 8 步 | (系统校验: 目标已达成,浏览充分)✅ map | 9 步 | (系统校验: 目标已达成)✅ hotel | 5 步 | (系统校验: 目标已达成,浏览充分)
三段全程录屏:
但这个"三站全绿"是第九轮迭代才拿到的。真实互联网给这个模型上的课,比任何 benchmark 都生动:
第 1 课:登录墙。B站搜索页弹登录二维码,地图和携程也有登录引导。解法不是让模型学登录,而是人工扫码一次、浏览器存登录态、后续复用——就像给实习生先开好门禁卡。
第 2 课:弹窗和常驻面板是两种东西。我们的弹窗检测器最初把地图页面的常驻搜索面板误判成弹窗(它的 z-index 是 auto,JS 里 parseInt 出来是 NaN,而 NaN < 100 是 false,直接被当成高优先级弹窗),agent 围着它关了 14 次。一个 NaN 卡死整个智能体。
第 3 课:下拉建议框会"吃掉"点击。携程输入"苏州"后弹出建议下拉框,模型点击"搜索"按钮,点击事件被下拉框吞掉,页面没动。正确策略是"再点一次",或者先点建议项。
第 4 课:回车键有地域偏见。在路线面板里输入"南京"按回车,默认选中第一个建议——"南京大饭店"(一家北京的饭店,因为地图视野停在北京)。正确动作是点击建议列表里的"南京市"。模型不听劝按了回车,地图直接拒绝算路:"请选择正确的起点、途经点或终点"。

第 5 课:无文字图标是模型的盲区。地图的"路线"入口是个没有文字的图标按钮,元素提取出来标签就是"button",模型在它和搜索按钮之间反复横跳。当我们把标签改成语义化的"功能按钮 route-button"后,模型选择的置信度从 0.16 飙升到0.94——同一个模型,同一张图,只是标签变了。
最终成功的这一跑:
B站:滚动浏览搜索结果(已按最多播放排序)→ 点开 39 万播放的《江苏13地市完整版》攻略视频 → 采集标题与内容线索。
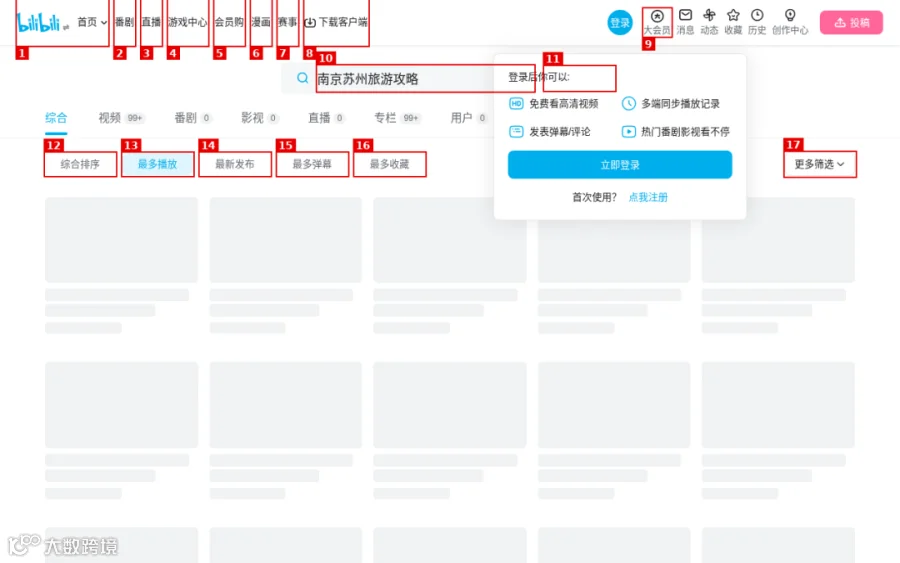
地图:点击路线图标(p=0.94)→ 起点输入"南京"(p=0.92)→ 终点输入"苏州"(p=0.75)→ 路线算出。拿到三套真实驾车方案:215.4 公里 / 2 小时 59 分(沪蓉高速)、224.2 公里 / 2 小时 56 分、229.3 公里 / 3 小时。
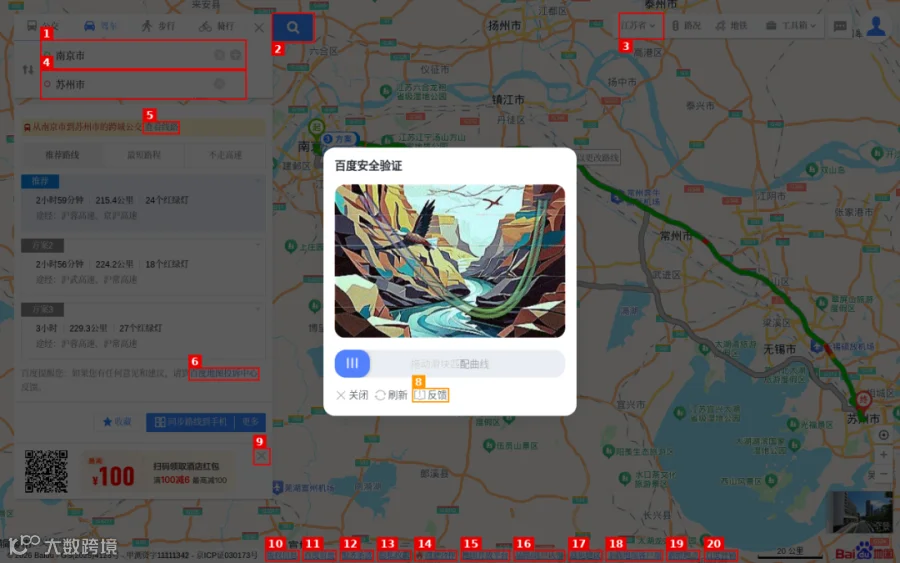
(截图里地图平台在最后一刻弹出了安全验证——路线数据已经拿到。如实记录:反爬是真实互联网的常态。)
携程(带登录态):目的地输入"苏州"(p=0.83)→ 点击搜索(p=0.84)→ 酒店列表加载成功,拿到真实房价:汉庭优佳观前街店 ¥230 起(4.8 分,2195 条点评)、星辰酒店拙政园平江路店 ¥144 起。
最后,System 2 出场:同一份模型权重摘掉 LoRA,把三个阶段采集的原始页面信息汇总成一份完整的南京苏州 3 天攻略——路线里程、酒店房价、美食推荐全部来自真实采集数据;缺失的部分(南京酒店、门票价格)明确标注"需进一步查询";它甚至主动识破了"茶颜悦色在苏州"的地域疑点,提示需要核实。
3.4 成功不是模型一个模块的功劳
必须诚实地说:三站全绿的那次运行,站在模型身后的是 3.1 节那套工程脚手架:
-
Verifier(校验器):模型说"任务完成"不算数,URL/DOM 判据通过才算。这套校验在运行中拦下了 4 次"虚假完成"; -
动作白名单与证据留存:模型只能从枚举的动作里选,每帧截图、每个动作、每次概率都落盘,全程录屏可回放; -
状态机提示:当前卡在哪一步、上一步错在哪,以文本注入的方式告诉模型。
模型负责"直觉",工程负责"正确"。
四、评测观点:快思考智能体的生产力与黑盒
4.1 为什么这件事重要
这次实测让我们对"System 1 + System 2 分层"这条路线有了实感:
它解决的是智能体的"决策成本"问题。传统 GUI 智能体每一步都要大模型生成完整推理链——慢、贵、token 消耗大。System 1 模式把"点哪个按钮"这类高频低风险的决策压缩到单次前向传播。官方数据 0.2 秒/次,我们 16GB 端侧设备上 2~10 秒/次,即使这样,也比"每步都写一篇小作文"便宜一个数量级。
这个价值在传统行业会被放大。制造业的 MES、物流的调度后台、医院的 HIS、财务的报销流程——这些场景的共同点是:界面固定、流程固定、动作空间枚举得完。这恰好是 System 1 的甜区:不需要它理解世界,只需要它在 20 个候选按钮里选对那个。配合确定性校验器兜底,一台 16GB 显存的端侧设备就能替代大量"人盯着屏幕点鼠标"的重复劳动,人与系统的交互次数可以指数级下降。
4.2 但它让系统更黑盒了,这是个真问题
但是我们必须指出这条路线的隐患,而且我们认为是结构性的:
第一,决策没有推理链。System 1 输出的是概率分布,不是理由。它点中"删除"按钮时,你无法从输出里知道它"为什么"。这次实测里所有可解释性都来自外部的日志和录屏,而不是模型本身。模型越"直觉化",审计越依赖外部工程。
第二,概率分布是可被操纵的攻击面。System 1 的输入是截图和候选文本——这些内容在真实互联网上是不可信的。一个恶意网页完全可以在页面里埋入精心设计的元素文字或视觉图案,把目标动作的概率"刷"上去(对视觉模型的对抗样本攻击是已被广泛验证的技术,而单次前向的决策头没有任何推理过程来"想一想这合不合理")。我们的实测里模型对标签文本极其敏感(改个标签,置信度 0.16→0.94)——这个敏感性用于工程是利器,用于攻击就是武器。
第三,权限必须与模型物理隔离。这也是我们在架构里坚持的原则:安全闸门(审批、金额上限、危险操作白名单)必须是独立于模型的确定性规则,模型的概率无论多高都只是"建议"。一旦让"看起来自信"的概率直接驱动真实世界的动作(支付、删除、控制物理设备),黑盒就不再是哲学问题,而是事故。
4.3 展望与下一步
JEV-9B 这样的分层决策模型未必是终态,但它指出的方向是清晰的:智能体的未来不是"一个更大的模型想更久",而是"快的归快,慢的归慢,确定性的归规则"。16GB 端侧设备能跑通三站点真实任务,意味着这套架构可以下沉到工厂、门店、医院的本地设备上——数据不出内网,决策秒级,出事有日志。
后续我们会基于 JEV 模型做更多 PoC 验证来展示它的能力:我们已经在推进一个"H700 端侧智能体操控工业软件与物理设备"的验证项目(从自然语言指令到驱动真实桌面软件完成切片、下发、监控的完整闭环),届时会继续以实测数据+录屏的方式和大家分享。欢迎关注。
附录:模型与参考链接
模型
-
JEV-9B 模型卡(Hugging Face):https://huggingface.co/autotrust/JEV-9B -
JEV-9B(ModelScope,国内可直连):https://www.modelscope.cn/models/autotrust/JEV-9B -
FP8 量化骨干 RedHatAI/Qwen3.5-9B-FP8-dynamic:https://huggingface.co/RedHatAI/Qwen3.5-9B-FP8-dynamic
部署
-
vLLM 官方 Qwen3.5-9B 部署配方(含显存估算):https://github.com/vllm-project/recipes/blob/main/models/Qwen/Qwen3.5-9B.yaml -
vLLM LoRA 适配器文档:https://docs.vllm.ai/en/stable/features/lora/
背景
-
卡尼曼《思考,快与慢》(System 1 / System 2 概念出处) -
Set-of-Mark Prompting(视觉标号方法):https://arxiv.org/abs/2310.11441
评测环境:H700 端侧设备(GPU 16GB 显存)/ vLLM 0.31.0 / Qwen3.5-9B-FP8-dynamic + JEV-9B vl adapter / Playwright + Chromium 无头浏览器。官方基准数据来自 JEV-9B 模型卡,为官方自报数据;本文所有"实测"数据均为本机真实运行结果,附完整录屏与截图存证。
注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。